
音声配信の録音1本から、AIで文字起こしをして、ブログ・メルマガ・X投稿・Instagram・60秒のショート動画の台本まで、5つの文章を作れます。コツは2つです。まず、文字起こしソフトに、話に出てくる言葉の一覧をヒントとして先に渡すこと。次に書き分けの頼み方で、「私の言葉のまま整えて」と役割を伝え、先に誤変換を直させ、話していないことは足さないと約束させるんですよね。
話すのは苦にならないのに、書く段になると手が止まりませんか? かといってAIに任せると、返ってくる文章が自分でなくなるのも気になるところです。
話し言葉の語尾「〜ちゃう」を口調の目印にして5つの文章で数えると、そのまま頼んだときは0回、頼み方を変えたら8回でした。自分の話し方を書いた口調メモも渡しましたが、1つずつ抜いて試すと、語尾を戻していたのは口調メモではありませんでした。そのまま頼んだ版は、話していない一文まで足していました。
音声配信の録音1本からAIで作れる5つの文章
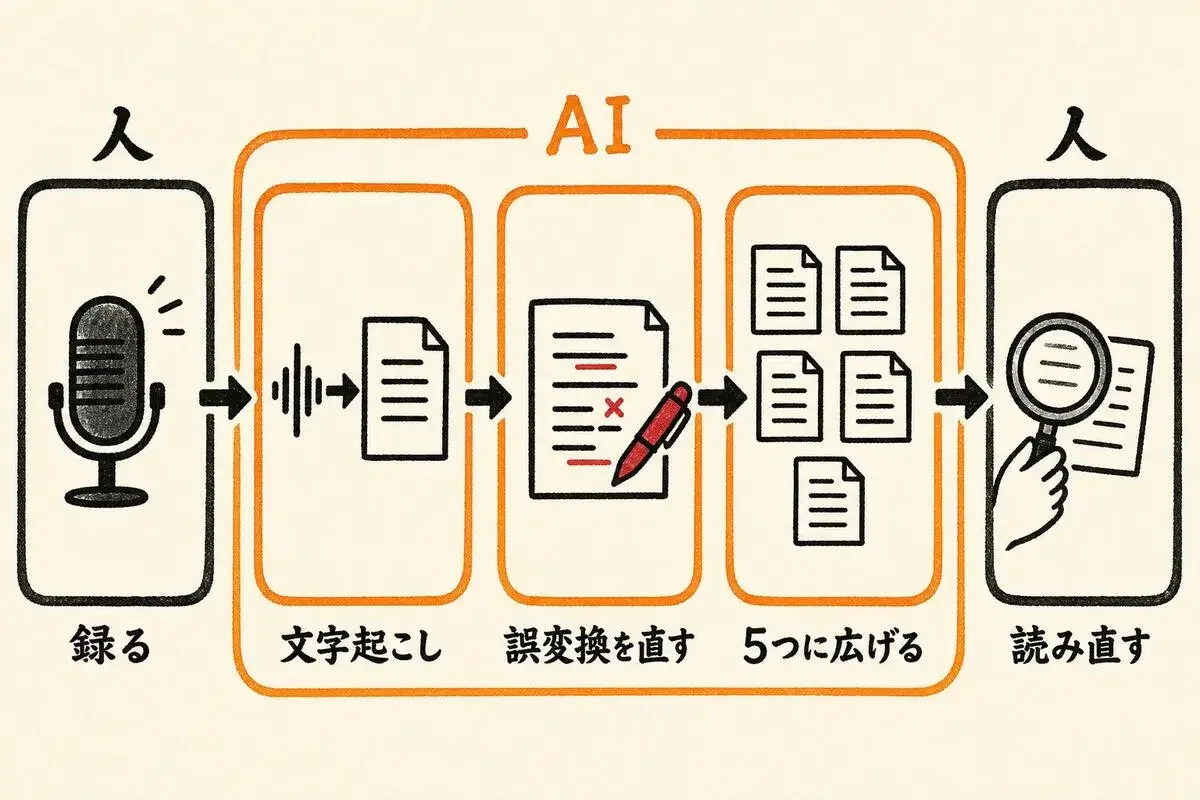
流れは、録る、文字起こし、誤変換を直す、各媒体の文章に広げる、公開前に読み直す、の5段階です。AIに任せられるのは真ん中の3つです。
5つの文章には、次の分量を指定しました。
試しに、書道教室の作品展を話題にした夜の雑談を、Macの読み上げ機能で1分42秒ほどの音声にしました。無料のソフトで文字起こしをして、5つの文章への書き分けはClaudeに頼んでいます。
いま、どの媒体に一番時間を取られていますか? その媒体の分量と決まりごとを1行で書いておくと、あとでプロンプトの「守ること」にそのまま入ります。
音声配信の文字起こしは、単語のヒントで読める形になる
無料の文字起こしソフトfaster-whisperの準備
OpenAIの音声認識モデルWhisperを、速く、少ないメモリで動かせるようにした無料のソフトがあります。名前はfaster-whisperで、今回もこれで文字起こししました。コードが苦手ならこの節は飛ばしても大丈夫で、手元に文字起こしがあれば、あとのプロンプトはそのまま使えます。
動かしたのは使い捨てのPython 3.12の環境で、GPUなし、CPU1コアとメモリ4GBです。インストールは26秒ほどで終わったんですけど、最初の文字起こしでエラーが出て止まりました。
TypeError: open() got an unexpected keyword argument 'metadata_errors'原因は、一緒に入る音声読み込み用のPyAVが19になり、faster-whisperが使っていた引数がなくなったことです。開発中の版では直っていますが、2026年10月10日時点の最新版1.2.1にはまだ入っていません。PyAVを19より前に固定します。
pip install faster-whisper "av<19"この形で入れるとPyAVは18.1.0になり、動きました。faster-whisperの新しい版でエラーが出なくなっていれば、av<19 は要りません。
音声は16kHz・モノラルのWAVにして渡しました。hint は次で説明する単語のヒントなので、音声ファイル名と一緒に書き換えてください。
import time
from faster_whisper import WhisperModel

# 話の種類と、出てくる言葉を短い文で。自分の配信に合わせて書き換える
hint = "書道教室の音声配信です。作品展、とめ、はね、はらい、半紙、硯、墨汁、墨をする、市民センターの二階。"

model = WhisperModel("small", device="cpu", compute_type="int8")
t1 = time.time()
segments, info = model.transcribe("episode.wav", language="ja", beam_size=5, initial_prompt=hint)
text = "\n".join(s.text for s in segments)
open("transcript.txt", "w", encoding="utf-8").write(text)
print(f"transcribe={time.time()-t1:.1f}s chars={len(text)}")
句読点と専門用語は、ヒントでどこまで直る?
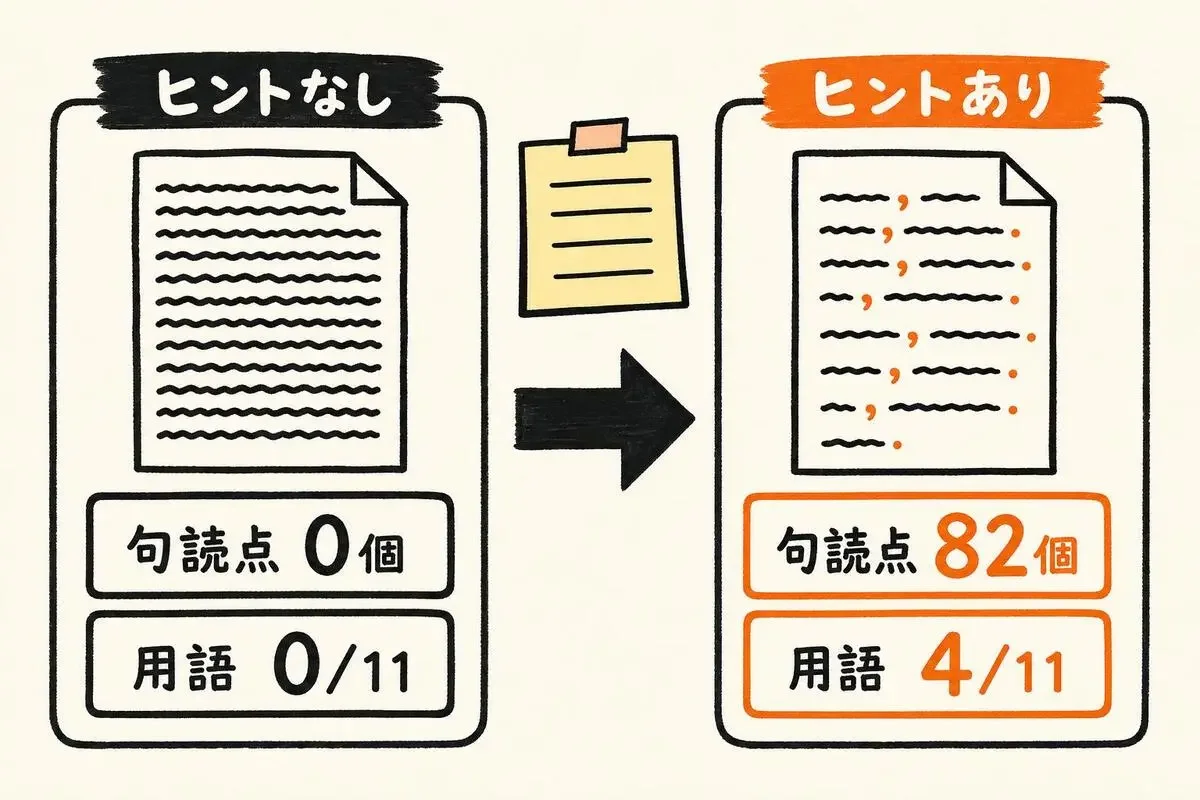
ヒントなしで102.4秒の音声を文字起こしすると、30秒ほどで526字。句読点が1つも入っていませんでした。書道の言葉もほぼ全滅で、作品展は「作品店」、半紙は「繁子」、硯は「筋」、墨汁は「僕中」、墨をすっては「隅を吸って」。市民センターまで「市民センパー」になっていました。
「こういう話で、こういう言葉が出ます」と、文字起こしの前にAIへ耳打ちしておける欄があり、faster-whisperでは initial_prompt と呼びます。ここに話の種類と出てくる言葉を句読点つきの短い文で渡して、もう一度文字起こししました。
句読点が入っただけで、ぐっと読める文章になりました。時間は8秒から10秒ほど延びますが、見合います。直ったのは作品展(4か所のうち2か所)と半紙、市民センターで、硯(「鈴」)、墨汁、墨をすって、二階(「2回」)は間違えたままです。
自分の話に出てくる、AIが知らなそうな言葉を書き出してみてください。教室やお店の名前、地名、道具の名前あたりが候補です。
そのまま頼むと、AIのブログは話し手の口調から離れる
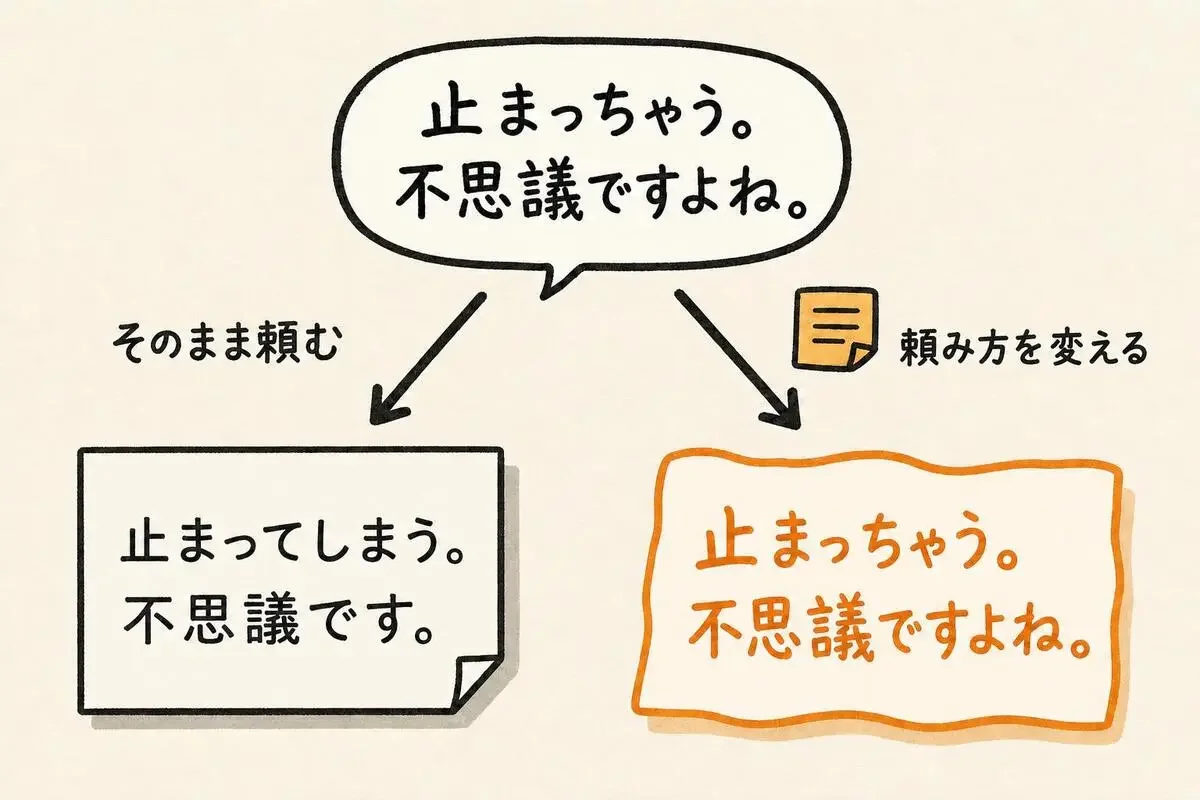
ヒントあり版の文字起こしを、何も添えずにClaudeへ渡しました。頼んだのは「以下は私の音声配信(雑談)の文字起こしです。これをもとに、ブログ記事、メルマガ、X(旧Twitter)の投稿、Instagramのキャプション、60秒のショート動画の台本を作ってください」という2文だけです。
返ってきた文章は、整っていて読みやすいんです。ただ、台本にあった「〜ちゃう」は0回になって「〜てしまう」が7回、呼びかけの「みなさん」も消え、ブログは「〜です。〜ます。」でそろっていました。
たとえば、台本の「しゃべるのは止まらないのに、書くのは止まっちゃう。不思議ですよね。」は、ブログでこうなっていました。
喋るのは止まらないのに、書くのは止まってしまう。不思議です。
意味は同じです。でも、話し手の調子が均されています。
いちばん引っかかったのは、台本のどこにもない解釈が一文足されていたことです。
止まれないまま書くから、とめもはねもはらいも同じ調子になってしまうんだと思います
もっともらしいぶん、読んだ人には話した本人の考えに見えます。
誤変換の「鈴」「僕中」「隅を吸って」は黙って正しく直され、「十分」は断りなく「10分ほど」と読まれていました。Instagramにはハッシュタグが9個と絵文字がつき、X投稿は2本出て、ショート動画の台本には話していない映像の指示まで入っていました。
どこを直したか分からない文章を、そのまま出せますか? 直してくれるのは助かるんですけど、見えないと公開前に確かめようがないんですよね。
自分の言葉のまま書き分けるAIプロンプト
コピペで使えるプロンプト全文
2回目は、役割の一文、手順、口調メモ、用語表、守ることを書いて頼みました。< >の中は試したときの中身なので、自分の話し方と言葉に書き換えてください。【要確認】はAIに残してもらう印なので、そのままにします。
あなたは、私の音声配信の文字起こしを、私の言葉のまま各媒体の文章に整える編集者です。以下の手順で進めてください。

## 手順
1. まず文字起こしの誤変換を直す。下の用語表にある言葉に置き換えられるものは置き換える。表になく、意味が通らない箇所は推測で埋めずに【要確認: 元の文字列】と残す
2. 直した文字起こしから、ブログ記事、メルマガ、X投稿、Instagramのキャプション、60秒のショート動画の台本を作る
3. 最後に、直した箇所と【要確認】の一覧を出す

## 口調メモ(私の話し方)
- 一人称は「<私>」。読者は「<みなさん>」と呼ぶ
- 語尾は「<〜なんですよね>」「<〜でした>」「<〜かしら、と思って>」をよく使う。「〜しましょう!」「〜が大切です」のような呼びかけ・教訓の締めは使わない
- 使わない言葉: <バズる、爆速、必見、徹底解説、〜の秘訣>
- 絵文字とハッシュタグは、Instagramだけ最大<3>つ
- 見出しを「〜とは?」で終えない

## 用語表(文字起こしで間違えやすい言葉)
<作品展 / とめ・はね・はらい / 半紙 / 硯(すずり) / 墨汁 / 墨をする / 市民センターの二階>

## 守ること
- 私が話していない事実(日付、場所、人数、エピソード、効果)を足さない。話していないことは書かない
- 文字起こしにある言い回し(例: <「急ぐと止まれない」「しゃべるのは止まらないのに、書くのは止まっちゃう」>)は、言い換えずにそのまま使う
- 媒体ごとの分量: ブログ800字前後、メルマガ400字前後(書き出しの1文はブログと変える)、X投稿は140字以内を1本、Instagramは200字前後、台本は60秒で読める分量(ナレーションのみ)

---
<ここに文字起こしを貼る>
プロンプトの部品を1つずつ抜いて試した
どれが効いたのか知りたくて、口調メモの節だけを抜いた版と、守ることから「言い回しをそのまま使う」の1行だけを抜いた版も、同じ文字起こしで試しました。数えたのは5つの文章の合計で、冒頭の直した文字起こしは除いています。
意外だったのは、口調メモを抜いても語尾がほとんど残ったことです。語尾を戻していたのは口調メモ以外の部分で、役割の一文、手順、用語表、守ることのどれかまでは切り分けていません。文字起こし自体に話し手の語尾が入っているので、書き換えさせないだけで残りやすいのかもしれないんですよね。言い回しの指定を抜くと「〜ちゃう」は5回に減ったので、この1行も少し効いていたようです。
さきほどの一文は、全部入りのブログでは台本と一字も違わずに返ってきました。
しゃべるのは止まらないのに、書くのは止まっちゃう。不思議ですよね。
言い回しの指定を抜いた版でも、文字起こしどおり「喋る」と漢字のまま、同じ文が残りました。
用語表の言葉は、どの版でも全部置き換えられました。話していない事実の追加も、3つの版とも見当たりません。
口調メモはあいさつと決まりごとの仕上げに
口調メモを抜くと、冒頭の「みなさん、こんばんは」のあいさつが消えて「みなさん」は0回になり、Instagramにはハッシュタグが1つも付きませんでした。口調メモが受け持っていたのは語尾そのものより、あいさつや決まりごとの仕上げだったようです。長くなくて大丈夫です。今回書いたのは主に次の4つでした。
- 一人称と聞き手の呼び方。「私」と「みなさん」だけで、誰から誰へ向いた文かが決まります
- よく使う語尾と、使わない締め。「〜しましょう!」のような教訓の終わり方を止めます
- 使わない言葉。自分が口にしない言葉を5つほど
- 絵文字とハッシュタグの上限。Instagramだけ最大3つにしました
音声配信のブログは、公開前にどこを直す?
頼み方を変えた出力にも、人の手が要る箇所は残ります。用語表になく意味が通らないところは、推測で埋めずに印つきで返ってきました。
ブログの本文には、この印がそのまま残っています。公開前に3か所とも直してください。「十分」はどちらの読みか、話した本人にしか決められません。
ブログの冒頭に残った配信の挨拶「みなさん、こんばんは」も、残すかどうか自分で決めます。
話していない内容が足されていないかも、必ず読みます。X投稿の文字数も数え直しておくと安心で、AIは121字と書いてきましたが、数えると125字でした。
音声配信にAIを使う前の注意
今回の音声は、Macの読み上げ機能で作った1分42秒ほどの合成音声です。肉声や生活音の入った録音、10分ほどの長い録音では試していません。faster-whisperはsmallモデル、書き分けはClaudeで動かしました。書き分けの4通りはどれも1回ずつの結果なので、同じ頼み方でも回によって数は揺れます。録音の質やモデルの大きさで、誤変換の出方も変わると考えています。
次の録音1本でやることは、間違えられそうな言葉と、口癖を3つほど並べたメモを作るだけです。用語表は配信のたびに書き足していくと、文字起こしのヒントと書き分けの用語表が1つの一覧として育ちます。
しゃべった1本が5つの文章になって、人が直すのは数か所。それなら書く時間の取り方も変わるかしら、と思っています。
Skill「音声配信を5媒体の記事に書き分ける」
この記事は、SkillとしてAIから使えます
Skillは、記事に書かれたやり方を、AIが代わりに進められるようにしたものです。無料の会員登録をして、Claude・ChatGPT などのAIをつなぐと使えます。
マイSkillに入れておくと
AimanaVoのSkillで、音声配信を記事化して
この記事のやり方で進めます
頼むときに「AimanaVoのSkillで」と添えると、AIが合うSkillを選びます。
- 3
- 0
地方で子ども向けの書道教室をひとりで営みながら、週3回の音声配信を続けています。話すのは好きでも、書く時間がなかなか取れない。そんな「話す人」の目線で、録った声をAIで文章やSNS投稿に広げるやり方を、自分の口調を残すコツと一緒に書いていきます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
 gen
- 2
- 0
-
AI脱社畜
- 5
- 0
-
 むみま
- 4
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 3
- 0
-
 ユーリ
- 2
- 0
-
 ククリ
- 5
- 0
-
 Jun
- 2
- 0
-
 にくたま
- 3
- 0
-
 早坂耕平
- 5
- 0
-
 Sumi
- 3
- 0
-
プロンプト画伯
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます