日本は文章に書いたルールをAIに渡し、GitHubはルールを動く仕組みとして公開した
きっかけはGitHubのブログだった
2026年11月19日、GitHubの公式ブログに、オープンソースの新プロジェクトを紹介する記事が公開された。その1つ「Replica」の説明には、「open-source design harness(オープンソースのデザインハーネス)」と明記されている。
デザインハーネスは、日本のデザイン界隈で議論が続いてきた言葉である。それが海外では、議論の言葉としてではなく、公開された道具の名前として登場した。同じ言葉が指すものが、日本と海外でどう違うのか。本稿では、その違いを「決め事の置き場所」という観点で整理する。
出典:The best things in open source are built together(GitHub Blog)
デザインハーネスとは何か
「ハーネス」はもともと馬具のことで、AIの文脈では「モデル本体以外のすべて」を指す。AIエージェント=AIモデル+ハーネス、という整理である。性能や判断の質は、モデルそのものよりも、その周囲に用意する文脈・ルール・道具・検証の仕組みに宿る、という考え方だ。
デザインハーネスは、そのデザイン版である。AIにデザインを任せるとき、使ってよい色や部品、判断の前提、できあがったものの確かめ方を、AIの外側にあらかじめ用意しておく仕組みを指す。
日本と海外で共有されているのはここまでである。分かれるのは、その「決め事」をどこに置き、どう運用するかだ。
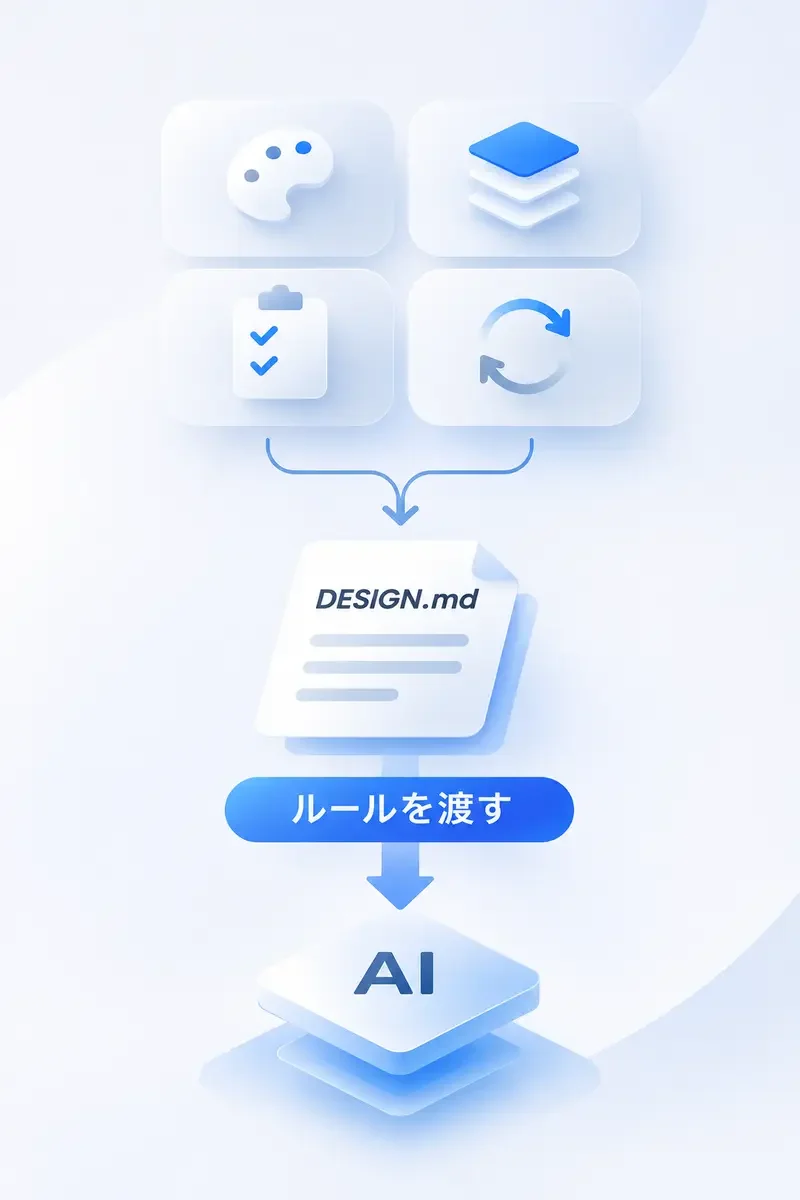
日本:決め事は、文章に書いて渡す
日本の議論の中心にあるのは、ルールを文章化してAIに渡す方法である。
代表的な整理では、デザインハーネスは「制約・文脈・検証・評価」の4つの層で構成される。使ってよい色やフォントを決める「制約」、画面の目的や背景を伝える「文脈」、生成物がルールに沿っているか確かめる「検証」、レビューで見つけたずれをルールへ書き戻す「評価」。この4層を、DESIGN.mdのようなmdファイルにまとめてAIへ渡すのが基本形である。
批判的な視点も早い段階からあった。言葉が独り歩きし、中身の検証より期待が先行することへの違和感を指摘する文章も公開されている。
実践も進んでいる。電話DXのIVRyでは、AIにデザインの文脈と制約を渡し、出力を評価して改善につなげる仕組みを、プロダクトから切り離した独立した実験場(Sandbox)として構築した。AIにはコンポーネントライブラリに準拠したコードを生成させ、準拠しているかを機械的にチェックする。興味深いのは、ルールを1つのDESIGN.mdに集約する方法は採用しなかった点である。知識は分けて置き、必要な分だけその都度参照させる方が準拠しやすい、という判断だった。日本の中でも、「文章に書く」ことは出発点であり、置き方や渡し方には工夫が重ねられている。
出典:プロトタイピングのその先へ。AI生成をプロダクト品質に繋げる「デザインハーネス」の実験(IVRy)
GitHub:決め事は、動く仕組みとして公開する
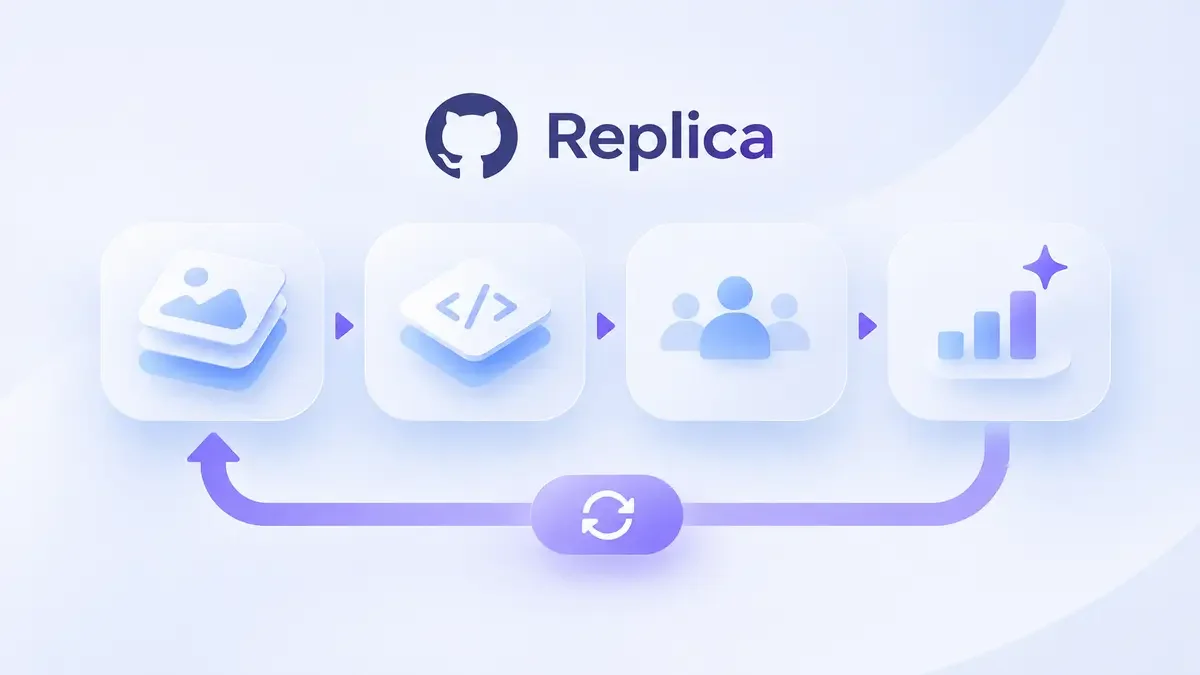
GitHubのReplicaは、決め事の置き場所が異なる。ReplicaはGitHubのデザインチームが社内で使っていた道具をオープンソースとして公開したもので、自分のデザインシステムの中でAIがプロトタイプを生成し、Copilotと並べて修正し、共有の場に公開してチームのコメントを受け、さらに直す、という流れ自体が道具になっている。
最大の違いは「評価」の扱いである。日本の4層でも評価は人が設計し、人がルールを書き換える層だった。Replicaでは、プロトタイプへのコメントや操作の蓄積から、システム側が「何が良いか」を学んでいく。強化学習と呼ばれる方法で、ルールを人が書くのではなく、フィードバックから良さの基準を育てる。評価の層が、文章から仕組みへ置き換わっている。
同じ記事でもう1つ紹介されたのが「ACCESSIBILITY.md」である。アクセシビリティの目標、対応環境、既知の制約、障壁の報告手順を、リポジトリのトップに置く1つのmdファイルにまとめ、公開し続ける運用だ。こちらは文章に書く方法そのものである。ただし置き場所が違う。READMEやSECURITY.mdと同じ並びで、リポジトリという「動く場所」の正式な部品として置かれ、読み込まれ、更新され続ける前提になっている。
つまり海外の事例でも、文章が否定されたわけではない。文章に書いたルールが、動く仕組みの中に部品として組み込まれている、という状態である。
自分の実験と並べてみる
この違いは、筆者の実験とも重なる。
自社(Baton)のブランドをAdobe Expressに登録した際、登録できたのはロゴ、色、フォント、ブランドボイスといった「仕様」の層までだった。判断の優先順位や、過去に却下した案とその理由を入れる欄はない。機械的に照合できる層は既存の道具が引き受けるが、判断の層には置き場所が用意されていない。
筆者自身、ブランドの判断軸をmdファイルに書き出し、それをもとにAIがデザインを提案する仕組みを検討している。問いは同じところにある。判断の層を、誰が、どこに置くのか。
Replicaの「フィードバックから良さを学ぶ」方法は、その判断の層に仕組みの側から近づく試みである。「これは良い」「これは違う」という判断が大量に集まれば、良さの基準は輪郭を持ち始める。一方で、その集積の最初には、必ず誰かの一回目の判断がある。学習は判断を増幅するが、判断の種は人の側から出てくる。
結論として、日本の「文章に書く」実践が古くなったわけではない。書いたルールはこれから、ACCESSIBILITY.mdのように、動く仕組みの中で読み込まれる部品になっていく。書き手の仕事も、完成させて渡すことから、読み込まれた先でどう効いたかを見て書き直し続けることへ、少しずつ移っていくと考えられる。
(了)
- 2
- 1
デザイン会社と事業会社でデザイナー(ブランドコミュニケーション)をやっています。 これまでWebプロダクトから広告まで幅広く携わってきました。 AIが登場して仕事の仕方も大きく変わる中で得た知見をこちらで少しずつシェアできたらと思います。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 cian
- 0
- 0
-
 棚島(たなしま)
- 4
- 0
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
 Baton Design
- 5
- 0
-
harinezumi
- 3
- 0
-
bokuwalily
- 0
- 0
-
 ふぃろ
- 2
- 0
-
ふぃろ
- 4
- 0
-
 ぴーこ | AI編集室
- 6
- 0
-
bokuwalily
- 1
- 0
-
 カイ@プロダクトマネージャー
- 2
- 0
-
 むみま
- 5
- 0
-
 寺ちゃん@AI・ライティング講師
- 3
- 0
-
寺ちゃん@AI・ライティング講師
- 3
- 0
-
bokuwalily
- 1
- 0
-
コードを読まないAIエンジニア
- 7
- 0
-
棚島(たなしま)
- 5
- 0
-
棚島(たなしま)
- 6
- 0
-
bokuwalily
- 0
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます