エージェントが同じ失敗を繰り返すたびに、プロンプトへ1行足して直していませんか? Google Researchが公開したHarness2(論文での表記はHarness²)は、その直しをエージェント側に任せる仕組みです。直す対象は、指示文、守らせるルール、メモ、ツールの説明、補助スクリプトといった、モデルの周りにある設定一式(ハーネス)です。失敗した実行を手がかりに書き換え、同じタスクで効いたかを確かめます。会計の台帳を集計する認証なしのデモを数秒で動かし、集計の1行が書き換わる様子と、本番のベンチを回すときの壁、自分のCLAUDE.mdに持ち帰れる書き方までまとめました。
Harness2とは、エージェントの設定を失敗から直す仕組み
エージェントの出来は、モデルの性能だけでは決まりません。同じモデルでも、渡す指示文、守らせるルール、覚えておくメモ、ツールの使い方の説明、補助スクリプトが変われば結果が変わります。モデルの周りにあるこの設定一式を、ハーネスと呼びます。Harness2が書き換えるのはモデルではなく、このハーネスのほうです。
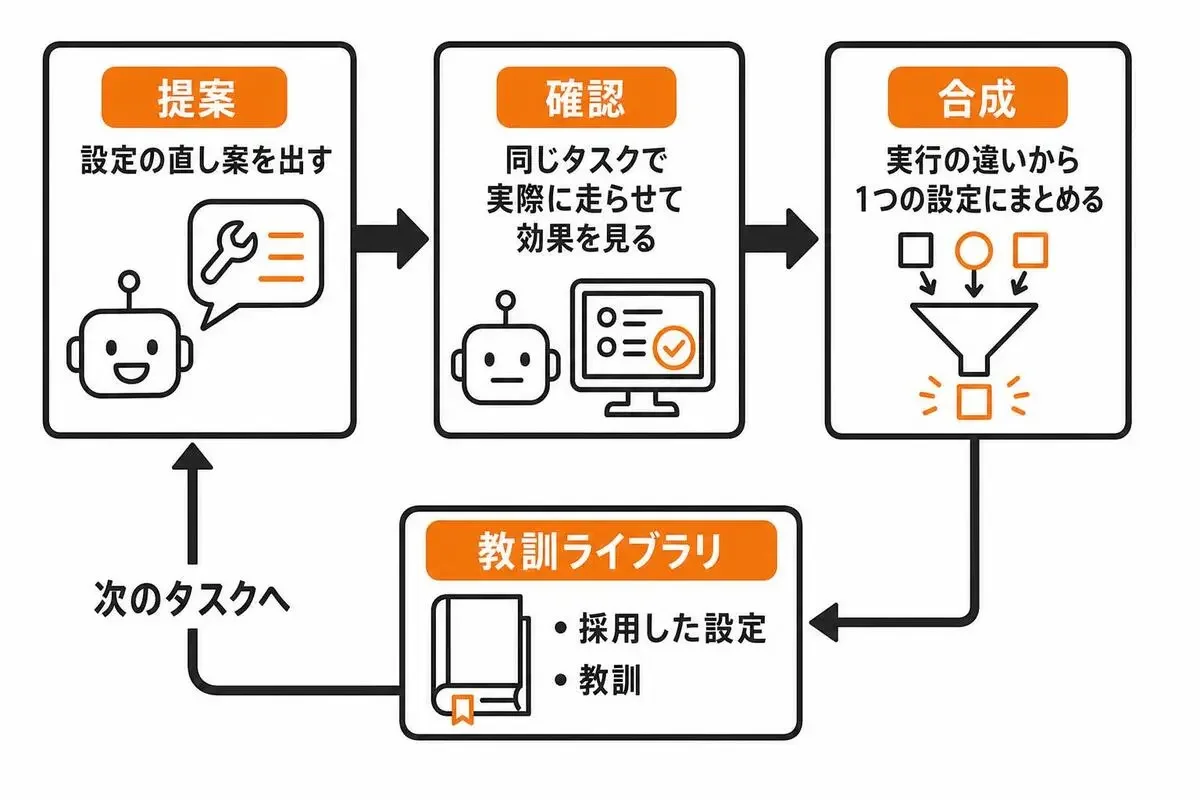
1つのタスクの中では、Propose–Probe–Composeの3段で回ります。改善役がハーネスの編集案を出し(Propose)、同じタスクで実際に走らせて効果を確かめ(Probe)、実行どうしの違いを見比べて1つのハーネスに組み立てます(Compose)。正解のフィードバックは使いません。答え合わせなしで、実行の対比だけを手がかりにするところが肝です。
タスクをまたぐと、もう1段の再帰が効きます。採用したハーネスと、そこから引き出した教訓を、改善役が使うハーネスのライブラリに積み上げていきます。ライブラリはタスクの途中では固定で、次のタスクを始めるときに更新されます。ハーネスを直す側にもハーネスがあって、そちらが育っていく二重の構造です。
論文は arXiv:2610.14224(2026年10月9日投稿)で、著者はNorthwestern大学の1名とGoogle Cloud AI Researchの8名です。コードはApache 2.0で公開されていて、READMEには「Googleの公式サポート製品ではない」と明記されています。
では、実際の1周で何が書き換わるのか。
Harness2のデモで会計の台帳を集計すると、1行が消えた
動かしたのは、ホストのファイルも認証情報も渡さない使い捨てのコンテナ(python:3.12-bookworm、メモリ4GB)です。使った主なコマンドは次のとおりです。
pip install uv
git clone --depth 1 https://github.com/google-research/harness2.git
cd harness2
uv venv --python 3.12 .venv
uv pip install -e '.[render]'
harness2-demo --output /out/demo --k 2
uv pip install は1.1秒、デモは1.8秒で終わり、Local demo: 2 tasks completed; 0 failed. と出ました。題材は会計の台帳2件(ledger-1、ledger-2)で、demo.json には実行28回、エディタの呼び出し32回と記録されています。
先に押さえておきたいのは、このデモでハーネスを書き換えるのが決まった手順で動くエディタで、モデルが考えた編集ではないことです。モデルの認証情報なしで、再帰の1周を本物のPython実行で見せる仕掛けで、並列と逐次の2つの再帰モードがどちらも動きます。
消えたのは、正の金額だけを足す条件だった
元のハーネスはとても小さいです。systemprompt.md は「Reconcile the ledger using python scripts/summarize.py.」の1行だけ。ガードレール、メモリ、ツール指導のファイルは空で、中身があるのは scripts/summarize.py です。
この集計スクリプトが、正の金額しか足していませんでした。該当の1行を前後で並べるとこうなります。
# 元のハーネス
total = sum((amount for amount in amounts if amount > 0), Decimal(0))

# 採用されたハーネス(if amount > 0 が消えた)
total = sum((amount for amount in amounts), Decimal(0))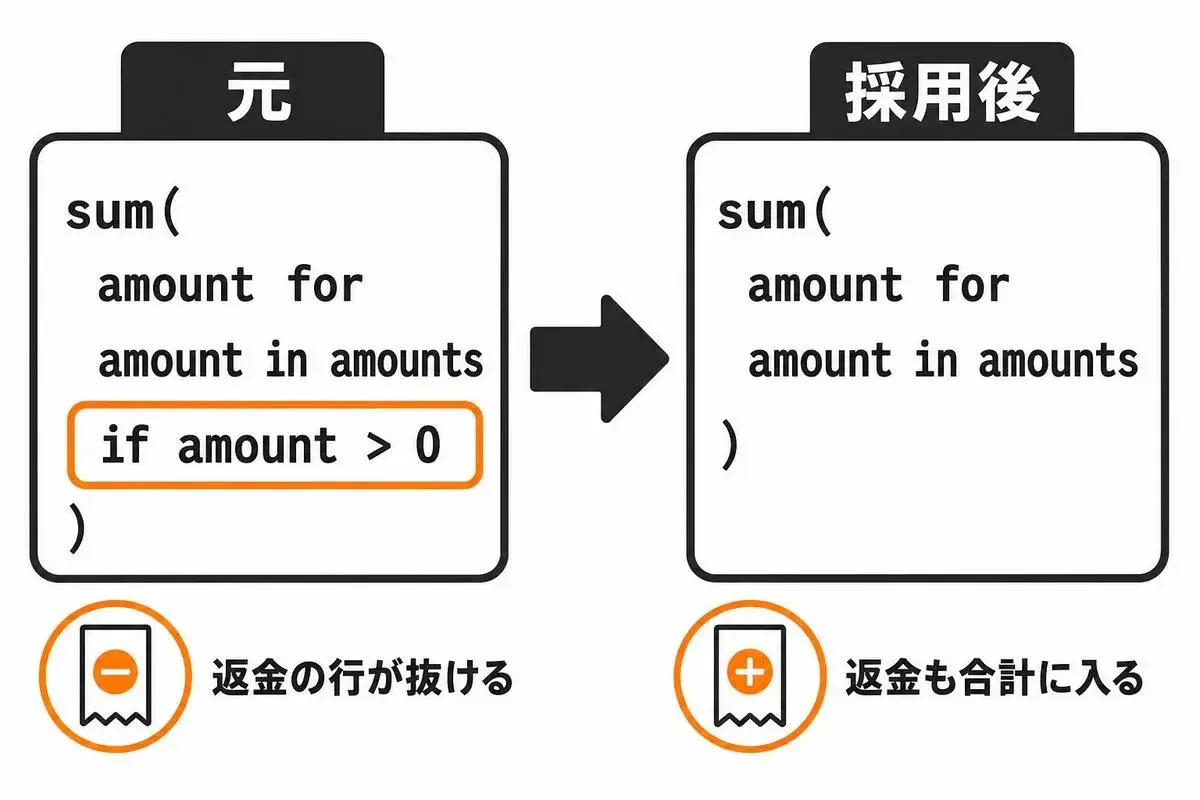
ledger-1には100.25、-20.10、5.00の3行、ledger-2には35.50、-10.25、-5.00のような行が入っていて、どちらにも負の行があります。正の金額だけを足すと、返金や取り消しの分が合計から抜け落ちます。
バグとしては一目で分かる部類です。読んでいて面白かったのは、直し方より、直した理由が文章で残っていたことでした。
Harness2の2件目のタスクは、1件目の教訓を持って始まった
各タスクの出力には EXPERIENCE.md が付きます。ledger-1の回に書かれていたのは、採用した候補(agg1)、理由「The signed total matches the source ledger.」、編集「dropped the positive-only filter from the amount sum」、観測「the probe total included the credits the base run omitted」、判定「helped」でした。
その下に、次のタスクへ渡す教訓が付いています。
cue: When a ledger includes credits and debits
lesson: Include both signs when summing in scripts/summarize.py.
evidence: The scripts/summarize.py row -- removing the positive-only filter changed the probe total to include the credits omitted by the base trajectory.
confidence: high for this observed arithmetic contrast
cueは「どんな状況で効くか」、lessonは「何をするか」、evidenceは「何を見てそう言えるか」、confidenceは「どこまで確かか」です。confidenceが「この観測された計算の対比については高い」と範囲つきで書かれているのが良くて、1回の成功を何にでも効く教訓に膨らませていません。
ライブラリ側の INDEX.md には、過去のタスクごとにハーネスの場所、理由(EXPERIENCE.md)、cueが並びます。demo.json の library_entries_before は、ledger-1の開始時がagg 0件・seq 0件、ledger-2の開始時がどちらも1件でした。2件目は、1件目で学んだ教訓を持った状態から始まっています。
あなたの設定ファイルには、その行がなぜあるのかまで書いてありますか? 命令の1行だけだと、半年後にその行を消していいのか判断できません。
Harness2が直せるエージェントの部品は8つある
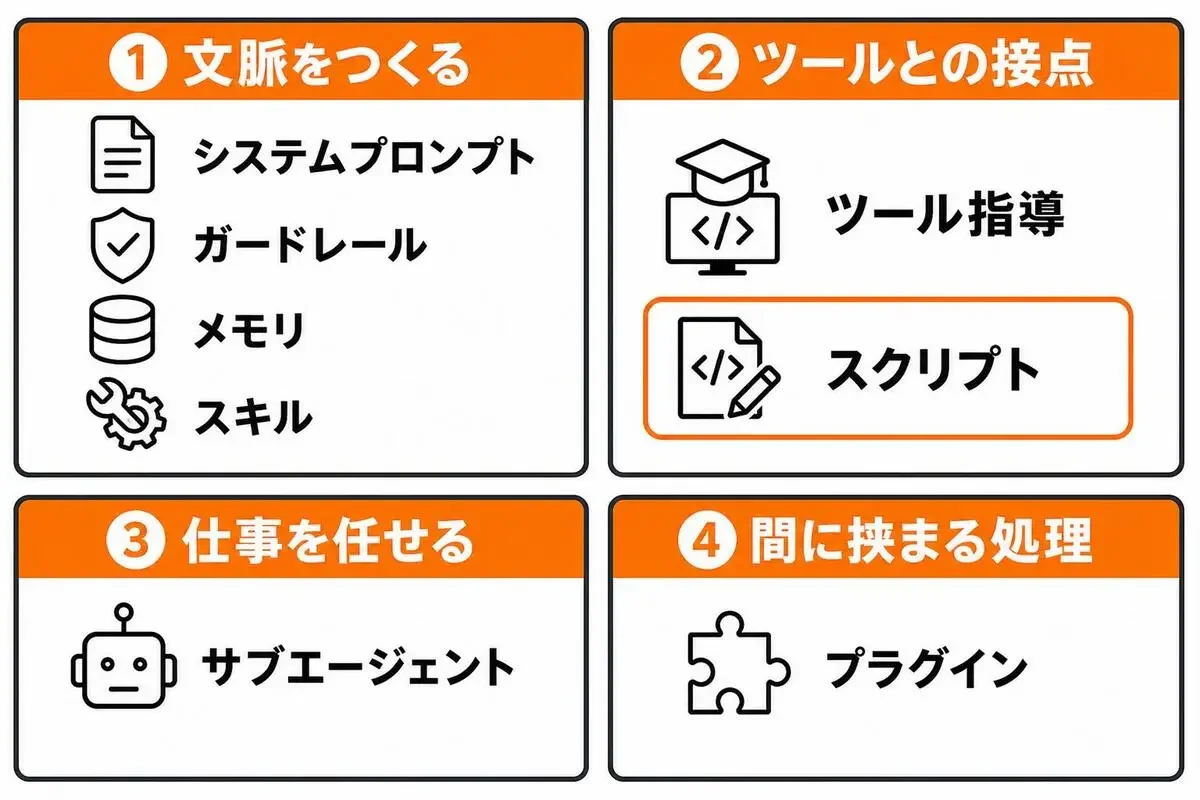
Harness2が書き換えの対象にしている部品は、システムプロンプト、ガードレール、メモリ、ツール指導、サブエージェント、スキル、スクリプト、プラグインの8つです。READMEでは役割ごとにまとめられています。
ふだん一番よく手で直している部品はどれでしょうか? デモで書き換わったのは、このうちスクリプトでした。私の見立てでは、Claude CodeのCLAUDE.md、スキル、サブエージェント、フックも、この表のどこかにそのまま収まります。人が手で育てている設定ファイルのほぼ全部が、自動で書き換える対象に入っているわけです。
Harness2の論文が報告している数字と、ベンチを回す壁
ここから先の数字は論文とサイトの報告で、私は再現していません。サイトに載っているWorkBuddy-Benchの結果は、実行役がGemini 3.5 Flash、出発点のハーネスがOpenCodeで、3回の実行の平均です。
kは再帰の予算です。論文の要約では、GLM-5とGemini 3.5 Flashで改善を1ステップかけると、WorkBuddy-Benchで最大11.5ポイント、JobBenchで4.5ポイント、LABの部分正解率で11.8パーセントポイント上がったと報告されています。11.5は複数のモデルと条件のうちの最大値で、上の表のGemini 3.5 Flash平均ではベースからk=1への伸びは5.1ポイント(72.4から77.5)です。
本番のベンチにはVertex AIとDockerが要る
手元で同じ表を作ろうとすると、まず認証で止まります。モデルを使う実行には、Vertex AIのプロジェクト、gcloudの認証、Node.js 20以上が要ります。ベンチごとの依存もあり、LABはPandocとPoppler、WorkBuddy-BenchはDockerが加わります。
私のコンテナでは harness2 --bench lab --k 1 --dry-run が「No lab tasks found ... Run harness2-setup lab.」で止まり、harness2-check --bench lab は「Setup incomplete: 10 issue(s)」を返しました。
費用の目安は harness2 --help に出ています。1タスクあたり、実行側のロールアウトがR=4k回、改善役のセッションがP=3k回です。k=5なら実行側だけで1タスク20回、改善役が15回で、ベンチ全体ではこれにタスク数が掛かります。お試しの気分で回す規模ではありません。
READMEの「Web access」の節には、実行側のネットワークは無制限で、Codexはサンドボックスを無効にして動くとも書かれています。手元の認証情報や社内のネットワークが見える環境で、そのまま回すのは避けたいところです。
Harness2のデモが証明していないことと、自分の設定への持ち帰り方
使う前の注意を1つだけ。デモで if amount > 0 を消したのは決まった手順のエディタで、モデルが同じ直しを思いつくかは、このデモからは分かりません。
それでも、持ち帰れるものがあります。EXPERIENCE.mdの書き方です。Harness2は教訓を、cue、lesson、evidence、confidenceの組で残します。いつ効くか、何をするか、何を見てそう言えるか、どこまで確かか、の4つです。
自分のCLAUDE.mdに、失敗の対処をどう書いていますか? 命令だけを足していくと、どの行がどの失敗から来たのか、後から誰にも分からなくなります。失敗、直したこと、なぜ効いたか、次に効く条件の4つを1行に収めると、たとえばこうなります。
- 台帳の合計が元帳と合わなかった → 集計から正の値だけのフィルタを外した → 返金の行が抜けていたため → 貸方と借方が混ざる集計のとき条件まで書いてあれば、条件に当たらない場面ではその行を気にせずに済みますし、条件ごと古くなったら消す判断もつきます。次にエージェントの失敗を手で直したら、その1行に「なぜ効いたか」と「いつ効くか」を足すところから始めてみてください。
- 1
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
コードを読まないAIエンジニア
- 5
- 1
-
- 3
- 0
-
 カイ@プロダクトマネージャー
- 2
- 0
-
 むみま
- 4
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
むみま
- 3
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 5
- 0
-
- 2
- 0
-
 gen
- 5
- 0
-
- 2
- 0
-
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます