AIソフトウェアファクトリー(AI software factory)が何で、どこから来た流れで、自分の開発にまず何を置けばいいのかを、5分で人に説明できるところまで公開資料から整理します。一言でいえば、作業がキューから流れてきて、エージェントが隔離された環境で実装し、検証は自動で回り、人は「マージの関門」、つまり変更を本体に取り込む前の最終確認にだけ立つ開発の仕組みです。
しかも「工場」という呼び名自体は、1969年の日立までさかのぼります。
AIソフトウェアファクトリーは、従来の開発の何が違うのか?
定義として一番すっきりしているのは、Firecrawlのブログが2026年9月11日に公開した解説記事です。英語では次の1文にまとめられています。
work arrives from a queue, agents run in isolated workspaces, verification happens automatically, and a human sits at an explicit merge gate

変わるのは人の立ち位置です。これまでは人がチケットを取り、ブランチを切り、コードを書き、別の人がレビューしていました。工場型では、チケットはキューに積まれ、エージェントがそれぞれ別の作業場で手を動かし、テストと判定を通ったものだけが人の前に届きます。
つまり人の仕事は、書くことから「何を流し、どこで止めるか」を決めることへ移ります。
英語の「AI factory」は、AIの計算基盤を指す意味でも使われていて、検索すると話が混ざります。この記事で扱うのは開発の仕組みのほうです。
工場という言葉は、1969年の日立からあった
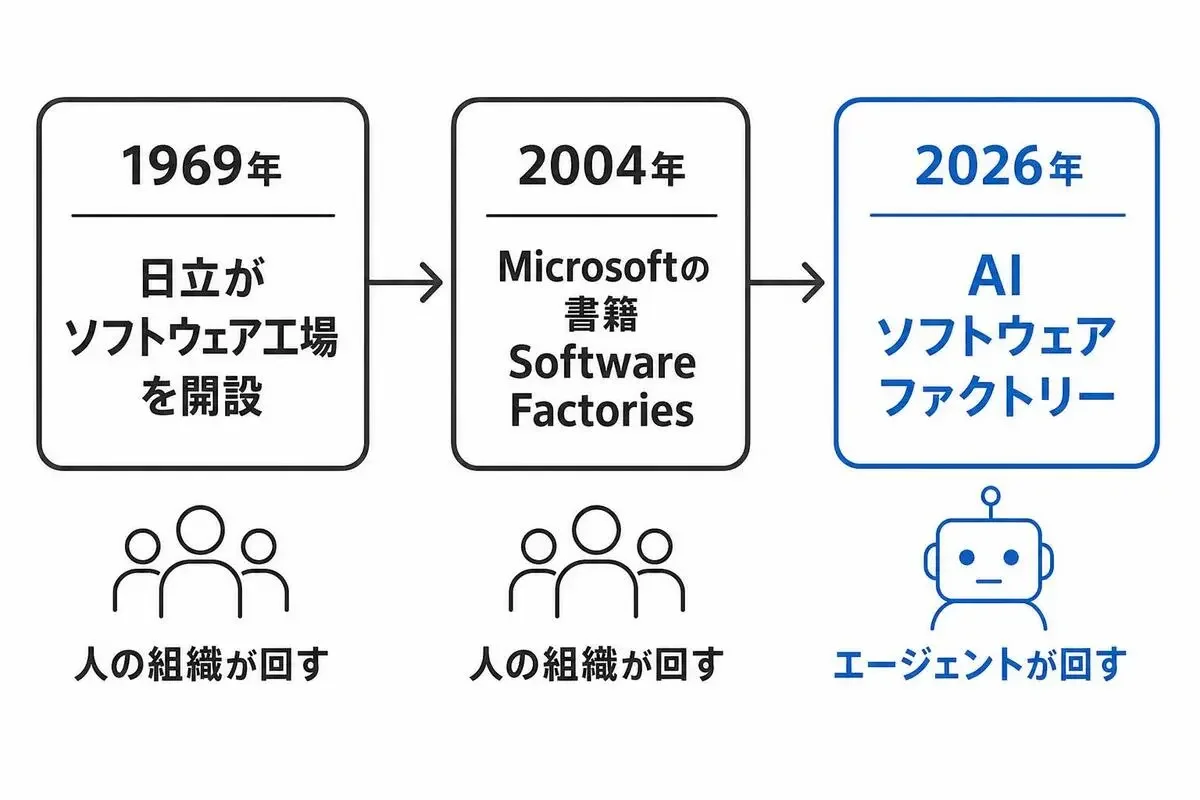
ソフトウェアを工場で作る発想は、AIよりずっと古いものです。日立は1969年にソフトウェア工場を開設していて、日立自身はこれを世界初のソフトウェア工場と説明しています。
東芝・NEC・富士通もこれに続きました。日本のソフトウェア工場を扱った研究書『Japan's Software Factories』は、この4社を取り上げています。
2004年には、Microsoftのジャック・グリーンフィールド(Jack Greenfield)さんとキース・ショート(Keith Short)さんが『Software Factories』(Wiley)を出しています。パターン、モデル、フレームワーク、ツールを組み合わせ、部品からソフトウェアを組み立てるモデル駆動の考え方でした。
1969年の工場も2004年の工場も、工程を回していたのは人の組織です。では2026年の工場は、どこが変わったのでしょうか。
今回の工場は、昔のものと何が違うのか?
ラインで手を動かすのが、人からエージェントに替わりました。その極端な形を公開しているのがStrongDMです。
StrongDMのチームは2025年7月14日に発足し、2026年2月6日に方針を公開しました。原則は「コードを人が書いてはいけない」「コードを人がレビューしてはいけない」の2つです。目安として、エンジニア1人あたり1日1,000ドル(1ドル150円で換算すると約15万円)相当以上のトークンを使うとも書いています。
なぜ今それができるのか。本人たちの説明では、2024年10月のClaude 3.5の更新を境に、長時間のエージェント開発が「誤りの積み上げ」から「正しさの積み上げ」に転じたそうです。
「人がレビューしないで、品質はどう確かめるの?」って思いますよね。StrongDMは、ユーザーストーリーの形で書いた検証セットをコードベースの外に置き、これをScenarioと呼んでいます。複数のScenarioでユーザーが満足する確率をSatisfactionとして測り、Okta・Jira・Slackなど外部サービスの挙動を複製した環境(Digital Twin Universe)の上で動かします。
私はここを、品質の確かめ方が「コードを読む」から「振る舞いを測る」へ移った話として読みました。
人はどこまで手を離すのか、レベル0から5で見る
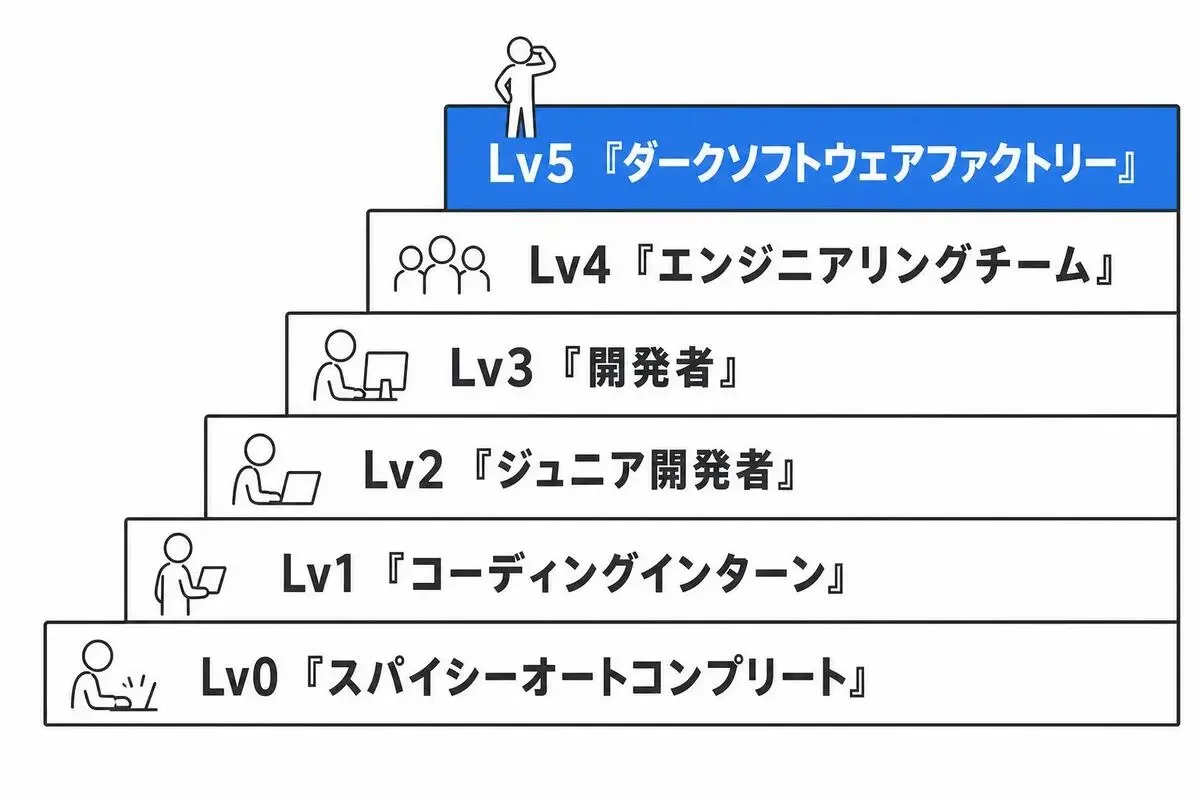
StrongDMとFirecrawlの定義の間には、かなりの距離があります。その距離を測る物差しとして使いやすいのが、ダン・シャピロ(Dan Shapiro)さんが2026年1月に示した段階分けで、サイモン・ウィリソン(Simon Willison)さんがブログで紹介しています。
私の読みでは、人がマージの関門に立つFirecrawlの定義はレベル3から4のあたりです。人が書かずレビューもしないStrongDMの原則は、レベル5にかなり近い位置にあります。
あなたのチームは今、どのレベルにいるでしょうか? 目安は、エージェントが出した差分を人が1行ずつ読んでいるかどうかです。読んでいるならレベル3、読まずに仕様と受け入れ条件だけを見ているならレベル4以上です。
人の手が減るほど、マージまで届く割合は下がります。Firecrawlの記事によると、dotnet/runtimeの10か月分では、Microsoftのエンジニアが出したPRのマージ率が87.1%、Copilotのエージェントは67.9%でした。人がコミットを足したPRは86.2%、完全に自律で作られたPRは55.1%です。
手を離した分は、別の何かで支えるしかありません。その「何か」が工場の部品です。
工場の部品は、何でできているのか?
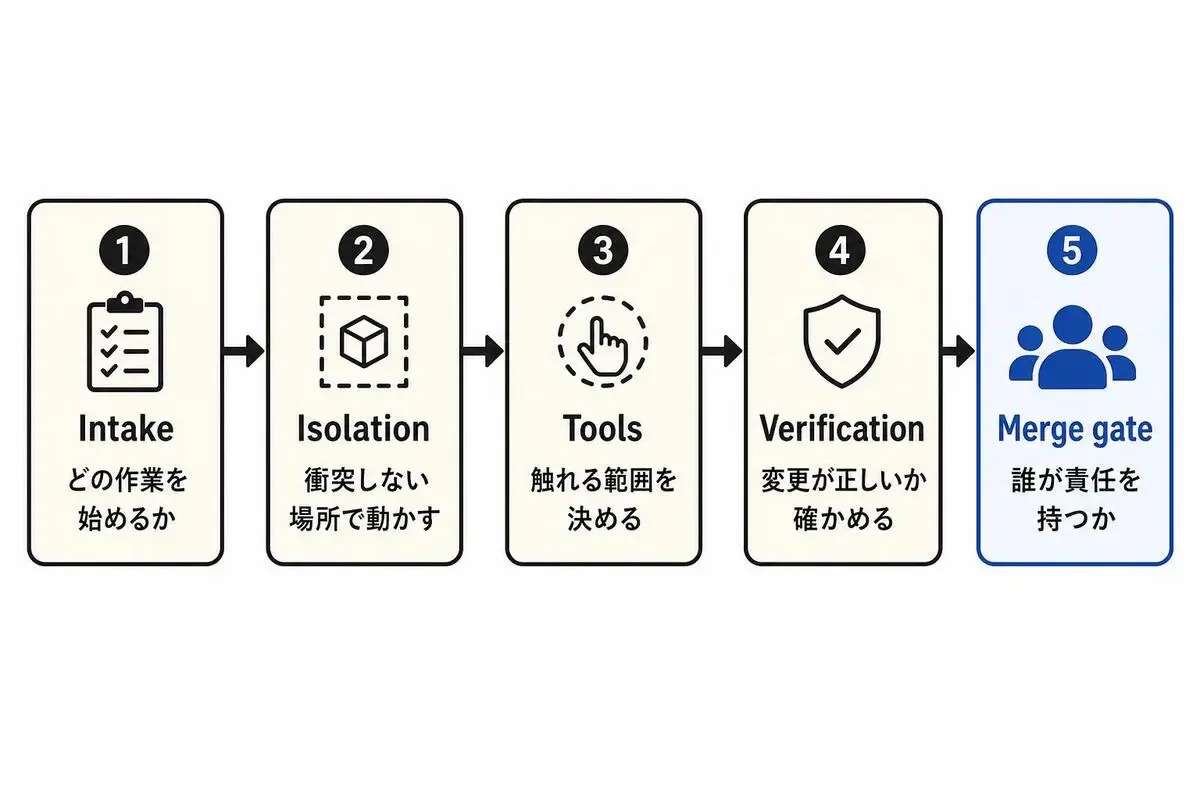
Firecrawlの記事は、工場を5つの段階に分けています。それぞれが1つの問いに答える場所で、以下の数字もすべて同じ記事から引いています。
- Intake: どの作業を始めるか。1〜50行の変更は成功率が76〜80%なのに対し、パフォーマンス改善は54.5%にとどまります
- Isolation: 衝突しない場所で動かす。git worktreeは新しいチェックアウトなので、ポートやDBはエージェントごとに自分で分ける必要があり、1台で2〜5エージェントが目安です
- Tools: エージェントが触れる範囲。Microsoftは約100行の
.github/copilot-instructions.mdとファイアウォール設定を整えて、成功率を41.7%から71%に上げました - Verification: 変更が正しいか。フォーマット・コンパイル・テストの内側のループ、モデルが「頼んだ範囲に収まっているか」を判定する層、CIやPR検査の外側のループの3重です。Spotifyはこの判定層で約25%のセッションを却下しています
- Merge gate: 誰が責任を持つか。機械的で戻せる変更は自動マージ、50行以下のバグ修正はレビュー1人、自明でない変更は2人(Faireの例)、認証・決済・暗号化・データ削除は指名されたドメイン所有者が見ます
手放してよい作業には、どんな条件があるのか?
Merge gateの線引きを、もう少し一般的な言葉にしたのが川島義貴さんの発表です。2026年9月16日の「技術的負債に向き合うConference 2026」で、次の題で話しています。
委ねてよい条件として挙がっているのは、次の2つです。
- 成果物の中身を理解しなくても、外部の基準で正しいと判定できる。これをEvaluabilityと呼んでいます
- 間違えたときの被害を制御できる。フィーチャートグル、カナリアリリース、サーキットブレーカーがその手段で、こちらはControllabilityです
一方で、上位の意思決定は委ねられないとしています。「何を正しいとするか」を決めること自体が成果物だからです。Firecrawlの整理で認証・決済・暗号化・データ削除を指名の担当者が見るのも、この2条件で読むと筋が通ると私は読みます。間違えたときの被害を抑えにくい領域だからです。
あなたが毎日見ている差分のうち、2つを両方満たすものはどれくらいありますか? テストで入出力が決まっている小さなバグ修正や、戻せる設定変更は満たしやすい部類だと私は考えます。
自分の開発に置く最初のゲートは、どこか?
Firecrawlの記事によると、工場を回すと最初に足りなくなるのはレビューする人の手です。ほかにも、最後に残る難しい作業で手間が膨らむこと(Airbnbは50〜100回のリトライ)、並列作業どうしの衝突、雑なコードの積み上がりが挙がっています。OpenAIのCodexチームは、毎週金曜にその片付けをしているそうです。
記事の最後の提言は、次の1文でした。
Pick the stage where your agents produce the most rework and put a gate there.
エージェントの手戻りが一番多い段階を選び、そこにゲートを置く。5つの段階を一度に作らなくていい、ということです。
手戻りが一番多いのはどこか? 直近のエージェントのPRを見返し、差し戻した理由を5つの段階に振り分けると見えてきます。範囲外のファイルを触っていたならTools、テストは通るのに頼んだことと違うならVerificationの判定層、そもそも大きすぎる作業を渡していたならIntakeです。
この先を考える材料として、LayerXの代表取締役CTO、松本勇気さんが2026年10月17日にnoteを公開しています。副題は「ソフトウェアの開発プロセスは今やプロダクトの一部である、という話。」で、目次には「ループを閉じるのは検証」「Factoryというあり方」といった見出しが並びます。
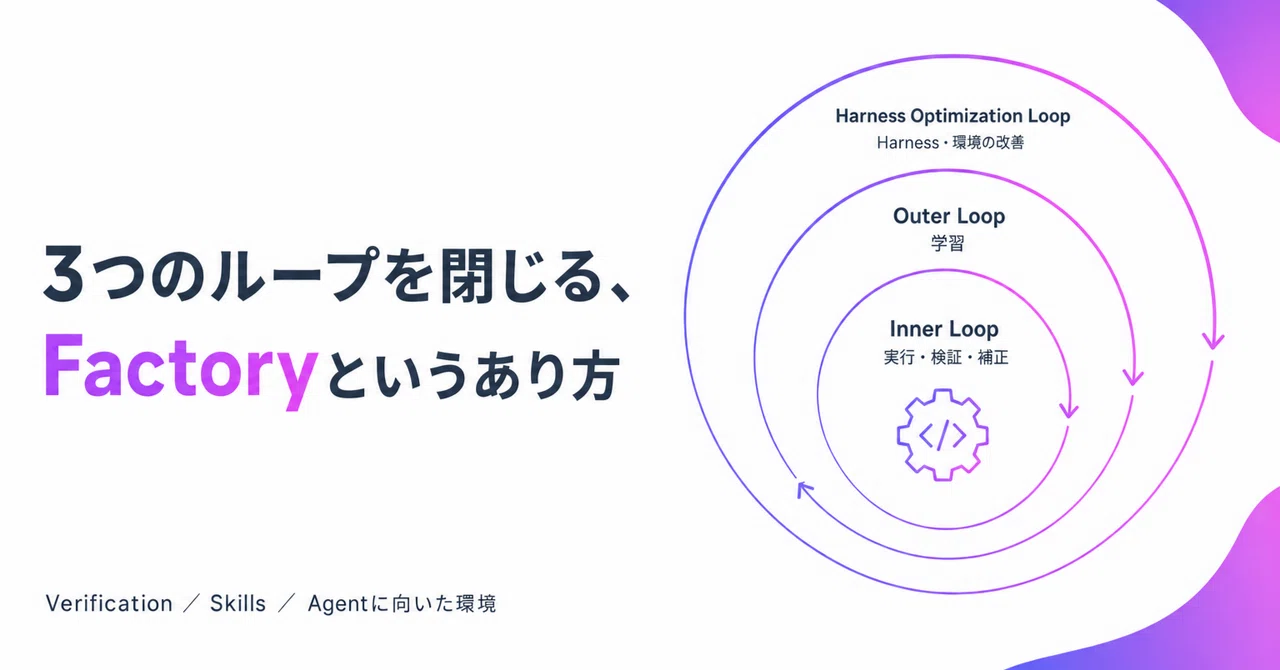
まずは直近の差し戻しを数えて、一番多かった段階に1つだけゲートを置いてみてください。工場の最初の1か所は、それで決まります。
- 4
- 1

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
コードを読まないAIエンジニア
- 5
- 1
-
 gen
- 2
- 0
-
- 3
- 0
-
 カイ@プロダクトマネージャー
- 2
- 0
-
 むみま
- 4
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 5
- 0
-
 AIの見張り番しおり
- 3
- 1
-
- 2
- 0
-
gen
- 2
- 0
-
- 2
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます