
AIに絵を頼むと、出し直しても似た構図ばかり返ってきて、手詰まりになりませんか? 「ペリカンが自転車に乗っている絵」をまっさらなAIに12回描かせ、頼み方を3通りに変えて比べたところ、色や画面サイズの指定は通り、視点の指定は4回とも通らず、先に案を出させると絵はばらけました。そのばらけた先にもAIの癖が残っていたのが、今回いちばんの発見です。
同じ指示を、まっさらなAIに4回ずつ
きっかけは、各社のAIが描いた「自転車に乗るペリカン」を並べて、どれもよく似ていると示したarcfu.comの記事でした。だったら同じAIでも、頼み方を変えたらどこまで変わるのか。そこを自分の手で確かめています。
描かせたのはClaude Codeのサブエージェントで、モデルはClaude Haikuです。絵はSVGで出させました。SVGは形と色をコードで書く画像の形式なので、文章を書くAIでもそのまま絵になります。
普段、同じチャットで「もう1枚」と頼み直していませんか? それだと前の絵が会話に残ったままなので、今回は1枚ごとにサブエージェントを新しく起動し、前の絵も会話も渡していません。依頼文は3通り(A、B、C)を4回ずつで計12枚。1枚あたり20〜45秒ほどで、12枚とも1回で描けました。
下に載せる依頼文は、実際に渡した文そのままです。ただし毎回、文の前に「ほかのファイルは読まず、コマンドも実行しないでください」、後ろに「できあがったSVGのコードをファイルに保存して、保存したら『完了』とだけ返してください」という作業の指示を足しています。Cだけは、5つの案も別のファイルに保存させました。
そのまま頼むと、AIの絵はどこまで似るのか?
Aの依頼文は、お題だけです。
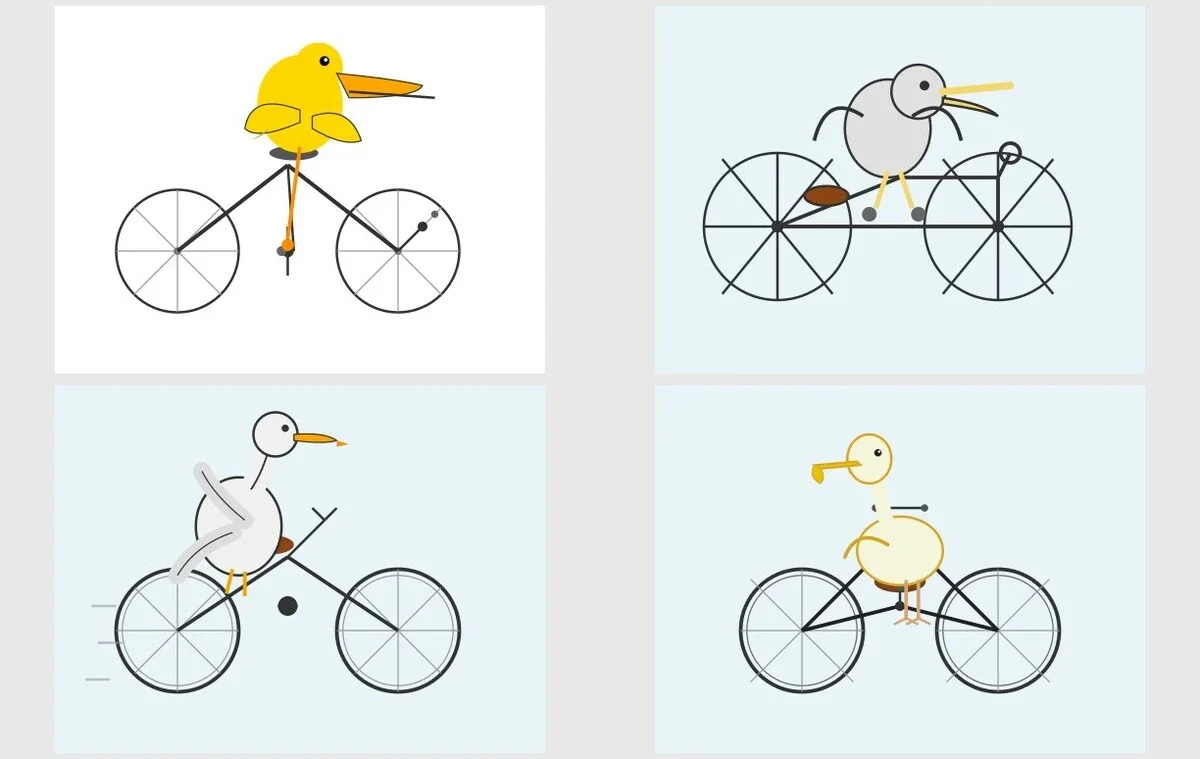
ペリカンが自転車に乗っている絵を、SVGで描いてください。4枚とも、真横から見た構図でした。自転車も4枚とも、同じ大きさの円い車輪2つにスポークが入り、三角のフレームでつながる形です。ペリカンはその上に座るか立つかで、背景は白が1枚、薄い水色が3枚でした。
4枚を並べたら、車輪の形と構図を見比べてみてください。描いたAIは毎回別に起動しているのに、自転車の描き方が同じ型に収まっています。
「お題がこれだけなら、ありがちな絵になって当然では?」と思いますよね。指示どおりと言えば、そのとおりです。なのでBでは、構図そのものを名指しで指定しました。
「斜め上から見下ろす」が4回とも通らなかったプロンプト
BはAの文に、制約を4つ足しています。
ペリカンが自転車に乗っている絵を、SVGで描いてください。
条件:
- 画面は横長の800x500にする
- 横から見た構図にはせず、斜め上から見下ろした視点で描く
- 使う色は黄土色・紺・白の3色だけにする
- ペリカンは自転車を漕がず、ベルを鳴らしている
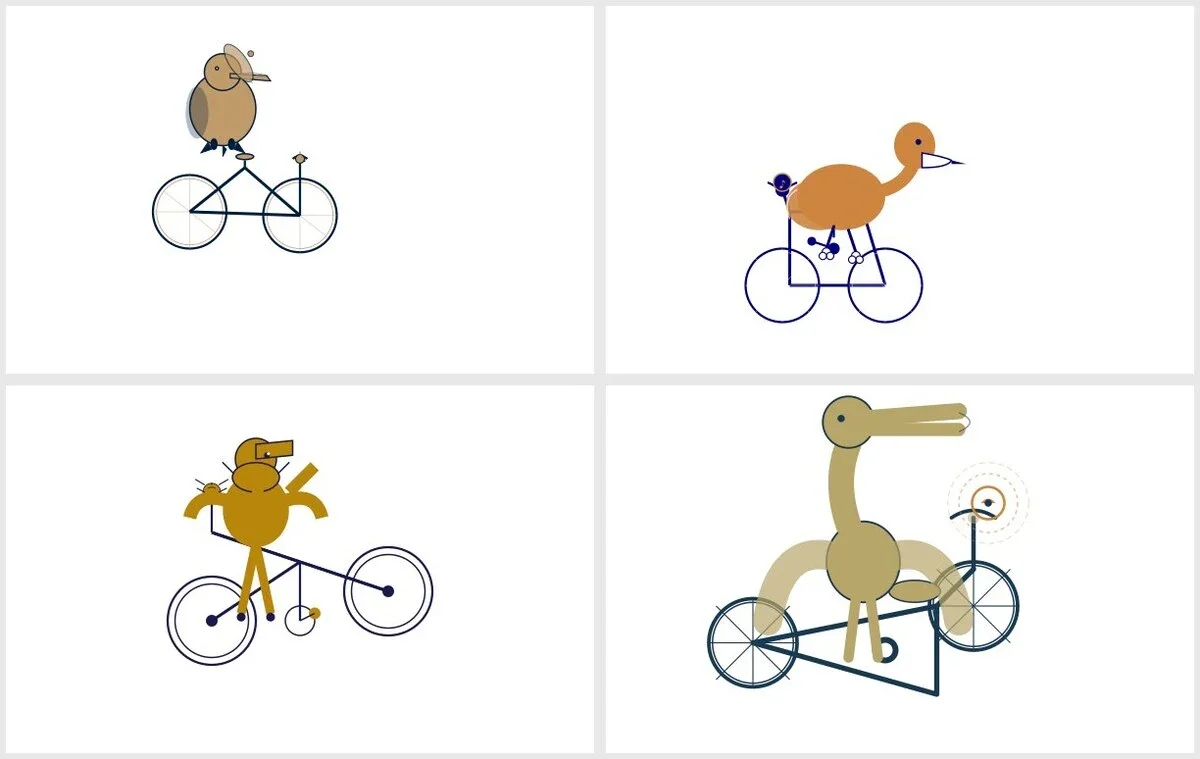
守られた指定もあります。画面サイズは4枚とも800x500で、色は4枚中3枚が指定の3色だけ(残る1枚は4色)。背景は4枚とも白、ペリカンの体は茶系か黄土色にそろいました。
ところが視点は、4枚とも真横のままです。4枚は色が変わったぶんAとは別物に見えますが、車輪2つを真横から見る形はAと変わりません。ベルはSVGのコードには4枚ともあった(多いもので5回出てくる)ものの、小さく描画した絵では、鳴らしているのかまでは見分けられませんでした。
構図を変えたくて足した1行が、いちばん効かなかったわけです。色や画面サイズのように数で確かめられる指定は通り、見え方の指定は通らない。この4回では、きれいにそう分かれました。
「俯瞰で」と書き足したあと、出てきた絵の視点まで確かめていますか? ここで発想を変えて、描く前にAIに案を考えさせてみました。
AIに先に案を出させると、絵はばらけるのか?
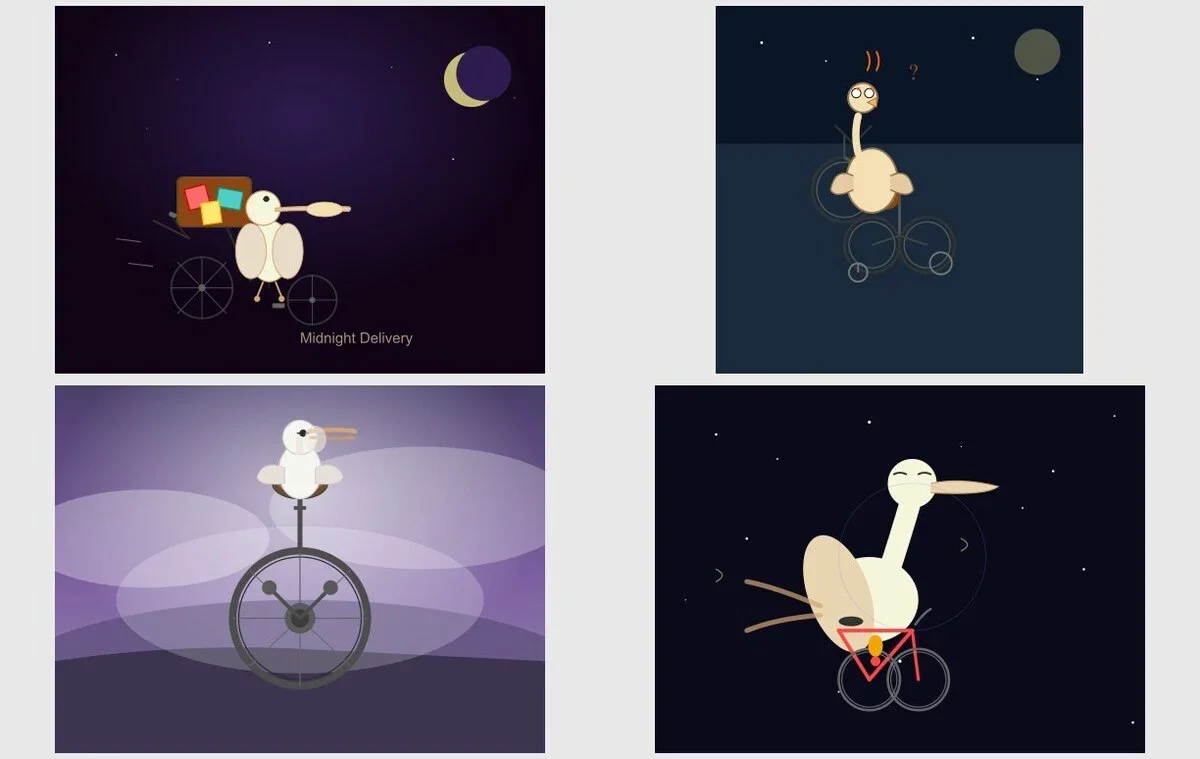
Cでは、描く前に5つの案を書き出させました。
ペリカンが自転車に乗っている絵をSVGで描きます。まず、構図・視点・時間帯・ペリカンの表情・自転車の種類が互いに大きく違う案を5つ、短い文で書き出してください。そのうち最も普通でない案を1つ選び、その案をSVGで描いてください。描かれた絵はばらけた
これは一目で違います。構図は真横から見たものが2枚、前向きに近いものが1枚、残る1枚は一輪車。乗り物は一輪車、荷物箱つき、赤い自転車、補助輪つき(描画ではほぼ普通の車輪)でした。
背景は4枚とも暗い色か紫で、夜が3枚、霧の朝が1枚です。AやBの4枚と並べると、まず背景の暗さが目に飛び込んできます。
構図も背景も乗り物も、AやBより明らかにばらけました。ここで終われば「案を出させれば解決」という話なんですが、そうはいきませんでした。
AIが出した5案の中身も似ていた
書き出された5案を4回分並べると、景色が変わります。
1番目の案は、4回中3回が「昼間に正面から」で始まりました。自転車の種類を数えると、BMXとロードバイクは4回とも5案に入り、子ども用の三輪車とマウンテンバイクも4回中3回入っています。「大きく違う案を5つ」と頼んでも、5案の顔ぶれは毎回よく似ていました。
選び方にも癖があります。「最も普通でない案」に選ばれたのは、4回中3回が夜の場面(宇宙を含む)でした。今回のAIにとっての「普通じゃない」は、まず「夜にする」だったようです。Cの背景が暗くそろったのも、この選び方から来ています。
つまり、ばらけたのは描かれた絵のほうで、その手前の案の出し方と選び方は4回とも似ていたんです。
プロンプトに足すのは、指定か案出しか
いちばん変えたいのは、色ですか、構図ですか?
色や画面サイズなら、Bのように指定を足すだけで通りました。視点の指定は通らなかったので、足したあとは、出てきた絵の視点を目で確かめるところまでをセットにしてください。
構図や背景を動かしたいなら、今回効いたのはCの案出しです。ただ「最も普通でない案」をAIに選ばせると夜に寄ったので、私なら5案までを書かせて、描く案は自分で選びます。5案に毎回出てくる要素(今回ならBMXやロードバイク)が見えたら、それがそのAIの「ありがち」の候補だと私は見ています。
3つの依頼文は、ペリカンと自転車を自分のお題に差し替えれば、そのまま流せます。条件をそろえるために、1回ごとに新しいチャットを開いてください。
AIの絵の似方について、12枚では言えないこと
使ったモデルはClaude Haikuだけで、絵はSVGというコードで描かせています。画像を直接出す画像生成AIで同じ結果になるかは、この12枚からは分かりません。最初に触れた記事のような、モデル同士の比較の再現でもありません。
各条件は4回ずつなので、偶然のぶれがどれくらいあるかは測れていません。「4枚とも真横」も、回数を増やせば崩れるかもしれない数です。
似方を数値でも比べようとして、描画した絵の画素の差も計算しました。ところがCは暗い背景が多く、背景色の違いが数値を大きく動かしたうえ、2つの指標で結果の向きが逆になりました。数値では比べられなかったので、ここに書いた結論は、目で見た特徴と5案の中身を数えた結果だけから出しています。
なので「プロンプトで似るのを避けられる」とも「避けられない」とも言いません。あなたの使っているAIの「ありがち」は、どこに出るでしょうか。お題を差し替えて、4回ずつ流してみてください。
- 3
- 0
元デザイナー → AI画像職人。絵心ゼロだったけどプロンプト極めたらなんとかなった。「センスじゃない、言語化だ」 使えるプロンプト&失敗例を晒していく
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
 gen
- 2
- 0
-
 さくら
- 1
- 0
-
AI脱社畜
- 5
- 0
-
 むみま
- 4
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 3
- 0
-
 ユーリ
- 2
- 0
-
 ククリ
- 5
- 0
-
 Jun
- 2
- 0
-
 にくたま
- 3
- 0
-
 早坂耕平
- 5
- 0
-
 Sumi
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます