
Ripple-65B Previewは、米国のRicursive Intelligenceが11月4日(日本時間5日)に公開した、コーディング向けのオープンウェイトモデルです。ソースコードを外部のAIサービスに送れず、Claude Codeを横目に手作業を続けている職場からすると、「社内のサーバーに置ける米国製」というだけで気になる存在なんですよね。この記事では、審査で聞かれる順に出どころ・学習データ・必要なGPU・ベンチマークの数字を確かめ、64GBのMacで4bit版を動かした結果まで並べます。
オープンウェイトは、学習済みの重み(モデル本体のファイル)が公開されていて、自分の機械で動かせるモデルのことです。
あなたの職場で、AIの導入審査に最初に出てくる質問は何でしょうか? ベンチの数字より先に聞かれるのは、どこで作られて、何で学習したかなんですよね。先に答えを書くと、Ripple-65Bは社内に置く候補には入ります。ただ、Claude Codeの代わりとして審査に出すには、まだ資料が足りないと見ています。
Ripple-65Bは、どこで作られて何で学習したか
開発元のRicursive Intelligenceは、米パロアルトの会社です。創業者はアンナ・ゴールディさん(CEO)とアザリア・ミルホセイニさん(CTO)で、2人はGoogleでチップ設計のAIであるAlphaChipを作りました。

モデルは約650億パラメータを毎回すべて使うDense型です。ライセンスはApache 2.0の標準の全文で、ダウンロードに申請は要らず、独自の利用規約も付いていません。法務がApache 2.0を許容している職場なら、ライセンスの欄で止まることはまず無いはずです。

書かれている学習データ
事前学習は12兆トークンで、テキストのみ、主に英語とコードです。コードの比率を大きく上げ、事前学習では合成データ(AIに作らせたデータ)を最小限にしたとあります。その後の調整用のデータは外から買わず、自前の合成データで作ったそうです。出発点はAI2が公開したOlmo 3です。
書かれていない学習データの出所
どこのサイトから集めたのか、コードはどのライセンスの範囲から取ったのか、合成データをどのモデルで作ったのか。この3つは見当たらず、技術レポートもまだありません。Olmo 3は手順の出発点で、データの出所を保証するものではありません。
審査票の「学習データの出所」の欄に今書けるのは、「12兆トークン、主に英語とコード」の1行です。あなたの職場の審査は、この1行で通るでしょうか?
64GBのMacでRipple-65Bを動かすと、どうなったか
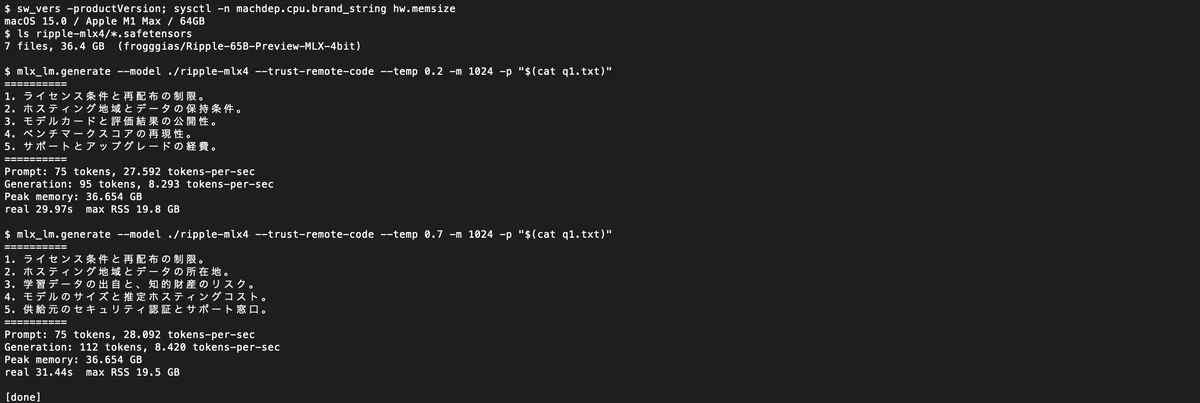
動かしたのは手元のMac(macOS 15.0、Apple M1 Max、メモリ64GB)です。公式の動かし方はNVIDIAのGPU向けなので、有志がMLX(Apple Siliconで機械学習を動かすApple製の仕組み)向けに変換した4bit版を使いました。7ファイル・合計36.4GBで、ダウンロードに約1時間かかりました。

第三者のモデルコードを実行する許可が要る
審査の目線で一番大事だったのは、速さより動かし方でした。手元でモデルを動かす定番のllama.cppは、本家がRippleの構造にまだ対応していません。有志のGGUF版も「パッチを当てたllama.cppが必要」と書いていて、Ollamaに入れてそのまま、とはいきません。
MLX版も、変換した人が書いたモデルのコード ricursive.py を同梱していて、外部のコードの実行を許す --trust-remote-code を付けたときだけ動きます。僕は実行前に282行を読み、importが mlx・dataclasses・typing・mlx_lm だけで、通信やファイル操作、exec の類が無いことを確かめてから動かしました。社内なら、「第三者が書いたコードを実行する」申請が1件増えるわけです。
毎秒8トークン台、メモリのピークは約37GB
生成の速さはどの回も毎秒8.2〜8.4トークンで、メモリのピークは36.7〜37.0GBでした。読み込みを含めた所要時間は、短い日本語の回答で30〜44秒、500トークンほどのコードで84秒です。
温度0.2では同じ項目を繰り返した
日本語のお題は「社内のサーバーで大規模言語モデルを動かすとき、調達の審査で確認すべき項目を5つ、1行ずつ短く挙げてください。」です。温度(出力のばらつきを決める設定で、低いほど同じ答えに寄る)を0.2にして3回流すと、2回で同じ項目を繰り返しました。1回目の出力はこうです。
1. ライセンス条件と再配布の制限。
2. ホスティング地域とデータの保持条件。
3. モデルのライセンスと再配布の制限。
4. モデルのライセンスと再配布の制限。
5. モデルのライセンスと再配布の制限。
2回目は5つと頼んだのに10項目を出し、2行を交互に並べました。温度0.7の2回は重なりがなく、「学習データの出自と、知的財産のリスク」まで挙げています。コードの生成では温度を低めにすることが多いので、覚えておきたい癖です。
Ripple-65Bが書いたコードは、1行直すとテスト13件が通りました
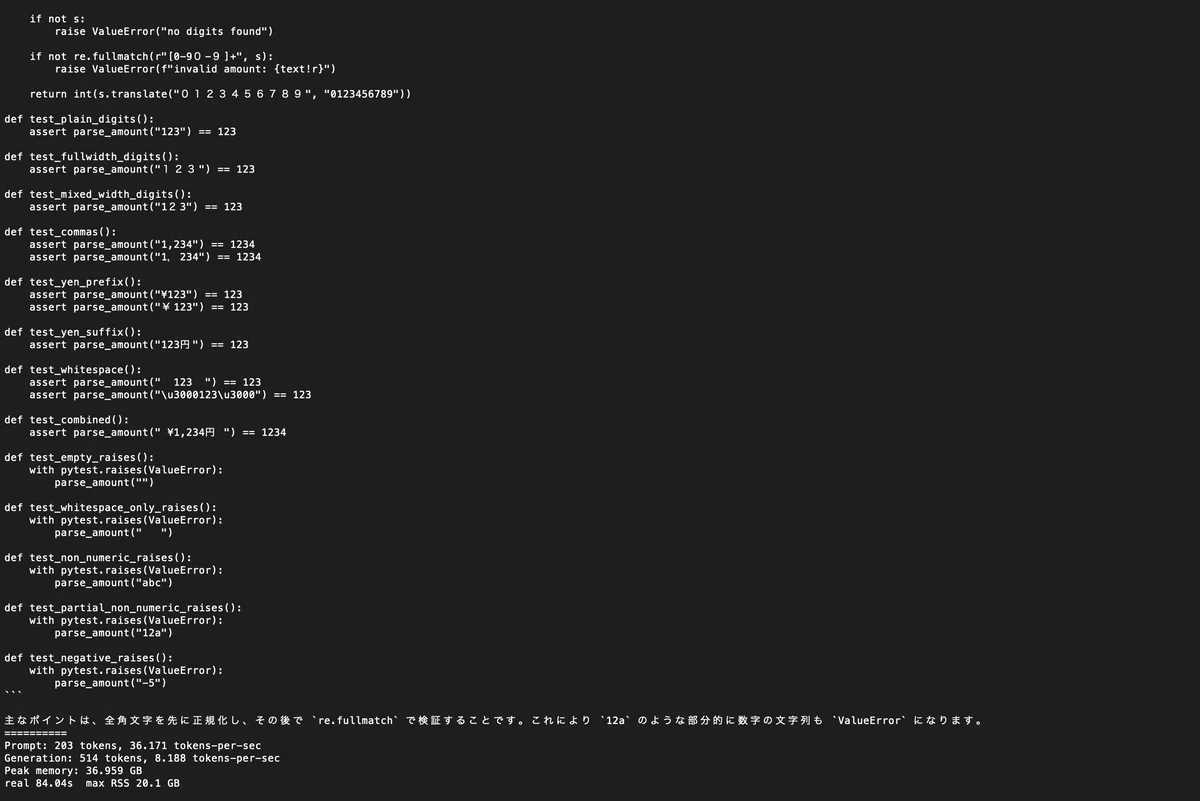
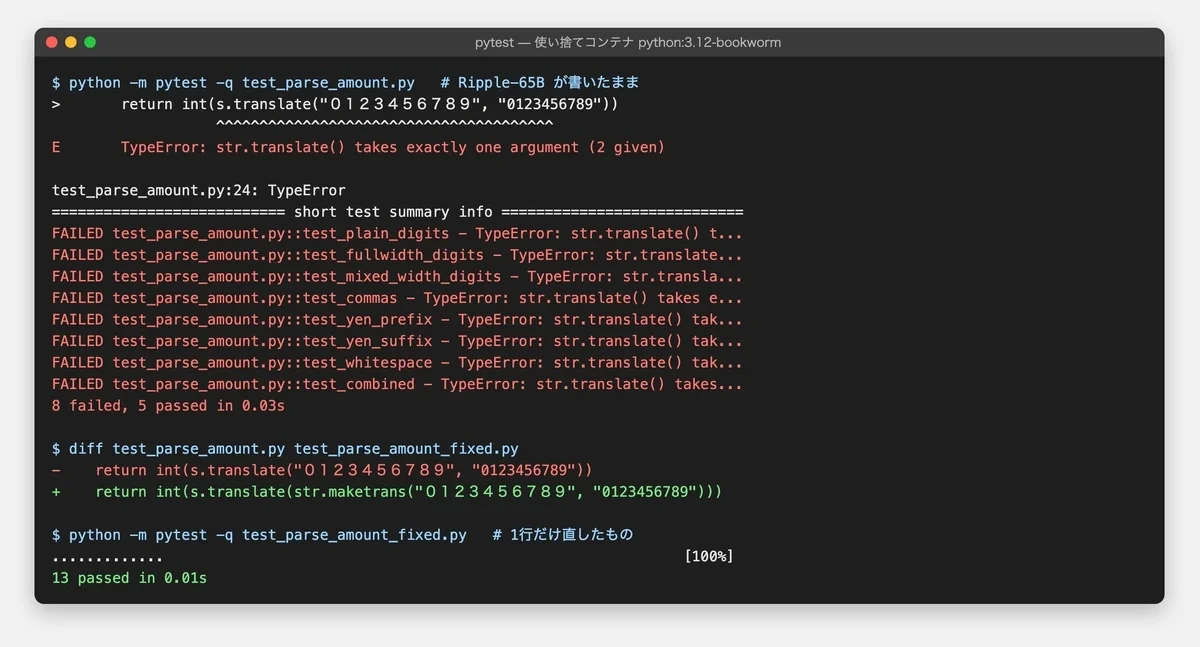
コーディングのお題は、振込データの金額欄を円単位の整数にする関数 parse_amount を、pytestのテストつきで書かせるものです。全角・半角の数字、カンマ、円記号、末尾の「円」、全角スペースを受け付け、空文字や負の数は ValueError にする仕様で、温度0.2で流しました。返ってきたコードには13件のテストが付いていて、仕様の項目をすべて拾っていました。
使い捨てのコンテナでpytestを流すと、8件失敗、5件成功です。原因は全角数字を半角に変える1行で、str.translate() に文字列を2つ渡していました。translate は変換表を1つ受け取るので、str.maketrans で表を作ってから渡す必要があります。
-    return int(s.translate("0123456789", "0123456789"))
+    return int(s.translate(str.maketrans("0123456789", "0123456789")))
通った5件は、どれも ValueError を出すべき入力のテストで、例外で先に止まるため壊れた行まで進まなかったんです。この1行を直すと13件すべてが通りました。
人が読んでテストを回す前提なら、下書き役としては使える見込みがあります。一方でClaude Codeは、ファイルを読み、書き換え、テストを回すところまで自分で進める道具です。Ripple-65Bは重みだけなので、その部分は別の道具と組み合わせることになります。
社内サーバーにRipple-65Bを置くなら、GPUは何台要るか
公式の動かし方は、リポジトリに同梱されたサーバーの説明にあります。NVIDIA B200を2基、Linux、CUDA Toolkit 13、SGLang 0.5.19という構成です。モデルカードによると、B200 2基・同時8件で毎秒250トークン(量子化や専用の高速化の前)が出ます。依存するソフトは実行時に自動で入る作りなので、インターネットに出られない社内サーバーでは、パッケージのミラーを先に用意する必要があります。
モデルカードは、NVIDIAの小型機DGX Spark(メモリ128GB、帯域は毎秒273GB)にも載ると書いています。生成の速さはおおむね「メモリ帯域÷モデルの大きさ」が上限なので、57.2GBのNVFP4版なら毎秒5トークン前後です(概算)。同じ計算をM1 Max(毎秒400GB)と4bit版に当てると上限は毎秒11トークン前後で、手元の実測8.2〜8.4トークンはその内側でした。「載る」と「仕事で回る速さ」は別物なんですよね。
あなたの社内で、B200クラスのGPUを2基確保する見込みはありますか? 無ければ、最初の申請は「4bit版を1台で試す」からになります。
Terminal-Benchの80.52は、Claude Codeと比べた数字ではありません
Terminal-Benchは、ターミナルでの作業をAIエージェントにやらせて、課題を解けた割合を測るベンチマークです。Ricursiveは、その2.1版で80.52を出したと発表しています。
ただ、モデルカードの比較表に並ぶのはReflection Beam 501B(80.1)など米国製のオープンウェイト4つだけで、Claudeは入っていません。中国製も含めた第三者の集計llm-stats(各社の自己申告をまとめたもの)では、2.1版でGLM-5.3が88.2です。80.52は「米国製のオープンウェイトの中で首位」という意味です。
しかもTerminal-Benchの公式リーダーボードは今は4.0版で、2.1版とは別物です。モデルカード自身も、公式の測定環境Terminus 2では点数が全般に下がったと書き、自社の結果を「ベストエフォート」としています。審査資料に80.52と書くなら、「米国製オープンウェイト内での自社評価」と注記するのが筋だと見ています。
Revolutが選んだのは、中国製のオープンウェイトでした
英国のフィンテック企業Revolutは、約2,000人のエンジニアが使うコーディング用のAIを、自社で動かすGLM(中国のZhipu AIのモデル。報道ではGLM 5.3)に切り替えました。runtimewireの記事によると、NVIDIA B200が56基、費用は100万トークンあたり0.30ドル(約45円、1ドル=150円で計算)で従来の約10分の1です。Claude CodeとCodexは、例外の仕事のために残しています。
中国製が審査で止まる職場には、この選び方はそのまま使えません。コードを外に出せないなら、「例外は外部の上位モデルへ」という逃げ道もなく、社内に置く1本で日々の仕事を回せるかが問われます。
Ripple-65Bの審査に出せる資料は、今どこまでそろうか
Claude Codeの代わりになるか、という問いへの今の答えは、「社内に置く候補には入るが、代わりとして審査に出すのはまだ早い」です。米国の開発元とApache 2.0という入口はそろい、64GBのMacでも動きました。足りないのは、学習データの出所の資料と、第三者の評価と、本家のツールの対応です。
名前にPreviewと付いている今は、正式版と技術レポートを待つ時期だと見ています。その間に、法務へApache 2.0の扱いを確かめ、手元の機械でテストつきのお題を流して癖をつかんでおく。同梱のモデルコードは、動かす前に必ず読んでください。
- 6
- 0
地方銀行グループのシステム子会社で行内ツールを作っています。コードを外に出せない職場で、社内に置けるAIを探して試した記録を書きます。性能表より先に、ライセンスと必要な機材を確かめる派です。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 1
- 0
-
AI脱社畜
- 4
- 0
-
bokuwalily
- 2
- 0
-
コードを読まないAIエンジニア
- 4
- 0
-
 gen
- 4
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
 梢
- 6
- 0
-
bokuwalily
- 1
- 0
-
 えかさ@データサイエンス解析
- 4
- 0
-
bokuwalily
- 2
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
えかさ@データサイエンス解析
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます