
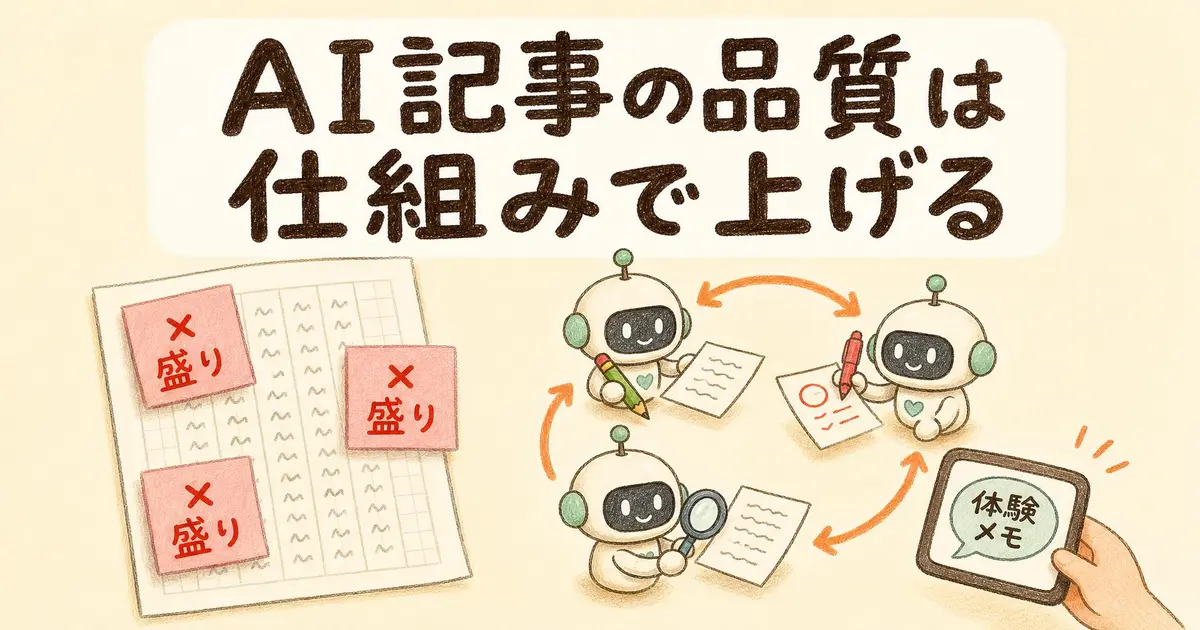
AIで量産すると、中身が薄くなり、メモに無い盛りや確かめていない話が混ざります。人が入れるのは体験と確かめた事実だけで、公開のボタンも人が押します。下書き・採点・直し・足りない体験の質問は、AIに毎回同じ物差しで回させます。その仕組みを、依頼文3本とClaude CodeのSkillで組みました。
依頼文、チェックの手順、採点のやり直しをファイルにまとめ、毎回同じに回せるようにした枠をハーネスと呼びます。指示文を磨くより枠を設計する考え方は、ハーネスエンジニアリングと呼ばれています。Skill は、Claude Code に手順書(SKILL.md というファイル)を置いておくと、頼み方が合ったときにその手順で動く仕組みです。
素のAIに記事を書かせると混ざるもの
見本の題材は「自転車通勤 雨の日 どうする」です。体験メモ(書き手が質問に答え、スマホなどの音声入力で話した文字起こし)は、仕組みを試すために作った架空のもので、私の体験ではありません。依頼文なしで「このメモから記事を書いて」とだけ頼むと、26秒で見出しもまとめも整った記事が1本できました。
メモに無い盛りが、3か所入った
メモと1文ずつ照らすと、3か所ありました。
- 「2年続けている」。メモは「始めて2年目かな」です
- 「いろいろ試した中では」。メモは「これが一番楽」だけです
- 「朝の時点で靴が濡れることを前提に」。メモはロッカーに替えの靴下とサンダルを置いている、までです
どれも文をなめらかにつなぐ一言で、読み流すと気づきません。毎回手で照らすのは続かないので、採点の段にやらせます。
確かめていない話が、そのまま読者向けに出た
メモの「青切符?ちゃんと調べてない」は、「まだ詳しく調べていません」という書き手の言葉のまま本文に出ました。青切符は、自転車の交通違反に反則金を科す制度で、2026年4月1日から始まっています。誤りを言い切ってはいませんが、読む人は答えを得られず、印も無いので、調べ忘れたまま公開しかねません。
同じメモに依頼文を付けると、何が変わったか
体験・数字・決まり・うろ覚えを仕分けてから書く依頼文を付けて、もう1本作りました。どちらが依頼文ありかを伏せて、サブエージェントに見比べさせました。サブエージェントは、Claude Code が作業の一部を任せる別のAIで、前の会話の中身を知らない状態で動きます。この記事の見比べ役・読者役・指揮役・各段は、どれも役割の違うサブエージェントです。指揮役は流れ全体を回す役、各段は下書きや採点を1つずつ受け持つ役です。判定は依頼文ありのほうでした。メモに無い体験や数字は足されず、青切符の話は【要確認】の印付きで、公開前に確かめる一覧に回っていました。
弱点も2つありました。書き手が自分で確かめた会社の話にまで印を付けたことと、本文にタイトルが無かったことで、依頼文を1回直して埋めました。
採点が高い記事でも、読者には分からなかった理由
この記事の仕組みの元は、私が記事を書くときに使っている仕組みです。失敗のたびに関門が足されてきたもので、いちばん効いた失敗が、点数と読者の分かりやすさのずれでした。理由は、点数を付けた事実確認の担当(AI)が、材料も経緯も読み込んでいたことにあると私は見ています。読者なら分からない箇所を、分かったつもりで読めてしまうのです。それでも1回目の下書きには誤りが混ざるので、事実確認は要ります。
私の記事で、1回目の事実確認に誤りが出た割合
私が記事を書くときは、手順のファイルを1つ呼ぶと、調査・構成・執筆・事実確認・校正・採点の担当のサブエージェントが順に動きます。
記録を数えると、事実確認の記録がある35本中15本(43%)で、1回目に「要修正」が出ていました。記録のファイルから機械的に拾った数字で、判定したのはAIの事実確認の担当です。この数字を見てしまうと、確認の段を外す気にはなれません。
事実確認の点数と、読者の分かりやすさは別だった
私が使っている記事づくりの仕組みには、2026年10月27日の失敗から足した関門があります。冒頭300字と見出しだけを別のAIに読ませる確認(30秒テスト)を通り、事実確認の担当が付けた品質スコア(10点満点)が7.8〜8.5だった記事が、公開後に「意味が分からないところが多い」と言われた件です。
そこで、記事を知らない新しいサブエージェントに全文と読者の人物像だけを渡す通読テストが足され、読者の得と読みやすさの採点は事実確認の担当から外されました。私の記事で品質の改善を2周以上回したものは3本だけで、平均は7.2から8.2。1本は7.6のまま動いていません。本数が少ないので、傾向と言えるほどではありません。これもAIが付けた点数です。
失敗のたびに、関門を1つずつ足してきた
最後に流す機械チェックは、私が使っている仕組みでは10項目の lint(決まった規則に当たる箇所を機械的に探すチェック)です。この記事で配る check.py(8つを見る)や、9項目の採点表とは別物で、どれも過去の失敗から1つずつ足されたものです。2026-05-31には、見出しの階層を記号の名前で呼ぶ書き手側の言い方が本文に出たので、チェックが足されました。2026-10-06には、冒頭に限定や但し書きが詰まって読者の得が見えなくなったので、冒頭の限定語を数えるチェックが足されました。同じ失敗は、次から機械が止めます。本文の体験は、実際に試したことだけを書いた記録のファイル(体験の台帳)と照らし、台帳に無ければ「要修正(重大)」になります。
記事づくりのハーネスと、人とAIの受け持ち
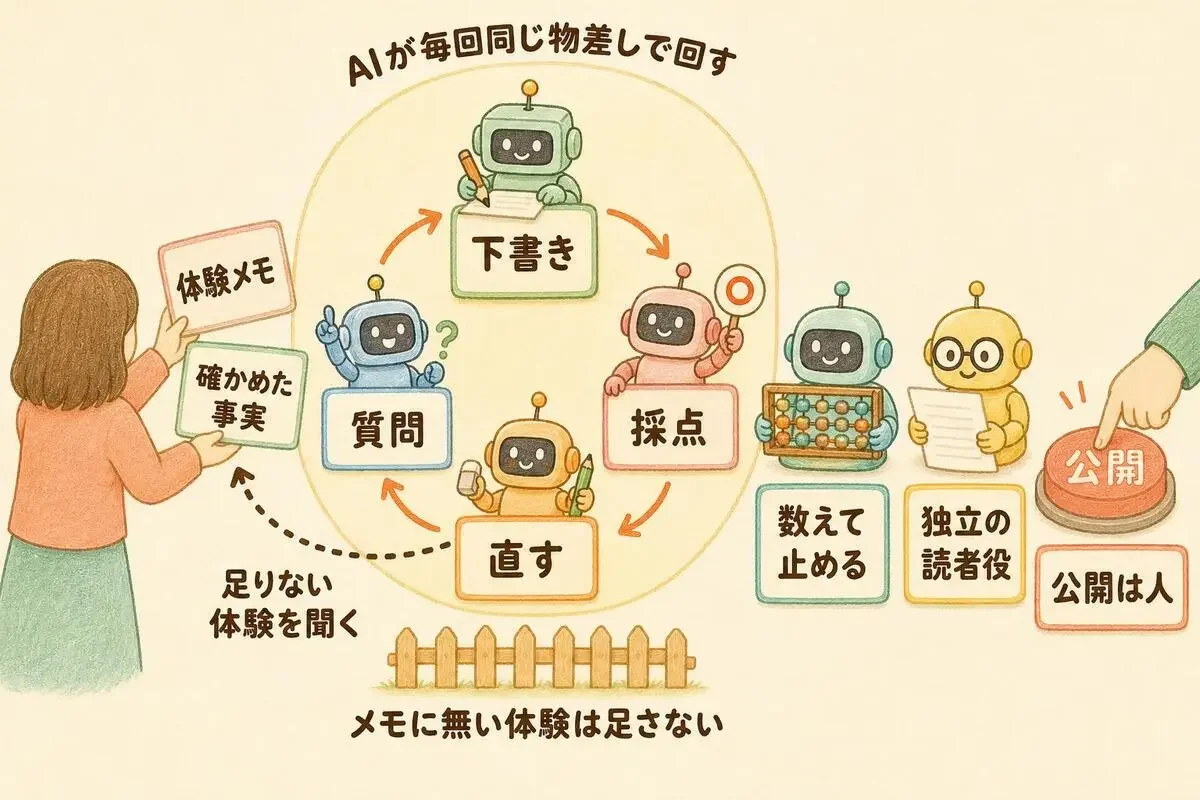
記事づくりのハーネスは、5つの仕掛けでできている
コーディングのハーネスは、ルールやテストでAIの出力を確かめる枠として語られます。記事づくりで違うのは、体験が人からしか来ないこと。仕掛けは次の5つにしました。
- 入力の型: 体験メモ、確かめた事実、書き手の決まりを、決まった欄で渡す
- 禁止のルール: メモに無い体験と数字を足さない。制度や料金を言い切らない
- 評価器(採点する仕掛け): 9項目の採点表と、数えれば分かることを止める check.py(決まった数え方をするプログラム)
- ループ: 採点して直し、足りない体験は質問にして、答えが来たら採点からやり直す
- 独立の判定役: 経緯を知らない、毎回新しい読者役
1と2は依頼文の中に、3は採点の依頼文と check.py に、4は Skill の流れに、5は読者役の文面に入っています。
品質の物差しは、Googleの自己診断の質問から借りる
採点表の9項目のうち、答えの早さと盛りがない以外の7項目は、Google の Creating helpful, reliable, people-first content にある自己診断の質問に対応します。この2つは、素のAIとの見比べと、私が使っている仕組みの失敗から足しました。
Google はAI生成コンテンツのガイダンスで作り方より品質を見るとし、スパムポリシーでは価値を足さない大量生成を不正使用の例に挙げています。
独立の読者役に、自分の記事を読ませてみる
自分の記事は、最初の3行で答えが出ているでしょうか? ハーネスの最後の関門に当たる読者役の文面(398字)で確かめられます。
あなたは、次の人物です: {読者の人物像を1文で。例: 片道6〜10kmの自転車通勤をしている会社員}
いま「{記事が狙っている検索語}」とGoogleで検索し、次の記事を開きました。

- 記事: {記事のファイル。会話に貼るときは「この文面の下に貼った記事」}
- 同じ検索で上位に出ている他の記事の要約: {上位2〜3本のタイトルと要約。無ければ「なし」}

このブログの次の記事も読みたいか(ブックマークやフォローをするか)を判定してください。
- 判定: フォローする / 直せばフォローする / フォローしない のどれか
- 理由と、直してほしい点(具体的に。どの段落のどの文か)
- 比べた他の記事より劣る点・勝る点(上位の要約が「なし」なら省く)
- 検索した疑問に、最初の3行で答えが分かったか

渡された記事と要約だけを読んで判定してください。Web検索はしないでください。- Claude の新しい会話を開く(記事を書いた会話や、指示の入ったプロジェクトは使わない)
- 文面を貼って波かっこを表のとおりに書き換え、その下に本文を貼って送る
- 返ってきた判定のうち、まず「最初の3行で答えが分かったか」を読む
私が10月26日に公開した「メルカリの出品写真、AIで背景を白くするとき傷まで消さない頼み方」で、同じ文面を貼った形で回すと30.5秒で返り、判定は「直せばフォローする」でした。突かれたのは、記事では画像生成を API から使って試したのに、スマホのアプリに同じ依頼文を貼って使えるかが書かれていない点です。「APIは、私には使えません」とまで書かれていて、「スマホのAIで手軽に整えたい」読者に答えていませんでした。
読者役はAIで、本物の読者ではありません。指摘された文を自分で読み直すための道具で、Skill の流れでは最後の判定の段に当たります。
向く人と、向かない人
- 向く人: AIで記事を作っていて、体験と確かめた事実を自分で入れられる人。Claude Code を入れたことがある人
- 向かない人: 記事の数を増やして順位を狙いたい人。体験を入れずに全部をAIに任せたい人
依頼文は、体験が足りないときは書かずに質問だけを返す決まりにしています。公開のボタンも人が押します。
ほかの有料記事と何が違うか
同じ「AIで記事を作る仕組み」を扱う有料の記事や本は、私が確認できた範囲で500円から5,000円でした。表は、2026-11-07時点の各ページの説明から読める範囲です。
読者役が見つけた穴を、次の記事からは書く段で防ぐ。そのための仕掛けと、見本で最後まで回した記録がこの先にあります。依頼文3本と読者役と SKILL.md で約8,000字あり、依頼文と読者役は波かっこを埋めて貼れば使えます。Skill は、記事のコードブロックを Claude Code に渡すと、フォルダに組み立てて置けます。試運転では、AIの時間は約10分でした。検索語と体験メモは先に用意してあったので、人が入ったのは3回です。
ここから先は有料エリア
この先に 17,874文字 / 2画像 が続きます。
¥980
買い切り・追加課金なし
4 人がいいね
Skill「体験メモから記事を書き採点して直す」
この記事は、SkillとしてAIから使えます
Skillは、記事に書かれたやり方を、AIが代わりに進められるようにしたものです。記事を購入すると、AIから使えます。
マイSkillに入れておくと
AimanaVoのSkillで、この体験メモから記事を作って
この記事のやり方で進めます
頼むときに「AimanaVoのSkillで」と添えると、AIが合うSkillを選びます。
- 4
- 0
元ブラック企業社畜。残業100時間超の職場を抜けて、今は普通の会社員。 次は会社そのものから抜ける準備中。AI×副業で試したことを、失敗も含めて書きます
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 1
- 0
-
 江島圭吾
- 6
- 0
-
bokuwalily
- 2
- 0
-
コードを読まないAIエンジニア
- 4
- 0
-
 gen
- 4
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
 梢
- 6
- 0
-
bokuwalily
- 1
- 0
-
 えかさ@データサイエンス解析
- 4
- 0
-
bokuwalily
- 2
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
えかさ@データサイエンス解析
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます