
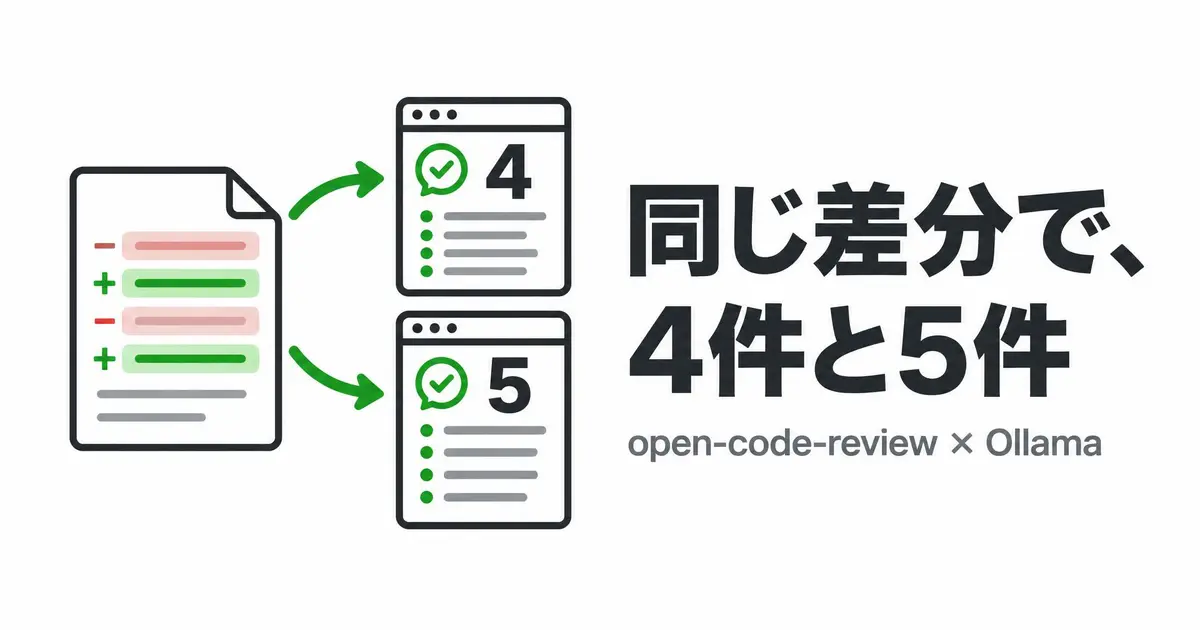
open-code-review(コマンド名は ocr)は、Alibabaがオープンソースで公開しているAIコードレビューのCLIで、gitの差分をLLMに読ませて、直し方つきの指摘を返します。わざと5つの問題を入れた差分を、APIキーを使わず手元のOllamaのモデルで2回レビューさせたところ、1回目は4件、2回目は5件でした。1回目に抜けたのは、カード番号をログに出している行です。
AIで書くほど、コードレビューが詰まりになる
あなたのチームでは、PRがレビュー待ちで何日止まっていますか?
Harvard大学のフィオナ・チェンさんとジェームズ・ストラットンさんが、AIのコーディングツールを入れた会社で仕事の流れがどう変わったかを調べています。2026年11月19日版の論文は、655社・72万542人の作業記録4.45億件(GitHub、Jira、Googleカレンダー。2021年1月〜2026年8月)を使っていて、要旨にこう書いています。
Code review becomes the bottleneck.
コードレビューが詰まりになる、という一文です。補完型の次に出た、作業をまとめて任せられるエージェント型のツールを入れた会社では、レビューに出してからマージまでの時間が56.1%延び、PR1件あたりのコメントは38.6%増えました。書く速さが上がったぶん、待たされる場所がレビューに移ったわけですね。
AIのコードレビューツールは79.1%の会社がすでに入れています。それでもレビューもコメントも大半は人が書いていて、詰まりは消えていません。
数字の扱いで補足を2つ。データはエンジニア組織向けの分析サービスJellyfishが提供したもので、Jellyfishが原稿で確かめたのは機密情報が出ていないかだけ、と脚注にあります。また、これは査読前の原稿で、チェンさんの就職活動用の論文(job market paper)です。8月版の数字を報じた記事もありますが、ここでは11月版の数字を使っています。
人のレビューが詰まっているなら、機械に一次チェックを任せたくなります。問題は、その一次チェックをどこまで信じていいかです。
ocrに5つの問題を仕込んだ差分を渡した
動かしたのは ocr v1.13.13 で、使い捨てのDockerコンテナに入れ、LLMにはMac(メモリ64GB)のOllamaで動かしているNVIDIAの nemotron-3-nano:30b を使いました。
題材は、架空の通販サイトの注文API(src/orders.js)です。「注文一覧にページ送りを足す」という体のブランチに、問題を5つ混ぜました。19行追加・6行削除の小さな差分です。
db.insert の await が抜け、保存の失敗を拾えないconsole.log で出すほかに無害な変更として、JSDocの追加、引数名の size から pageSize への変更、findRecentOrders 関数の追加も入れました。正解を先に決めておくと、見つけた数、見落とした数、行番号のずれをそのまま数えられます。
レビューはブランチの上で ocr review --from main を打つだけです。mainから分かれたあとのコミットが対象になります。
ocrの1回目は4件、カード番号のログを見落とした
1回目は181秒で終わりました。出力の全文です。
Review complete: 4 finding(s) across 1 selected item(s).

─── src/orders.js:0-0 ───
[bug · high] Potential SQL injection vulnerability in findOrdersByCustomer. The customerId is
concatenated directly into the query string instead of using parameterized queries.

- return db.query("SELECT * FROM orders WHERE customer_id = '" + customerId + "'")
+ return db.query('SELECT * FROM orders WHERE customer_id = ?', [customerId]);


─── src/orders.js:30-30 ───
[bug · high] The comparison for coupon expiration is inverted; it should apply discount when the
coupon is still valid (expiresAt > Date.now()), not when it has expired.

-     if (coupon && coupon.expiresAt < Date.now()) {
+     if (coupon && coupon.expiresAt > Date.now()) {


─── src/orders.js:37-37 ───
[bug · high] The DB insert operation is not awaited, which may lead to the order not being persisted
before proceeding.

-     db.insert('orders', order);
+     await db.insert('orders', order);


─── src/orders.js:12-12 ───
[bug · medium] Pagination slice calculation adds an extra element (+ 1) which may return one more
item than intended.

-     return items.slice(page * pageSize, page * pageSize + pageSize + 1);
+     return items.slice(page * pageSize, page * pageSize + pageSize);
SQL、クーポン、await、ページ送りの4つは当たっていて、どれも - と + の行で直し方まで付いています。無害な変更には一言も触れておらず、誤検知は0件。ここまでは優秀です。
引っかかったのは2点です。カード番号をログに出す42行目に、何も言っていません。そしてSQLの指摘だけ場所が src/orders.js:0-0 で、行番号が出ていない。PRの該当行にコメントを貼る使い方なら、この1件は行き場を失います。
この結果だけ見たら、マージしてしまいませんか? 4件を直せば、見た目はきれいなPRになります。それでもカード番号は、平文でログに残ったままです。
実行ログを見ると、1回目は結果を出す前の絞り込みで指摘が1件外されていました。どの指摘だったかは、ログには出ていません。ocr review --help には、この絞り込みを止める --no-filter というオプションも載っています。
ocrの2回目は、同じ差分とモデルで5件とも当てた
設定も差分も変えずにもう一度流すと、176秒で5件が返ってきました。1回目と違う2件だけ抜き出します(抜粋)。
─── src/orders.js:16-16 ───
[security · high] Potential SQL injection: customer_id is concatenated directly into the query
string. This can allow malicious input to alter the query.

-     return db.query("SELECT * FROM orders WHERE customer_id = '" + customerId + "'");
+     return db.query('SELECT * FROM orders WHERE customer_id = ?', [customerId]);

─── src/orders.js:42-42 ───
[security · high] Logging credit card number may expose sensitive data; avoid logging sensitive
fields.

- console.log('charge start', order.id, order.card.number);
+ console.log('charge start', order.id); // avoid logging sensitive data
カード番号のログを拾い、SQLの行番号も16行目と正しく出ました。残りの3件も含めて5件とも行番号が合っていて、誤検知はこちらも0件です。SQLの指摘の分類も、1回目の bug から security に変わっています。
同じモデル、同じ入力でも、ローカルモデルの答えは毎回ぶれます。今回は、そのぶれが「カード情報の漏えいに気づくかどうか」に出ました。使った量は1回あたりおよそ3.5万トークンで、2回とも同じくらいです。
ClaudeのSonnetは、5件に提案3つを足してきた
比べる相手として、同じ差分と src/orders.js をClaudeのSonnetに渡し、「このプルリクエストの差分をコードレビューして」と頼みました。Claude Codeの /code-review コマンドを使ったわけではありません。Sonnetに差分とファイルを読ませただけのレビューです。
Sonnetは5件とも見つけ、行番号も全部合っていました。ocrとの差は書き方に出ています。カード番号の件は「平文でログに残る(PCI DSS違反)」と影響まで書き、SQLの件は ' OR '1'='1 で他人の注文を全件取れる、と攻め方まで示していました。
提案の3つは、全件をメモリで並べ替えるので件数が増えると遅いこと、coupon.amount が負の値だと合計が増えること、そしてテストが無いことでした。テストについてはこう書かれています(抜粋)。
8. テストがない
   paginate、calcTotal、findRecentOrders の変更に対するテストが差分に含まれていない。上の1〜5はテストがあれば検出できた。
私はこの指摘にいちばん同意します。少なくともページ送りとクーポンの2つは、単体テストがあればレビューに回る前に落ちていたはずです。
ただ、この表を「ocrよりClaudeが上」と読むのは早いです。片方は手元で動く30Bクラスのモデル、もう片方はクラウドのSonnetで、モデルの大きさがまるで違います。Sonnetは1回しか流していないので、ぶれの幅も分かりません。読み取れるのは、手元の小さめのモデルに任せると、1回ごとの結果が揺れるという点までです。
open-code-reviewをAPIキー無しで動かすには?
先に1つ注意があります。READMEにあるとおり、ocr review はocr自身のプロバイダ設定を使うので、Claude CodeのTeamやProのログインでは動きません。APIキーを用意するか、今回のようにローカルのモデルに向けます。Claude Codeなどのエージェント側のモデルにレビューを任せる delegation mode もありますが、その場合はocrの処理を全部は通らない、とREADMEに書かれています。
インストールは npm install -g @alibaba-group/open-code-review で、約2.6秒で入りました。ocr llm providers を打つとanthropic、openai、gemini、deepseek、openrouterなど30の組み込みプロバイダが並びますが、手元のOllamaは入っていません。そこで、接続先のURLを自分で指定する custom provider として登録します。打ったのは次の5行です。
ocr config set provider local-ollama
ocr config set custom_providers.local-ollama.url http://host.docker.internal:11434/v1
ocr config set custom_providers.local-ollama.protocol openai
ocr config set model nemotron-3-nano:30b
ocr config set custom_providers.local-ollama.api_key ollama   # Ollamaは中身を見ないダミー値
api_key の ollama はダミー値です。Ollamaは中身を見ませんが、custom provider は空の api_key を受け付けないので、何か入れておきます。URLの host.docker.internal は、コンテナの中からホストのMacのOllamaを呼ぶための名前です。Macで直接動かすなら、公式docsの例どおり http://127.0.0.1:11434/v1 になります。設定は ~/.opencodereview/config.json に保存されました。
つないだら ocr llm test で確かめます。44秒かかって、最後にこう出ました(抜粋)。
I am open-code-review, an open-source code review assistant developed by Alibaba.
✓ Connection test successful
✓ Tool-call round trip verified
3行目が大事です。ocrはレビュー中に、LLMからファイルの読み込みなどの道具を呼ばせる仕組み(tool calling)を使います。これに対応していないモデルだと指摘が0件になる、とFAQにあり、例として deepseek-r1 が挙がっています。Ollamaでモデルを選ぶときは、tools の印が付いたものから選びます。
もう1つ、ocrはGit 2.41以上が前提です。今回のコンテナはGit 2.39.5で、警告は出ましたが、レビューは最後まで動きました。
ローカルのAIコードレビューは、1回の結果で安心しない
手元のモデルでocrを回すなら、私は同じ差分を2回流して、指摘を足し合わせて読みます。1回およそ3分なので、2回でも6分です。決済、認証、個人情報に触る差分は、さらに別のモデルにも見せます。今回1回目で抜けたのが、ちょうどカード情報の行だったからです。
そのうえで、ocrをローカルで回して得をする場面は2つあると考えています。
- コードを外部のAPIに出せないリポジトリ。READMEによると、ocrは差分だけでなく、ファイル全体を読んだりリポジトリ内を検索したりします。クラウドのLLMに向ければその中身も送られますが、Ollamaに向ければ、LLMに渡すコードの行き先は手元のマシンだけです。利用状況を送るテレメトリも、既定ではオフになっています
- 人のレビューに回す前の一次チェック。今回は2回とも誤検知が0件で、無害な変更には黙っていました。await抜けや条件の逆転のような機械的なミスを、直し方つきで先に落としてくれます
逆に、ocrの1回の結果を、マージ前の最後の関門にするのはやめておきます。論文が示していたのも、AIのレビューツールを入れても、人のレビューの詰まりは消えていないということでした。機械に減らしてもらうのは、人が見る前に落とせるミスの数です。最後の目は、まだ人に残ります。
あなたのリポジトリで、外に出せない差分はどれくらいありますか? 思い当たるなら、次のPRで、上の5行を打ってから ocr review --from main を2回流してみてください。2回の結果が食い違ったところが、人がいちばん丁寧に読むべき場所です。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 棚島(たなしま)
- 4
- 0
-
 gen
- 5
- 0
-
 ここな
- 4
- 0
-
 カイ@プロダクトマネージャー
- 5
- 0
-
 みほ
- 2
- 0
-
棚島(たなしま)
- 5
- 0
-
棚島(たなしま)
- 6
- 0
-
クロージング師匠
- 6
- 0
-
AI脱社畜
- 3
- 0
-
 あおいパスタ
- 6
- 0
-
 ネココ
- 8
- 0
-
 Baton Design
- 7
- 0
-
 寺ちゃん@AI・ライティング講師
- 5
- 0
-
 春凪一
- 9
- 0
-
カイ@プロダクトマネージャー
- 5
- 0
-
寺ちゃん@AI・ライティング講師
- 5
- 0
-
ネココ
- 6
- 0
-
 もえ@丁寧な生活
- 6
- 0
-
 千賀
- 4
- 0
-
 江島圭吾
- 6
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます