
AIにコードの脆弱性を探させると、Criticalがずらりと並んだ結果が返ってきて、受け取った側はどこから読めばいいのか分からなくなります。Googleが公開したOSSのmantisには、この重大度の水増しを抑える仕組みがあり、その設計を報告書を書く側の目線で読んでみました。読み終えて残ったのは、何件見つけたかより、人が最後に何を確かめるかという話でした。
AIが出したCriticalが300件並んだ報告書、受け取る人はどこから読みますか?
Criticalが300件出ました、と言われて嬉しい診断員はいないんですよね。300件はたとえ話ですが、全部の重大度が高い報告書は、どれも高くないのと変わりません。赤一色の画面を前に、どれが本当に危ないのかを探すところから始めることになります。1件目を開く前にもう疲れていませんか?
mantisのREADMEは、この問題を名指ししています。概要にある13項目の箇条書きのうち、11番目が較正(calibrate)です。LLMによる重大度の水増し(原文は "LLM inflation of severity")と戦う工程で、何千件ものCriticalを吐き出す代わりに、最も重大なリスクを人に見せるためのものだと書かれています。
mantisはGoogleがGitHubで公開したApache-2.0のOSSで、AIエージェント向けのスキル群と、ADK(Agent Development Kit)で組んだ参照用の実行環境のセットです。READMEは、公式サポートの製品ではなく、デモ目的で本番利用は想定していないと明記しています。課題管理ツールのMantis Bug Trackerとは別物です。
わたしが読んだのはREADMEと4つのSKILL.md(calibrate、critic、reproduce、report)、較正ルールの一覧ほかリポジトリ内の資料で、手元で動かした話はしません。mantisがCriticalと呼んでいい条件は、診断の現場の感覚よりかなり厳しめでした。
mantisがCriticalと呼ぶのは、どんな脆弱性なのか?
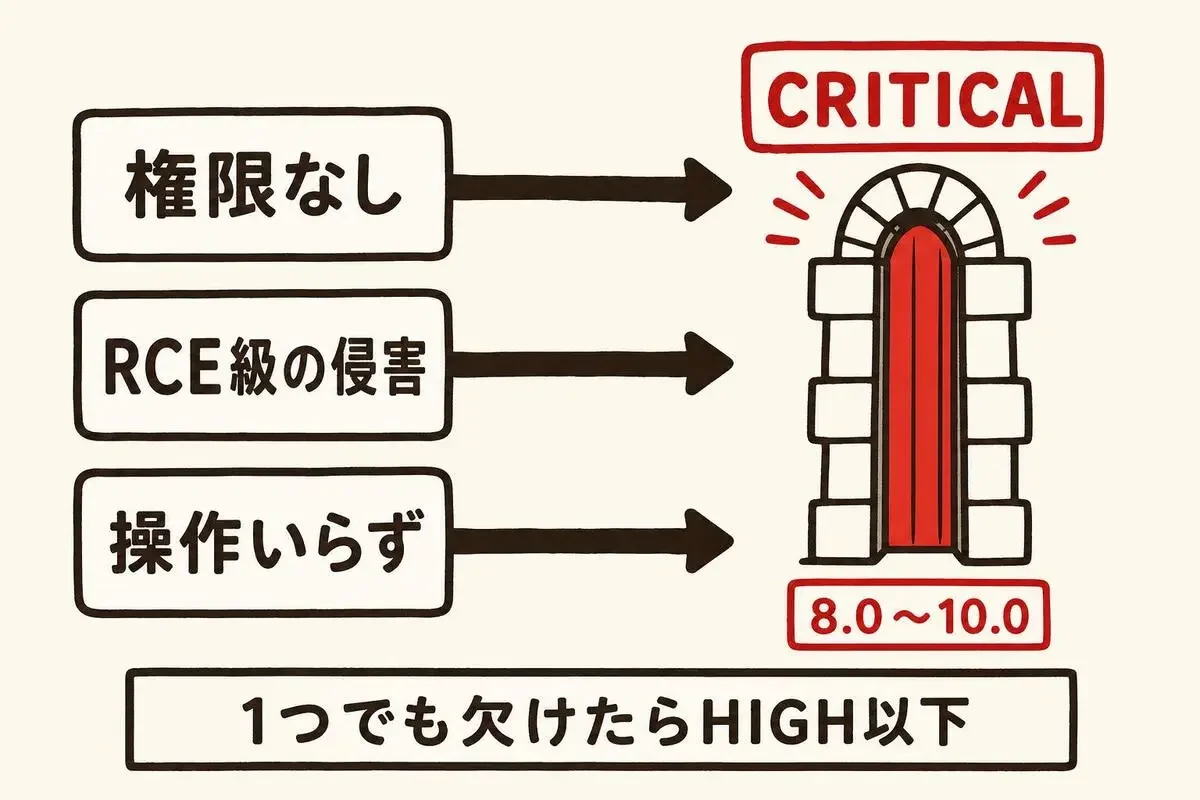
mantis-calibrateは、検出された脆弱性の候補(mantisの用語ではfinding)ごとに10点満点のスコアを付け、4段階の優先度に振り分けます。
CRITICALを名乗れるのは、権限を持たない攻撃者によるリモートコード実行(RCE)か同等の全面的な侵害で、しかも利用者の操作が一切いらない場合だけです。狭い門ですよね。
判断の芯は、攻撃者がもともと持っている権限や立場から、新しく何を得られるかという物差しです。管理画面に入れる人が、脆弱性を突いて、画面から普通にできる設定変更をしても、新しく得たものはありません。そういうときは、計算上の点が高くても上限で押さえます。mantisはこれを Marginal Capability と呼び、較正ルールを27個(LOWへ強制的に落とすものが11個、HIGH止まりとMEDIUM止まりが8個ずつ)用意しています。
管理者でログインしないと成立しないRCEに、診断する人ならどの重大度を付けるでしょうか? high_privilege_external は、インターネットから届く画面でも、高い権限が前提の悪用(原文の例は管理者のRCE)をMEDIUM止まりにします。例外は、コンテナの外のホスト側へ抜ける場合と、別のテナントに届く場合です。
strict_xss はさらに踏み込みます。XSSは原則MEDIUMかLOWで、HIGHに届くのは、重要な管理画面へのstored XSSで、管理者が何も操作しなくても発火する場合だけです。
評判への影響をスコアに混ぜない点にも共感しました。報告会で「これ、ニュースになりますか?」と聞かれても、危険度と世間の反応を1つの数字にすると、優先順位の理由を説明できなくなるんですよね。calibrateは反発の大きさをコメントに書かせるだけで、数値には入れません。
受け取る人にとって、XSSが最初からMEDIUMやLOWで出てくるのは親切でしょうか、物足りないでしょうか? READMEも、リスクの較正は自分たちの環境と許容度に合わせて調整するよう強く勧めていて、基準は叩き台という立て付けです。
再現できなかった脆弱性は、報告書から消していいのか?
報告書に「再現できませんでした」の一行だけがあって、問題なしなのか、試せなかっただけなのか、読んでも分からない。受け取る側なら、そんな場面に覚えがあるかもしれません。
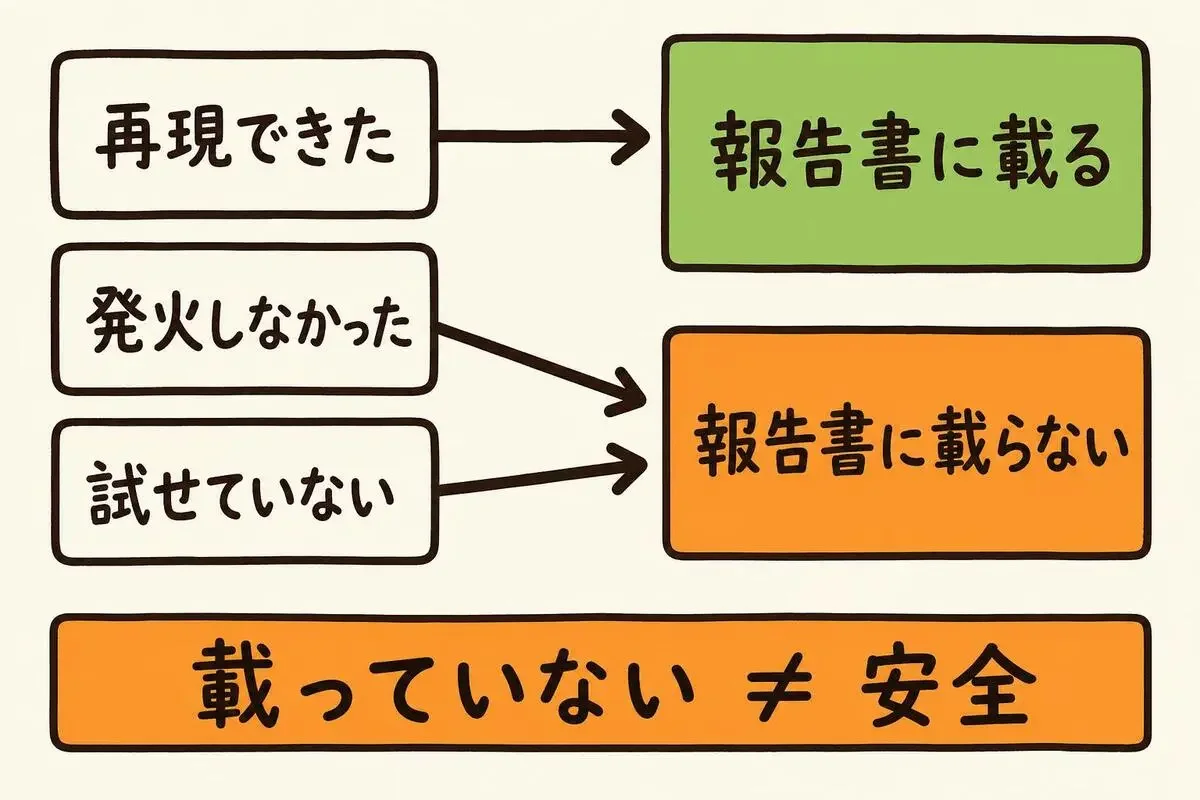
mantis-reproduceは、隔離したサンドボックスで再現用のスクリプトや入力を作って動かし、結果を4つに分けます。
- 再現できた(
reproduced) - 環境の都合で動かせず、コードから見て明らかと判断した(
statically_confirmed、SKILL.mdは最後の手段と位置づけています) - 動かしたが発火しなかった(
failed_to_reproduce) - 環境構築の失敗などで試せていない(
not_attempted)
ここ、いちばん面白いところなんですよね。mantisは「試したが発火しなかった」と「脆弱な箇所まで届かなかった」を、はっきり別物として扱っています。SKILL.mdは、到達した証拠がないまま failed_to_reproduce にするなと指示し、ビルド失敗などから出た否定的な結果は再試行の枠を食いつぶし、本物のバグを黙って落とす、と理由を書いています。
診断の報告書でも、再現できなかったことと発生しなかったことは書き分けます。混ぜると、受け取る人は「問題なかった」と読んでしまうからです。試せなかったものが、静かに「安全」へ化けます。
calibrateの repro_failure は、再現失敗と未試行をLOW上限に落とします。static_confirmation は、コードから判断しただけのものの発生可能性を3で頭打ちにし、スコアに0.8を掛け、CRITICALにはしません。
mantis-reportのSKILL.mdによれば、最終レポートに載るのは、再現できたもの、攻撃の連鎖(exploit chain)、実行の証拠つきで静的に確かめたものです。発火しなかったものも、試せていないものも、この条件には入りません。LOWは本体から外れ、末尾の「Appendix: Low Priority Findings」に集められます。レポートの工程が書き込むのはレポートのファイルだけで、わたしが読んだ範囲では、findingを削除する記述は見つけていません。
一方でREADMEは、自動で再現できなかったとしても誤検知と確定したことにはならず、再現できた場合もどの環境でも攻撃できる保証にはならない、と書いています。診断報告書に「再現できなかった」と書かれた脆弱性を、受け取る人は「安全だった」と読んでいませんか?
わたしはこれを役割分担だと解釈しています。ツールは報告書の上に載せるものを絞り、下や外に回ったものを拾い直すのは人の仕事です。この設計意図をmantis側が説明した文言は、わたしが読んだ範囲では見つかっていません。だから診断する側が、載っていないものは安全という意味ではない、と書き添えたいところです。
付録に回ったLOWの一覧まで、最後まで目を通す人はどれくらいいるでしょう?
確かめていないAI報告を、OSSメンテナへ送ったらどうなるか
READMEには、インストール手順より前に「RESPONSIBLE USE」の囲みがあります。AIモデルは結果が毎回同じとは限らず、存在しない脆弱性をでっち上げることもある。だから報告前に、すべてのfindingをセキュリティの専門家が人の手で確かめること。確かめていないAI生成の報告を、OSSのメンテナに大量に送りつけないこと。そう書かれています。
確かめていない報告を受け取った側は、再現手順を自分で組み直し、重大度を自分で付け直すことになります。自分が受け取る側だったら、確かめていない報告が1日に何十件も届いたとき、どれから開きますか?
ツールが見つけた、というだけでは報告する理由になりません。報告する人が自分で確かめて、はじめて報告になるんですよね。
mantisを試すとき、最後に人が見るのはどこか
動かす前に、READMEの最上段の警告を読んでおきたいところです。自律的に生成したコードを実行するので、隔離した環境でだけ使い、本番システムや機密データ、社内ネットワークにつながるマシンでは動かさないこと、という内容です。概要の終わりには、最新のフロンティアモデルを使うなら、抜け出そうとする動きを強く監視するサンドボックスをもう1層足すべきだ、とも書かれています。
動かしたあとに人が見るところは、SKILL.mdを読んだ限りでは次のあたりかなと思います。
- findingのJSONの
repro_status。載っていないものが、発火しなかったのか、試せなかったのか sanity_triage_appliedの「Incomplete Calibration (UNKNOWN: …)」。人の確認が要る合図で、判定できなかったルールでは上限も降格もかからず、点は高いまま残ります- 付録に回ったLOWの一覧
- THREAT_MODEL.md の Calibration Overrides(原文の例は
LIFT_CAP: PHYSICAL_LONG_TERMのみ)。XSSの扱いを変えたいなら、較正ルールそのものに手を入れる前提になりそうです
検出率や誤検知率の実測結果は、わたしが見た範囲ではリポジトリの中に見当たりませんでした。どれだけ見つかるかは、自分のコードで確かめるしかありません。
ツールが出したCriticalの数より、付録まで読み切った人の数で報告書の質が決まるとしたら、診断する人は何を変えますか?
何件見つけたかより人が最後に何を確かめるか、そこがmantisの設計の芯というのがわたしの読みです。まずは手元の小さなリポジトリを隔離した環境に置いて動かし、付録に回ったLOWまで目を通すところからかなと思います。
- 2
- 0
受託でWebアプリの脆弱性診断を15年。報告書の重大度をどう付けるかで毎回悩んできた診断リーダーです。AIセキュリティツールの新着を「人が最後に何を確認するか」の目線で読み、現場で使えるかどうかを正直に書きます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 1
- 0
-
 ぬまた
- 3
- 0
-
 Mako
- 3
- 0
-
 三枝
- 4
- 0
-
 トロメ
- 4
- 0
-
 Tonbo
- 4
- 0
-
 Brio
- 3
- 0
-
 にくたま
- 5
- 0
-
 村井
- 6
- 0
-
 みどり
- 6
- 0
-
 ケケス
- 3
- 0
-
 千賀
- 4
- 0
-
 しげ
- 4
- 0
-
 Nao
- 3
- 0
-
 トトキ
- 5
- 0
-
 Nina
- 4
- 0
-
 Nopecrumb
- 3
- 0
-
 にふだ
- 3
- 0
-
 dimlight
- 5
- 0
-
 棚島(たなしま)|フォロバ100
- 5
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます