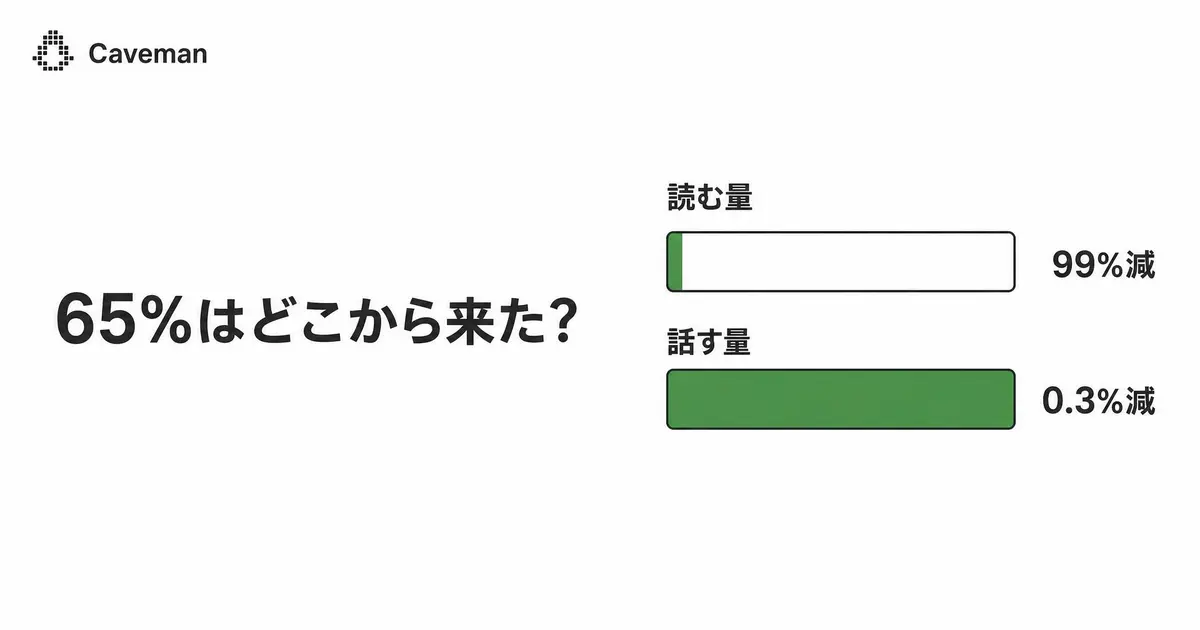
cavemanのGitHubページで「65%削減」を見て、入れるかどうか決めかねている人は多いと思います。先に結論を書くと、ログやCSVを読ませる圧縮は手元で99%前後まで減り、埋めた異常の行も残りました。一方、話し方を変えるSkillは「簡潔に答えてください」の一言と3トークンしか違いませんでした。しかも65%という数字は、README本文のどこにも書かれていません。
cavemanの65%は、どこに書いてあるのか?
リポジトリの説明文には「cuts 65% of tokens」とあります。ところがREADMEには65%が一度も出てきません。掲げている数字は次の3つです。
- プロキシ経由でClaude Codeの入力トークンが33.2%減(54回の実行、18問中18問正解)
caveman browseでウェブページが129.8分の1- caveman調の出力で1.4〜2.4倍安い(Adobe Researchの研究)
Skillの数字はもっと控えめです。READMEの表では、claude-opus-5-5に開発の質問10問を答えさせた出力トークンが、指示なし6,983、Answer concisely. の一言で4,334、/caveman で4,119、/ultracave で2,693でした。READMEは、新しいモデルは簡潔にと言えば通じるのでそれが本当の基準だと書き、そこからの上乗せを /caveman は中央値で3%、/ultracave は35%としています。
65%の出所は、以前のREADMEにあった10問の表です。比較の相手が指示なしだったため、「簡潔に」と頼むだけで出る効果までSkillの手柄に数えていました。作者は2026年9月にこの表を取り下げ、現行のREADME本文に65%はもうありませんが、説明文には数字が残ったままです。
33.2%は入力の話、3%は出力の話で、測っているものが違います。数字を並べても答えは出ないので、読む側と話す側を分けて手元で計りました。引いたREADMEは2026年10月4日のコミット 6571943 時点のものです。
caveman CLIのトークン削減を、自作のログとCSVで計る
計った環境と、最初に止めた利用統計
動かしたのは使い捨てのDockerコンテナ(node:22-bookworm、Node.js v22.23.3、linux/arm64)で、APIキーもClaudeのログイン情報も渡していません。CLIは @caveman-ai/cli 2.0.1、トークンはREADMEと同じtiktokenの o200k_base で数えました。
インストールは npm install が2秒、caveman setup --install が21秒です。アカウント無しでローカルの圧縮機能が動きました。
READMEによると、CLIは既定で、実行したコマンド、トークン数、ランダムなインストールID、OS、IPを送ります(プロンプト、コード、ファイルパスは送らないとあります)。caveman telemetry off を打つと "telemetry": "off" と返り、設定は切り替わりました。通信が実際に止まったかまでは確かめていません。READMEによると、Skillのほうは何も送りません。
npm install -g @caveman-ai/cli
caveman telemetry off
caveman setup --install

# ファイルを圧縮する
caveman compress < app.log

# コマンドを実行して、その出力を圧縮する
caveman shrink -- node --test price.test.js

# 圧縮前の元データを取り出す
caveman retrieve <recovery_handle>
異常を1つ埋めたデータで計った削減率
データはcaveman側のベンチ用ファイルを使わず自作し、どれにも、エージェントに見つけてほしい異常を1つだけ埋めました。
shrink で実行)compress の所要時間は1ファイル113〜293msでした。「99%も削って、肝心の行は消えないの?」と思いますよね。ログの圧縮後は、正常なGETの山を1行の要約に畳み、先頭と末尾の数行とERRORの行を原文のまま残しています。
… 1025 lines elided (caveman): all method=GET status=200; path: /healthz×225 /api/search×220 /api/users/me×206 /assets/app.js×190 /api/articles×184; +2 omitted …
2026-10-04T03:12:35.123Z ERROR req_id=7f3a91c2 method=POST path=/api/checkout status=500 dur_ms=3012 err="PG::ConnectionBad: remaining connection slots are reserved" pool=5/5
1,500行から1件のエラーを探させる用途や、売上CSVから金額の外れた行を探させる用途なら、99%減っても答えに要る行は残ります。
READMEと違った点も2つありました。READMEの表ではHTMLが「none yet」(未対応)ですが、CLI 2.0.1では91.4%減ってタグの無い本文テキストになりました。もう1つは、テスト結果をファイルに保存してから compress に流すと、種類が text と判定されて0%だったことです。同じテストを shrink で実行させると96.3%減ったので、テスト出力は実行ごと包むほうが効きます。
cavemanの圧縮で、何が落ちたのか?
テスト出力では、失敗2件のうち1件目の not ok 138 - price calc case 137 と 274 !== 275、ファイルの位置は残りました。ところが2件目は、テスト名の行が圧縮後に見当たりません。
… 746 lines elided (caveman) …
  error: |-
… 2 lines elided (caveman) …
    522 !== -1
比較した値 522 !== -1 と、末尾の # tests 300 / # pass 298 / # fail 2 は残っています。2件落ちたことは分かっても、どのテストかは圧縮後の出力だけでは分かりません。落ちたテストを直させる場面なら、2件目の名前が要ります。
JSONも同じ形でした。省略部分の要約に role: member×298 admin×1 と出るので、adminが1人いることは分かります。でも、それが user_278 だという情報は消えていました。異常の「有無」は残っても、「場所」は落ちることがあります。
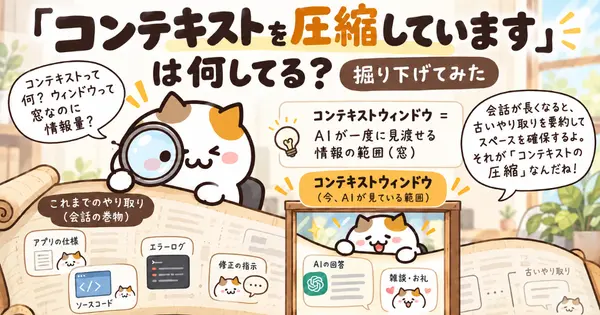
cavemanは圧縮のたびに、"lossless_to_model": false と recovery_handle という識別子を返します。
元データが戻るかも確かめました。JSONを圧縮したときのハンドルを caveman retrieve に渡し、取り出したものを元の users.json と cmp で比べると、1バイトも違いませんでした。モデルに見せる分は削られても、元データは戻せます。
「どのテストが落ちたか」「どのレコードがおかしいか」をエージェントに答えさせる場面では、圧縮後の出力だけで結論を出させないほうが安全です。要約で当たりを付けたら元データを取りに行く手順を、指示に残しておくのが現実的です。
cavemanのSkillと「簡潔に」、差は3トークン
話す側も計りました。Skill本体の skills/caveman/SKILL.md は1,012トークンで、READMEの「毎回の呼び出しに約1,000入力トークンを足す」という注意書きと合います。
質問は日本語の開発の質問5問です(Reactの再レンダリング、RailsのN+1、git rebaseとmerge、PostgreSQLの接続上限エラー、Dockerイメージの軽量化)。Claude Sonnet(Claude Codeのサブエージェント)に3つの条件で1回ずつ答えさせ、APIが報告する出力トークンではなく、返ってきた回答の文章を o200k_base で数えて5問ぶんを合計しました。
減った分のほとんどは「簡潔に」の一言で出ていて、cavemanとの差は3トークン(0.3%)でした。READMEの3%と、同じ形の結果です。この5問では、答えを短くしたいだけなら一言で足りたことになります。
指示なしと比べれば、cavemanは58.1%減です。説明文の65%に近い数字が、手元でも出ました。ただし同じ比べ方をすると、「簡潔に」の一言でも58.0%減ります。65%は嘘ではなく、比べる相手が指示なしだったときの数字だと考えると筋が通ります。
cavemanの回答は「です・ます」が消え、「原因は参照の不一致。」のような言い切りになりました。コード、コマンド、設定名はそのままで、日本語の助詞も削られていません。
一方で、Reactの再レンダリングとPostgreSQLの接続上限の2問では、「簡潔に」の回答に無いコード例やSQLがcavemanの回答に入っていました。全体の長さは、ほぼ同じになりました。
Skillを足す意味はあるのか? この5問に限れば、出力は3トークンしか縮まないのに、ルール本体が呼び出しごとに約1,000の入力トークンを足します。READMEも、GitHub Copilotのプレミアムリクエストのようなリクエスト単位の課金では、短くしても料金は同じなので使わなくてよいと書いています。
ただし、これはClaude Sonnet、日本語5問、各条件1回の小さな計測です。回答の正しさは採点しておらず、長さしか見ていません。キャッシュが効いたときの料金も計っていないので、この範囲での話として読んでください。
cavemanが効くのは読む量で、話す量ではない
ログ、CSV、JSON、HTML、それに shrink で包んだテスト出力は、88.9〜99.1%減りました。話す量のほうは、「簡潔に」の一行に対するSkillの上乗せが0.3%です。
向いているのは、エージェントにログやCSV、テスト出力を何度も読ませている人です。使うなら、テストの実行やログの読み込みは caveman shrink -- で包み、話し方はまず指示に「簡潔に答えて」と1行書くところから始めます。Skillを足すのは、その一行で足りないと分かってからで十分で、リクエスト単位の課金なら要りません。
試していないことも書いておきます。READMEの33.2%は、プロキシでClaude Codeのセッション全体を包んだときの数字ですが、ログインかAPIキーが要るため、認証情報を渡さないコンテナでは動かせませんでした。ファイル単体で99%減っても、会話を含むセッション全体でどこまで薄まるかは、手元では確かめられていません。/ultracave と /megacave、caveman browse、caveman learn、caveman trial も試しておらず、どの計測も試行は1回です。Skillも npx skills add で入れたのではなく、SKILL.md を読ませて従わせた条件で計っています。
インストールは2秒と21秒、アカウントも要りません。手元のテストコマンドを caveman shrink -- で1回包んで、何トークン減ったかと、どの行が消えたかを自分のデータで見てみてください。元のコマンドと同じ終了コードが返り、私が試したJSONでは、消えた分も caveman retrieve で元どおり戻せました。説明文の65%より、そのほうが入れるかどうかの判断材料になります。
- 1
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 Mako
- 3
- 0
-
 三枝
- 4
- 0
-
 Tonbo
- 4
- 0
-
 かやの
- 5
- 0
-
 Brio
- 3
- 0
-
 にくたま
- 5
- 0
-
 みどり
- 6
- 0
-
 ケケス
- 3
- 0
-
 しげ
- 4
- 0
-
 トトキ
- 5
- 0
-
 Nina
- 4
- 0
-
 Nopecrumb
- 3
- 0
-
 にふだ
- 3
- 0
-
 フルイ
- 3
- 0
-
 dimlight
- 5
- 0
-
 棚島(たなしま)|フォロバ100
- 5
- 0
-
 ゆい@海外AI副業ラボ
- 6
- 0
-
コードを読まないAIエンジニア
- 1
- 0
-
 gen
- 1
- 0
-
gen
- 4
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます