
私は普段、ChatGPTやCodexを使って、ちょっとしたWebアプリや便利ツールを作っています。
専門的なプログラミング知識があるわけではないので、やりたいことをAIに伝えて、コードを書いてもらって、実際に動かしてみる。エラーが出たら、そのログをAIに渡して修正してもらう。
基本的にはこの繰り返しです。
そんな作業を続けていると、ときどき表示されるのが、
「コンテキストを圧縮しています」
というメッセージ。
コンテキスト??…まあ、長くなった会話を整理しているんだろうな、くらいには思っていたんですが、具体的には何をしているんだろうとふと思いまして。
そもそもコンテキストとは何なのか。圧縮すると、具体的に何がどうなるのか。
気になったので、ChatGPTにいろいろ聞いてみました。
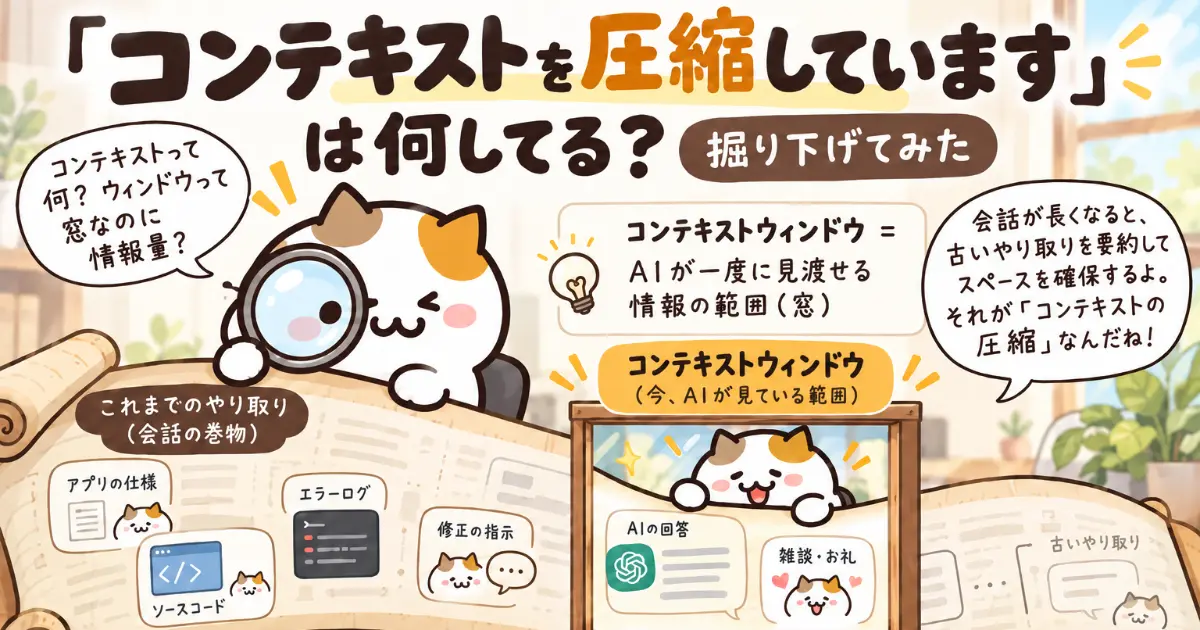
そもそもコンテキストとは?窓なのに情報量?
まず、今回の「コンテキストを圧縮」のコンテキストとは何なのか。
簡単に言うと、AIが回答を考えるときに参考にする情報や、その前後関係の情報のことです。
例えば、これまでの会話やアプリの仕様、貼り付けたソースコードなどもコンテキストに含まれます。
そして、そのコンテキストをAIが一度にどれだけ扱えるか。その範囲を表す言葉が「コンテキストウィンドウ」です。
ちょっと似た言葉が出てきましたね。
直訳すると、
- Context(コンテキスト)=文脈、前後関係
つまり、「文脈を覗く窓」といった意味になります。
でも、窓なのに情報量ってどういうこと?と思いますよね。
ここでいう窓は、パソコンの画面に表示されるウィンドウではなく、AIが一度に見渡せる範囲を表しています。
例えば、長い会話の記録が一本の巻物になっていると想像してください。
その巻物の上に、四角い窓の開いた紙を重ねます。
AIが一度に読めるのは、その窓から見えている部分だけ。
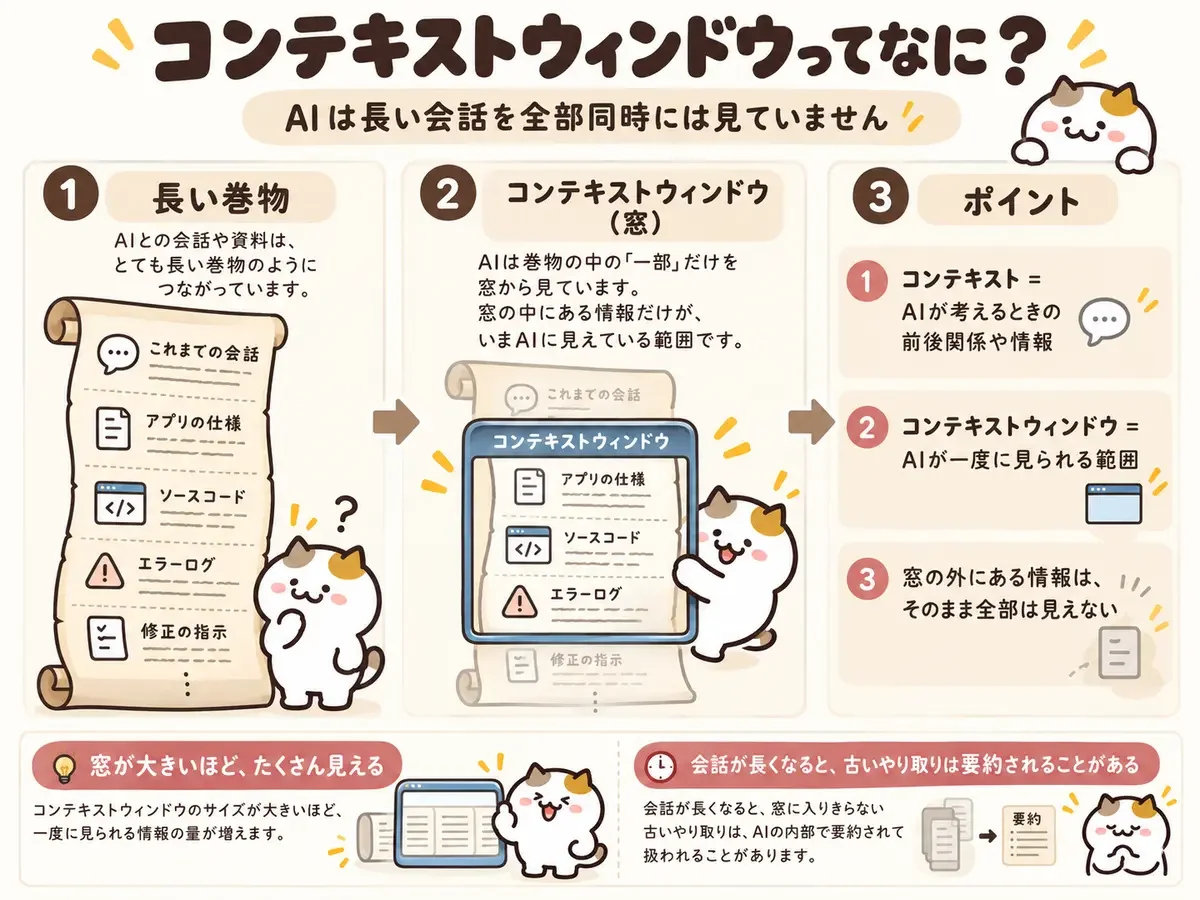
窓が大きければ、より多くの会話を一度に参照できますし、窓が小さければ、見渡せる範囲も狭くなります。
そして、会話が長くなるにつれて、参照する範囲も移動・更新されていきます。
これが「コンテキストウィンドウ」という名前のイメージです。
では、その窓の大きさをどうやって測るのか。
そこで使われるのが「トークン」という単位です。
日本語の場合、1文字=1トークンというわけではありませんし、英語やプログラムコードでも消費量は変わります。
例えば「25万トークンのコンテキストウィンドウ」とは、AIが一度に扱える情報の枠が25万トークン分ある、という意味になります。
そして、その窓の中には、
- 最初に伝えたアプリの仕様
- これまでの会話
- AIが生成したソースコード
- 貼り付けたエラーログ
- 修正の指示
- AIが返した回答
などが含まれます(ほかにもシステム指示などが容量を使用します)。
もちろん、無制限に広がる窓ではありません。
会話が長くなって、窓の中に情報を収めきれなくなりそうになったとき、古いやり取りを短く整理してスペースを確保する。
それが今回のテーマである「コンテキストの圧縮」につながるわけですね。
コンテキストの圧縮は、AIが自分用の引き継ぎメモを作っている
例えば、画像編集ミニアプリを作っているとします。
最初に画像を読み込む機能を作って、次にレイヤー機能、明るさ調整、トーンカーブ、マスク機能……と順番に実装していきます。
当然、最初から全部うまくいくわけではありません。
エラーが発生して、コードを書き直して、また別のエラーが出て……。
そうして何十回もやり取りをしていると、コンテキストには、すでに解決した問題や古いバージョンのコードまで蓄積されていきます。
そのままでは容量の上限に達してしまうため、AIは過去のやり取りを要約し、必要な情報を短い文章にまとめようとします。
これがコンテキストの圧縮です。
例えば、100回のやり取りがあったとしても、圧縮後は次のような情報に整理されるイメージです。
# 開発状況

アプリ概要:
ブラウザ上で動作する軽量な画像編集ツール。

実装済み:
・画像の読み込み
・レイヤー管理
・明るさ、コントラスト調整
・レイヤーマスク

現在の問題:
マスク処理後にUndoすると描画が崩れる。

次の作業:
Undo/Redoの処理を修正する。

注意事項:
既存のUIレイアウトは変更しない。要するに、AIが自分自身に向けて、ここまでの作業の引き継ぎメモを作っているようなものですね。
ただし、これは元の会話を完全に復元できる圧縮ではありません。
どのようなエラーが出ていたのか、なぜその実装方法を採用したのか、以前にどんな細かい指示をしていたのか。
そうした情報は、要約の過程で抜け落ちる可能性があります。
長くチャットしたAIが徐々におバカになっていくのは、この要約の度に抜け落ちる情報のせいということになりますね。
25万トークンって、実際どのくらい?
情報の枠が25万トークンってのは多いのか?少ないのか?
そこで、具体的に画像編集アプリの開発に置き換えて考えてみました。
例えば、アプリのソースコードが以下のような構成だったとします。
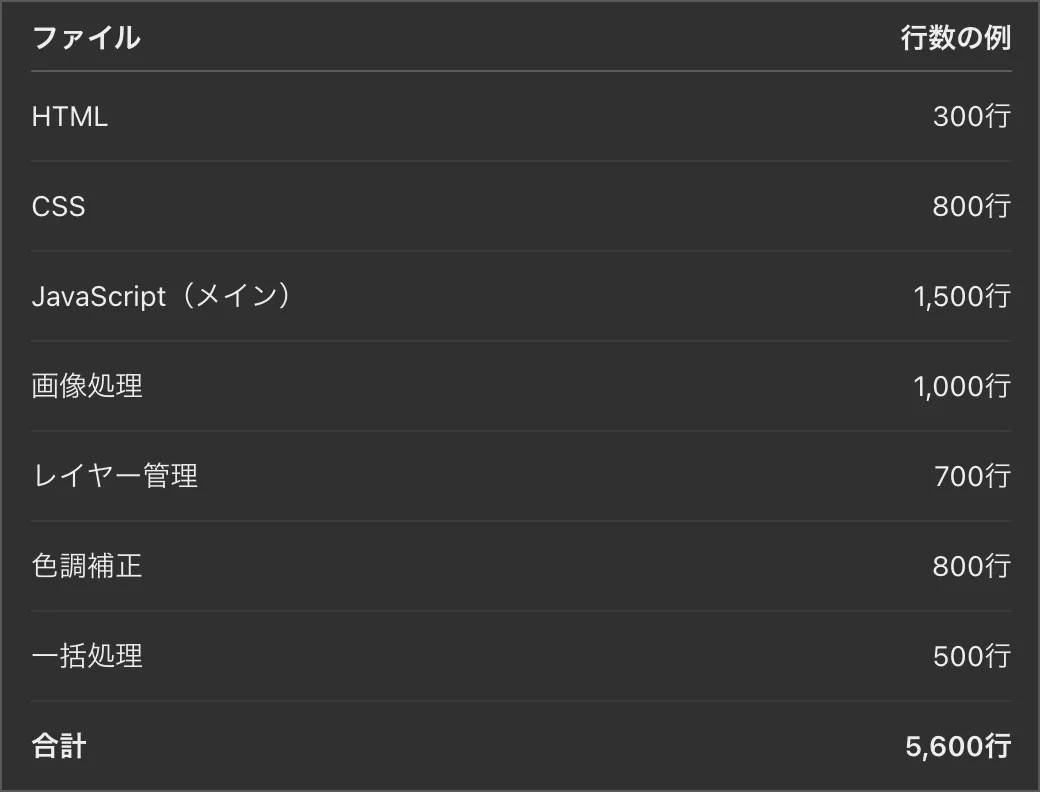
コードの書き方によって変わりますが、この規模なら10万トークンを超えることも十分考えられるとのこと。
25万トークンあれば、まだ余裕がありそうですが、実際は完成コードだけがコンテキストになるというわけではないようです。
AIがコードを全文出力する。修正を依頼する。また全文出力する。エラーログを貼り付ける。さらに修正版を全文出力する。
これらの過去のやり取りもコンテキストに蓄積されます。
例えば、仮に4万トークンのコードを5回全文出力してもらったら、それだけで累計20万トークン相当の情報量です。
もちろん、実際の圧縮タイミングや処理方法は環境によって異なりますが、思っていた以上に容量を消費していることが分かりました。
もしかして、私のアプリ開発のやり方は効率が悪い?
ここで、ちょっと気になったことがあります。
私はエラーが発生したとき、必要な部分だけを選択するのが面倒なので、ターミナルのログを CMD + A で全選択してそのままAIに渡すことが結構あります。
「修正後のコードを全文で出して」
部分的なコードを受け取って、自分で該当箇所を探して置き換えるより、ファイルを丸ごと差し替えた方が楽なんですよね。
これって、コンテキストの無駄遣いなんでしょうか。
ChatGPTに聞いてみたところ、必ずしもそうではないようです。
エラーログは、初回なら丸ごと渡してもいい
例えば、Pythonのエラーログ。
自分では最後の数行だけが重要だと思っていても、その前に表示されている警告や処理の流れが、原因特定のヒントになっている場合があります。
プログラミングに詳しくない人間が、重要そうなところだけを選別した結果、肝心な部分まで削除してしまう可能性もあります。
なので、初回はある程度まとまったログを渡すのも合理的とのこと。
ただし、同じエラーを何度も貼り付けたり、関係のない大量のログまで延々と渡したりするのは、さすがに効率が悪くなります。
ターミナルの出力にはAPIキーやパスワードなどの機密情報が含まれていることがあるので、貼り付ける前に要確認です。
短期開発ならコード全文出力でも問題なし
これも少し安心しました。
例えば、1,000行程度の単一HTMLファイルで作ったミニアプリ。
その一部分を修正するために、変更箇所だけを受け取り、自分で該当するコードを探して置き換える。
これ、慣れていないと結構面倒なんです。
しかも、間違った場所に貼り付けて、別のエラーが発生することもあります(閉じカッコのあるなしでおかしくなったり)。
コンテキストを節約するために、こちらの作業時間が増えてしまうのは本末転倒。
30分〜数時間で完成するようなスポット開発なら、そこまで神経質にならなくてもよさそうです。
一方、何日もかけて開発するようなアプリでは、Codexなどを使って必要なファイルを直接修正する運用の方が効率的ですね。
じゃあ、コンテキストの圧縮で情報が失われる問題はどうする?
調べていて、ここが一番重要だと思った部分です。
コンテキストウィンドウに、長期的な記憶まで全部任せる必要はないんですよね。
例えば、開発中のアプリについて、次のようなMarkdownファイルを別に用意しておく方法があります。
PROJECT.md
  └ アプリの概要・基本仕様

FEATURES.md
  └ 実装済み機能・未実装機能

DECISIONS.md
  └ 過去に決定した重要事項

PROGRESS.md
  └ 現在の進捗・次の作業
こうしておけば、会話が長くなってコンテキストが圧縮されても、必要な情報をファイルから読み直せます。
ChatGPTにも、ProjectsやLibraryといった、コンテキストウィンドウとは別にファイルを保持できる仕組みがあります。
ただし、保存したファイルの内容が、常に全部コンテキストに読み込まれているわけではありません。
イメージとしては、
外部のMDファイル=資料を保管しておく本棚
コンテキストウィンドウ=今、机の上に広げている資料
と考えると分かりやすいかもしれません。
本棚に何百冊の資料があっても、毎回全部を机の上に広げる必要はありませんからね。
また、保存したファイルが会話の内容に合わせて必ず自動更新されるわけでもないので、重要な決定事項は明示的に記録しておく運用が必要です。
ちなみに「ありがとう」もコンテキストの無駄遣い?
コンテキストについて調べているうちに、以前どこかで見かけた話も気になりました。
「AIにありがとうと言うのは、無駄にトークンを消費するだけだからやめた方がいい」
というものです。
確かに、文字を入力する以上はトークンを消費しますし、AIが「どういたしまして!」と返してくれば、その分も増えます。
また、短いお礼であっても、AIへの新しいリクエストが1回発生することになります。
ただ、「ありがとう」という文章自体は、コンテキスト全体からすればごくわずかな情報量です。
少なくとも、何千行ものコードを何度も全文出力させていることに比べれば、そこまで気にするようなものではなさそうです。
それより気になったのが、お礼はAIに対するフィードバックとして機能するのか? ということ。
単に「ありがとう」と伝えるだけでも、AIは直前の回答を好意的に受け取ってもらえたと判断する材料にできます。
ただし、回答が正しかったのか、実際にアプリが動いたのかまでは分かりません。
なので、開発の場合は、
「ありがとう!期待どおりに動いた。これで確定!」
という伝え方の方が、より具体的なフィードバックになります。
さらに、
「レイヤーマスクの不具合が解消した。Undo/Redoも正常。この実装で確定して、次に進もう」
と伝えれば、何が成功して、何を維持すべきなのかも明確になります。
もちろん、その会話だけでAIのモデル自体が学習・更新されるわけではありません。
あくまで、今進めている作業の中でのフィードバックですね。
コンテキストの残量をグラフで見られたら便利なのに
ここまで調べると、今度は現在のコンテキストがどれだけ埋まっているのか、気になってきました。
スマホのストレージ使用量みたいに、
- 過去の会話:30%
- 現在の作業:25%
- ソースコード:20%
- エラーログ:10%
- 残り容量:15%
といった感じで、グラフ化してくれたら分かりやすいのに。
調べた範囲では、通常のChatGPTに、ここまで細かくコンテキストの内訳を視覚化する標準機能はありません。
一方、Codexにはコンテキストの使用状況を確認するための機能があります。
ただ、単純に残量を表示するだけでなく、「この古いエラーログはもう不要」「この仕様だけは最後まで保持したい」といった管理までユーザー側でできると、さらに便利そうです。
今後、そんな機能も増えてくれるとうれしいですね。
まとめ:コンテキストは節約するより、上手に入れ替える
今回いろいろ調べてみて、コンテキストに対する認識が少し変わりました。
これまでは、AIとの会話が長く続けば続くほど、それまでの作業を全部理解してくれているような感覚がありました。
でも、実際にはコンテキストウィンドウの容量に限界があり、必要に応じて過去の情報が圧縮されています。
しかも、圧縮される過程で細かな情報が抜け落ちる可能性もあります。
だからといって、短期的な開発でまでトークンを節約しようとする必要はなさそうです。
私の場合は、今後こんな感じで使い分けようと思っています。
- 数時間で完成するミニアプリ:これまでどおり、ログもコードも気軽に渡す。
- 何日もかけて開発するアプリ:Codexで直接ファイルを編集する。
- 長期的なプロジェクト:仕様や重要な決定事項をMDファイルに残す。
- 作業が一区切りついたとき:進捗を記録して、必要なら新しいチャットに移行する。
コンテキストをずっと使い続けることより、必要な情報を必要なタイミングで読み込めるようにしておくこと。
これが大切なのかなと思いました。
それにしても、AIに「ありがとう」と言うことまでトークンの無駄遣いだと考え始めると、なんだか少し寂しい気もします(笑)
私は今後も普通にお礼を言いつつ、できれば「何が良かったのか」まで伝えるようにしてみようと思います。
#ChatGPT #Codex #生成AI #AI活用 #コンテキストウィンドウ #AIプログラミング #個人開発 #非エンジニア #アプリ開発 #AI初心者
スキ1番乗り!
- 5
- 0
AIで「作れる」人を増やす🐈️|コードが書けなくても、AIと話しながらツールや仕組みは作れる|主にChatGPTのAIエージェントCodexを活用中⚡️|ブログ1200記事→AIで時間を生み出し、副収入を育てて2026年に脱サラ|誰でも再現できる「一人で稼ぐ仕組み」の作り方を発
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 1
- 0
-
 Mako
- 3
- 0
-
 三枝
- 4
- 0
-
 トロメ
- 4
- 0
-
 Tonbo
- 4
- 0
-
 Brio
- 3
- 0
-
 みどり
- 6
- 0
-
 ケケス
- 3
- 0
-
 千賀
- 4
- 0
-
 しげ
- 4
- 0
-
 Nao
- 3
- 0
-
 トトキ
- 5
- 0
-
 Nina
- 4
- 0
-
 Nopecrumb
- 3
- 0
-
 にふだ
- 3
- 0
-
 dimlight
- 5
- 0
-
 棚島(たなしま)|フォロバ100
- 5
- 0
-
- 1
- 0
-
プロンプト画伯
- 4
- 0
-
 gen
- 1
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます