
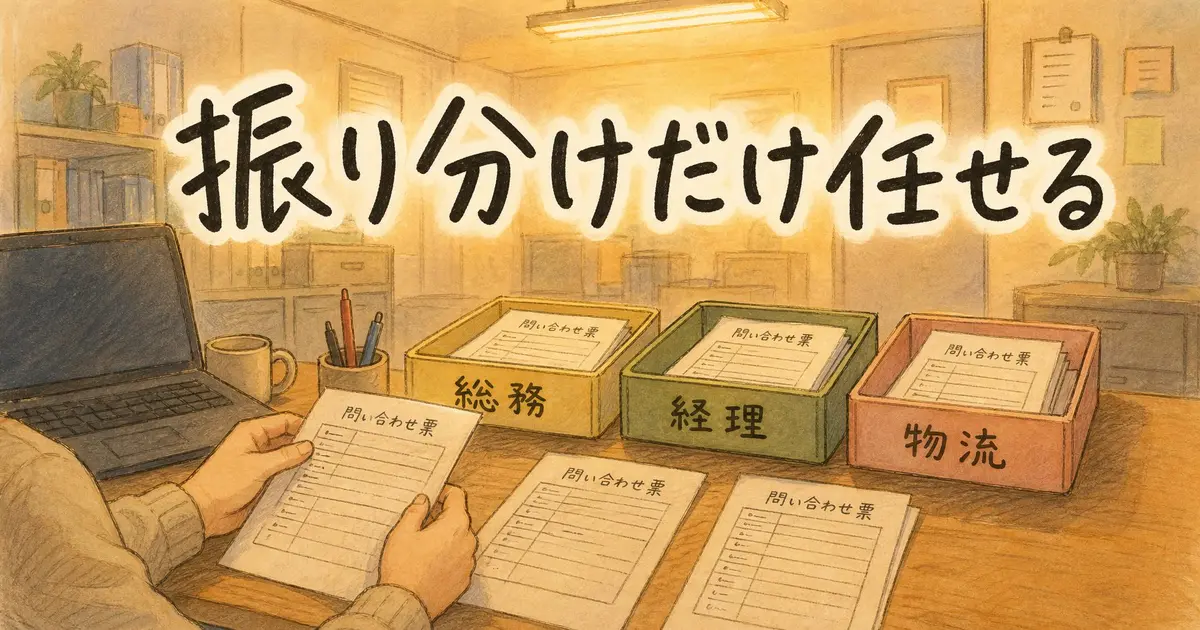
社内の問い合わせ対応で時間を取られるのは、答えを書くことより、どの部署に回すかを決める振り分けのほうだったりしませんか?
月に400件ほど届く問い合わせも、大半は同じ種類の質問で、迷うのは行き先だけなんです。その行き先決めだけをブラウザで動く極小LLMに任せられるのか、MicroLLM Labを材料に、任せてよい範囲と自分のチケットで確かめる手順を書きます。
極小LLMに任せるのは、問い合わせの振り分けまで
MicroLLM Labは、パラメータ数がおよそ2,600万から3億6,000万の小さな言語モデルを、ブラウザの中だけで動かして試せる実験サイトです。インストールもアカウント登録も要りません。9月下旬にHacker Newsへ投稿され、10月4日時点で283ポイントを集めています。
サイトは使いみちの1つとして、問い合わせの分類、スパムの除外、意図の抽出を挙げています。高いクラウドのLLMを呼ぶ必要があるかどうかを、手前で判断する役目という説明です。この説明に、要約や回答文づくりは出てきません。
GitHubのREADMEの注意書きも率直で、「これらのモデルは幻覚を起こす。重要な回答には使わないこと」とあります。一度に扱える長さは2,048トークンまでで、文章の出し方も、毎回いちばん確率の高い語を選ぶ方式(greedy)だけです。
全部をAIに任せる話ではなくて、行き先を決めるだけの話なんです。モデルが出すのは部署名の1語で、答えるのはこれまでどおり担当者。行き先が外れても、回し直せば済みます。
あなたの職場の問い合わせのうち、行き先さえ決まれば半分片づく、という種類はどれくらいありますか?
MicroLLM Labの7モデルは、15MBから216MBまで
公開されているモデルの一覧(カタログ)には7つが載っています。どれも重みを4bitに縮めたQ4という形式で配られていて、サイズと主な言語はこうです。
サイズやライセンスはGitHubのリポジトリにまとまっています。READMEの表には初代のSmolLM 135Mも加わっていて、こちらは8行です。
サイトの説明文には「1億パラメータ級のモデルがブラウザのメモリ上で約50〜84MBに収まる」とありますが、一番大きいSmolLM2 360M Instructは216MBあり、全部入りのzipは589MBです。一度読み込んだモデルはブラウザ内の保存領域(IndexedDB)に残るので、開くたびにダウンロードし直す必要はありません。
速さの表記にも差があります。サイトは最初の1トークンが出るまで10ms未満とうたっていますが、READMEに載っている作者の実測(Apple M4のMacとSafari、「Say hello」への応答)では、PetitGPTが87ms、SmolLM2 135M Instructが227msでした。社内のPCでどのくらい出るかは、Benchmarksタブで実際に測れます。
英語中心の極小LLMに、日本語の問い合わせを入れて大丈夫か?
7つの中に、日本語を想定したモデルは見当たりません。SmolLM2は公式のモデルカードで「主に英語を理解し、生成する」と説明されていて、MiniMind2は中国語寄りです。Hacker Newsのコメント欄にも「英語しか通じない。ドイツ語で聞くとオウム返しになる」という利用者の報告がありました。
日本語の問い合わせをどこまで正しく仕分けられるかについて、公開された測定は見つかりませんでした。ここは未確認のまま、自分で測ることになります。
試すときの工夫は、サイトの中に書いてあります。評価用の問題を大きなLLMに書かせるための指示文に「プロンプトは短く。ASCII(半角英数字)がいちばん安全」とあるので、答えさせるラベルは IT や ACCOUNTING のような英字にしておくのが筋かと思います。
あなたの社内の問い合わせには、システム名や品番などの英数字がどのくらい混ざっていますか? 英数字の手がかりが多い問い合わせのほうが当たりやすいのでは、と私は見ていますが、これも自分のデータで確かめるしかありません。
内蔵ベンチマークの点数は、振り分けの腕前ではない
Benchmarksタブに最初から入っている問題は、1+1のような算数、ベルリンのような首都を答える問題、文中の文字列をそのまま写す問題です。READMEには、SmolLM2 135M Instructが20問中14問、PetitGPTが旧版の14問中10問という結果が載っています。
どちらもApple M4上で作者が測った値で、問い合わせを部署に分ける力を測ったものではありません。この点数が高いモデルほど振り分けも上手い、とは言えないんですよね。
Custom evalなら、自分の問い合わせで振り分けを採点できる
Custom evalタブには、問題と採点方法をJavaScriptで書く欄があります。実行すると、いま選んでいるモデルで全問を解かせ、正答率がCompare & Certificateタブにモデルごとに残ります。
手順はこうです。
- 過去のチケットから件名と本文の冒頭を20〜30件抜き出し、実際に回した部署を正解として横に書く
- 部署名を英字のラベルに置き換える
- 下のコードの
ticketsに並べ、Custom evalに貼って実行する - モデルを切り替えて同じコードを走らせ、Compareの表で見比べる
(() => {
  const LABELS = ["IT", "ACCOUNTING", "LOGISTICS", "SALES", "OTHER"];
  const tickets = [
    { id: "t01", text: "基幹システムにログインできません", answer: "IT" },
    { id: "t02", text: "請求書の再発行をお願いしたいです", answer: "ACCOUNTING" },
    { id: "t03", text: "明日の便の配送時間を変えられますか", answer: "LOGISTICS" },
    // 過去のチケットを、実際に回した部署と一緒に足していく(64件まで)
  ];
  return {
    id: "helpdesk-routing",
    name: "Helpdesk routing",
    maxNewTokens: 8,
    tests: tickets.map((t) => ({
      id: t.id,
      prompt:
        "Classify this ticket. Reply with one word from: " +
        LABELS.join(", ") +
        ". If unsure, reply OTHER.\nTicket: " +
        t.text,
      check: (out) => {
        const m = out.toUpperCase().match(/\b(IT|ACCOUNTING|LOGISTICS|SALES|OTHER)\b/);
        const got = m ? m[1] : "NONE";
        return { pass: got === t.answer, detail: got };
      },
    })),
  };
})
maxNewTokens を8に絞っているのは、部署名の1語さえ出れば足りるからです。制限は、1回の評価セットが64問まで、1問のプロンプトが4,000文字まで、maxNewTokens が1〜256(既定は48)です。出力から正規表現でラベルを拾って正解と比べるだけなので、文章の出来を判定する必要はありません。
この欄のコードは、ページの中で eval() によってそのまま実行されます。他人から渡されたコードを、中身を読まずに貼るのはやめておきましょう。
データの扱いも気になるところですよね。サイトは「入力したデータは端末の外に出ない」と説明していますが、第三者が確かめた資料は確認できませんでした。社外のサイトに業務データを貼る形になるので、個人名や取引先名は消してから使うのが無難かと思います。
うまく動かないときは、まずブラウザを疑ってください。READMEが挙げているのはSafari、Chrome、Edgeで、Hacker Newsには、Linux版のFirefoxで GPUShaderStage is not defined というエラーが出て起動しなかったという報告があります。GitHubから一式を落として手元で動かすなら、index.html を直接開かず、python3 -m http.server などでサーバー経由で開く必要があります。
振り分けの合格ラインは、外れたときの行き先で決める
正答率が何割なら使えるかは、職場ごとに違います。私が見たいのは、数字の高さより外れ方なんです。
外れ方を見るときは、経理宛ての問い合わせが物流に届くような誤配と、迷って OTHER に落ちた分を分けて考えます。誤配は回し直しと返事の遅れを生みますが、OTHER に落ちた分は今までどおり一次対応の手元に戻るだけです。実行後に開くBenchmarksタブの結果表には、問題ごとに detail(このコードでは拾ったラベル)が出るので、この2つを別々に数えておくと判断しやすくなります。
誤配が目立つうちは任せず、外れのほとんどが OTHER なら、当たった分だけ手作業が減る計算になります。どちらに転んでも、最後に回すボタンを押すのは人という前提は変えません。
先週届いた問い合わせのうち、行き先に迷ったものは何件ありましたか? 迷わなかったものと迷ったものを混ぜて30件選び、Custom evalに並べるところから始めてみてください。
- 3
- 0
食品卸の情シス兼ヘルプデスクとして、社内から毎日届く問い合わせをさばいています。小さなAIに答えさせるのでなく、行き先の振り分けだけを任せる方法を、手順と失敗の話つきで書いていきます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 Mako
- 3
- 0
-
 村井
- 6
- 0
-
 千賀
- 4
- 0
-
コードを読まないAIエンジニア
- 1
- 0
-
- 1
- 0
-
 かなえ@脆弱性診断
- 2
- 0
-
- 5
- 0
-
 にくたま
- 6
- 1
-
 gen
- 3
- 0
-
- 1
- 0
-
 さわこ
- 6
- 0
-
- 3
- 0
-
 みほ
- 5
- 0
-
AI脱社畜
- 2
- 0
-
- 5
- 0
-
gen
- 5
- 0
-
- 4
- 0
-
gen
- 3
- 0
-
- 3
- 0
-
 もえ@丁寧な生活
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます