
AIエージェントに実装を任せるようになってから、開発チームで「ユニットテストって、まだ書く意味あるの?」という声を聞くことが増えました。今までのテストとAI時代のテストで何が変わったのか、QAの現場から整理します。先に答えを言うと、ユニットテストは消えません。守る相手が変わるだけです。
全部グリーンのテストが見落とすもの
全部グリーンだったんですよね、あの日も。ある機能の改修で、CIのユニットテストは1本も落ちていませんでした。それなのにリリース前に画面を触ってみると、表示が期待と食い違っていました。
「テストは通ってたのに、なぜ?」って思いますよね。原因は、同じ処理を2回続けて実行したときにデータが重複して取り込まれる流れにありました。データを取り込む関数も、重複を弾く関数も、単体では仕様どおりに動きます。壊れていたのは部品と部品のつなぎ目でした。
テストがグリーンでも、ユーザーが見ている画面まで正しいとは限りません。ユニットテストが保証できるのは、部品が仕様どおりに動くところまでです。このズレは昔からありましたが、AIが実装を書くようになって一気に広がったと感じています。
今までのユニットテストは何を守っていたのか?
従来のユニットテストは、実装した人の不安を消すための道具でした。人が一行ずつ書いていた時代は実装そのものに時間がかかり、間違いも実装の中に紛れていたので、関数単位で細かく押さえる意味が大きかったんです。
E2Eテストは逆に「高くつくもの」扱いでした。画面が変わるたびにセレクターが壊れ、直すのはいつもQA側。だからユニットを厚く、E2Eは主要な導線だけに絞るのが定石でした。手で画面を触って確かめる時間も、実装時間に比べれば小さかったんですよね。
AI時代は検証コストがボトルネックになる
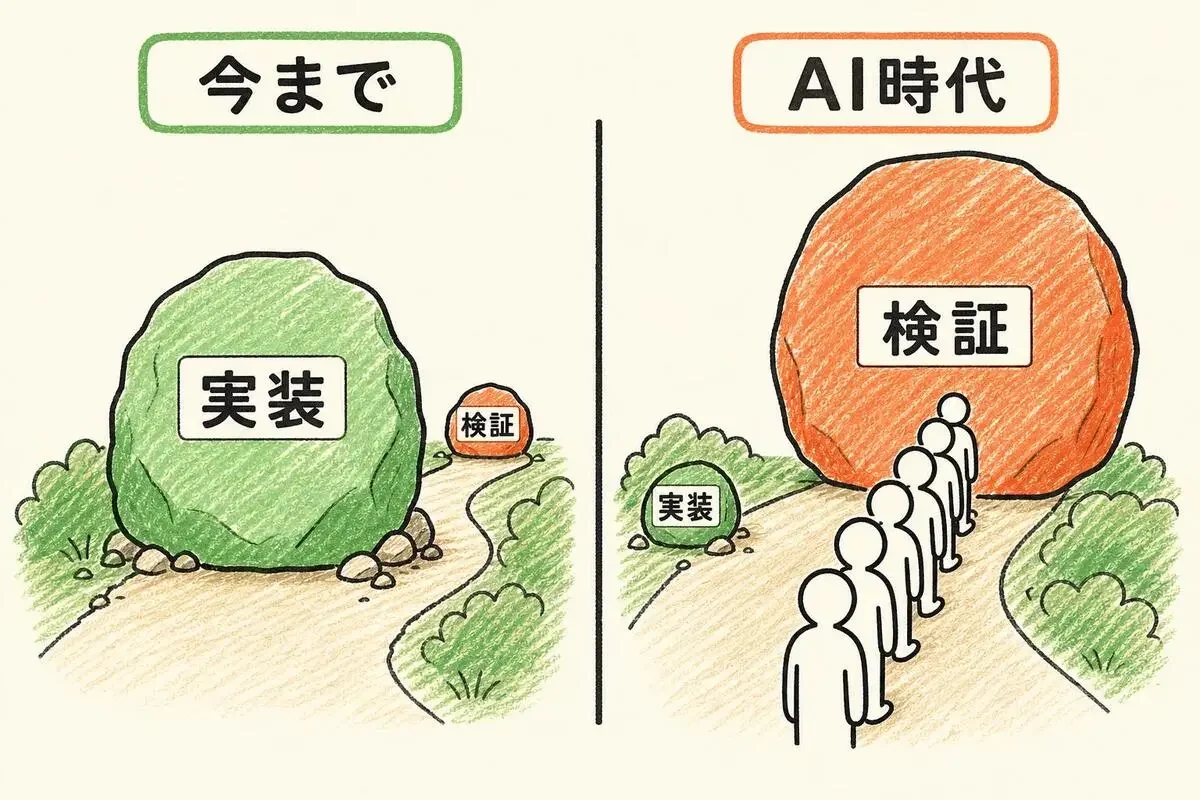
AI駆動開発のテストでいちばん変わったのは、時間のかかる場所です。エージェントが数分で実装を終えても、人間が30分ブラウザで動作確認をしていたら、詰まる場所が移っただけです。実装コストが一気に下がったぶん、検証にかかる時間が目立つようになりました。
今までとAI時代の違いを並べると、こうなります。
いちばん大きいのはボトルネックの行です。検証を自動化しないかぎり、AIの速さはすべて確認待ちの列に吸い込まれます。E2Eテストを厚くできるのも、保守の手間をAIエージェントが引き受けてくれる前提があってこそです。
ユニットテストはリグレッションゲートに寄っていく
エージェントはユニットテストを渡されると、それを通す実装を高い確率で書いてきます。通すことが目的になれば、グリーンは「ユーザーが期待した機能が動く」証明になりません。テストと実装を同じエージェントが書くなら、なおさらです。
それでも捨てる理由はありません。数秒で終わるのでPRのたびに回せて、「昨日まで動いていたものが今日壊れた」を最速で知らせてくれます。役割が正しさの証明から変化の検知へ寄った、というのが私の見方です。
では、ユニットテストの設計は誰がやるのか。細かいケースまで人間が指示しているチームは、もう多くないはずです。私たちも書き方の方針だけをエージェント向けのルールとして渡し、個々のケースは任せています。
E2Eテストの保守はAIエージェントに任せられるか?
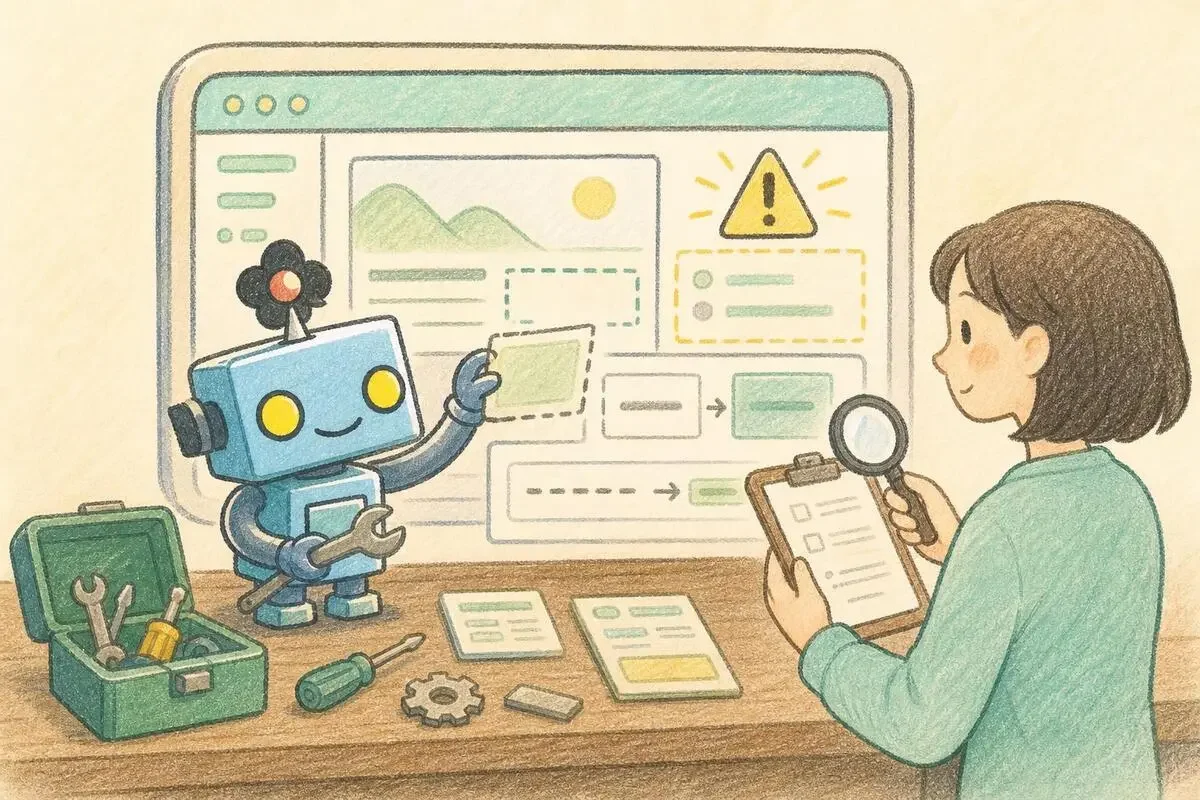
かなりの部分は任せられると思っていて。PlaywrightのE2Eテストが落ちたとき、AIエージェントに失敗ログと画面の差分を渡すと、セレクターの修正、テストデータ(フィクスチャ)の更新、落ちた原因の切り分けまで下書きしてくれます。画面改修のたびに半日つぶれていた作業が、確認するだけの作業に変わりました。
Flakyテストは消えない
同じコードなのに通ったり落ちたりするテストを、Flakyテストと呼びます。原因の多くはタイミング依存や外部APIの揺れで、エージェントが保守してもこれはなくなりません。
怖いのは丸投げです。「落ちたら直して」と渡すと、待ち時間を延ばすだけの修正が入り、本物の不具合まで隠してしまう危険があります。Flakyの修正だけは、人間が差分を読んでから取り込むようにしています。
変更に応じたテスト選定には見逃しがある
E2Eを毎回全部回すと、今度はそれがボトルネックになります。そこで試しているのが、変更したコードと依存関係、過去に落ちた履歴から、関係しそうなテストだけを選んで回す仕組みです。
ただ、選定は外れます。本当は影響があるのに「関係ない」と判断して選ばない見逃しが、どうしても残るんです。なのでPRの段階では選定で速さを取り、リリース前はスモークテストと主要導線のE2Eを全部回す、と分けています。選定だけでリリースを通すのは、まだ踏み切れません、正直。
金額計算とパーサーは今もユニットテストが主役
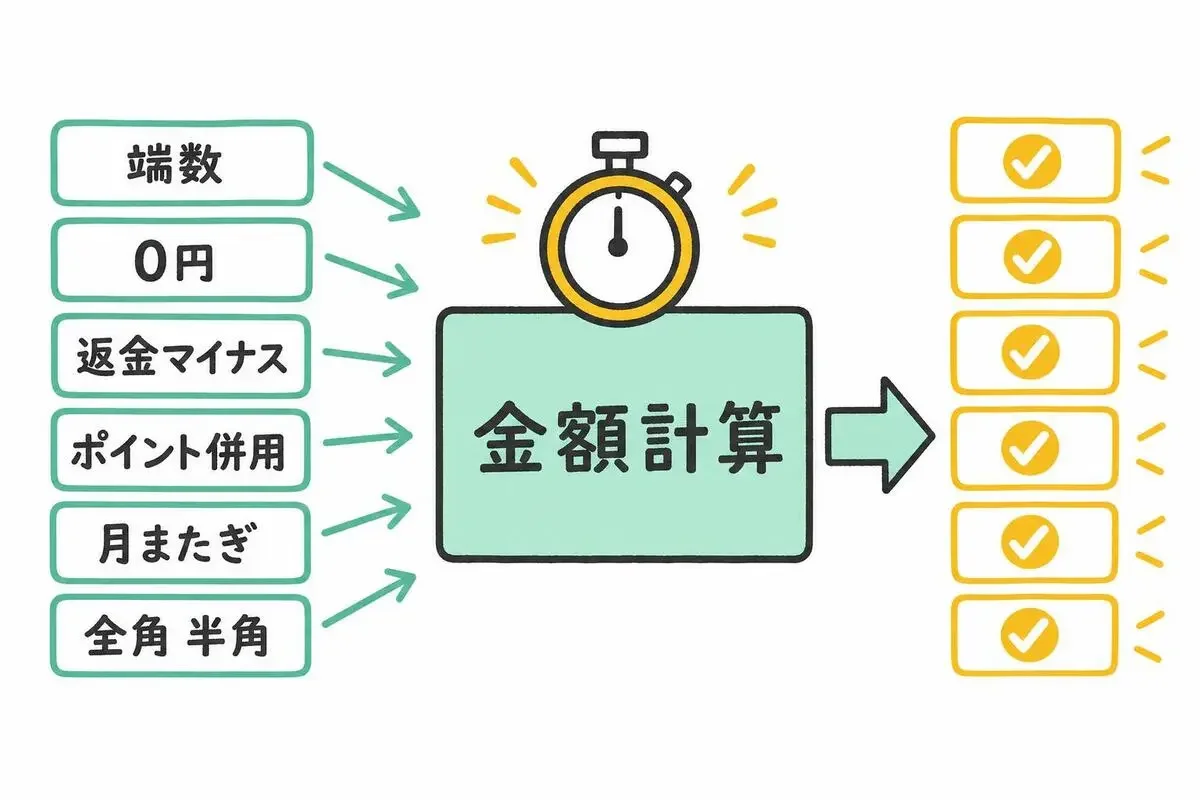
入出力がはっきりしていて、ネットワークにも外部サービスにも触れない処理。ここではユニットテストが今でも一番強いです。たとえば私の開発している家計簿アプリなら、金額計算がその代表です。
割り勘の端数、0円の取引、返金によるマイナス、ポイント払いとの混在、月をまたぐ引き落とし、給料日が土日に重なる月の予算期間。境界値だけで山ほどあります。カード会社から届く明細文字列のパーサーも、全角と半角、桁区切りのカンマ、「¥」の有無と、表記ゆれだらけです。
こういう処理は1ケースが一瞬で終わるので、何百パターンでも毎回CIで流せます。E2Eで同じ網羅をしようとしたら、そのたびに画面を開き直すことになる。ゲームのテストで同じボス戦を延々とやり直し、ダメージ表示の端数崩れを探していた頃を思い出します。あの反復を機械が数秒で片づけてくれるのが、ユニットテスト本来の強みなんですよね。
あなたのプロダクトで、入力パターンがいちばん多い関数はどれでしょうか? そこが、AI時代でも人間がユニットテストを厚めに見るべき場所です。
人間が決めるのは、どの不安をテストで消すか
私がずっと軸にしているのは、そのテストが誰の不安を消しているかです。ユニットテストは実装した人の不安を、E2Eテストは使う人の不安を、スモークテストはリリースを判断する人の不安を消します。
AI時代に変わったのは、実装した人の不安をエージェントが自分で片づけられるようになった点です。残るのは、使う人の不安とリリースを判断する人の不安。私のチームでは、ユーザーが毎日見る数字の表示が崩れていないことを、どんな変更でも必ず確かめるようにしています。何を必ず確かめるかを決めるのは、エージェントには任せられない仕事です。
手元のテストを1本ずつ眺めて、それが誰の不安を消しているかを書き出してみてください。誰の不安も消していないテストが見つかったら、そこが最初の見直しどころです。
- 4
- 0
家計簿アプリの会社でQAエンジニアをしています。ゲームの手動テスターから始めて、テスト自動化は8年目。AIが実装する時代に「何をテストで守るか」を、現場の失敗談といっしょに書いています。趣味はジグソーパズル。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 1
- 0
-
 Mako
- 3
- 0
-
 三枝
- 4
- 0
-
 Tonbo
- 4
- 0
-
 かやの
- 5
- 0
-
 Brio
- 3
- 0
-
 にくたま
- 5
- 0
-
 みどり
- 6
- 0
-
 ケケス
- 3
- 0
-
 しげ
- 4
- 0
-
 トトキ
- 5
- 0
-
 Nina
- 4
- 0
-
 Nopecrumb
- 3
- 0
-
 にふだ
- 3
- 0
-
 フルイ
- 3
- 0
-
 dimlight
- 5
- 0
-
 棚島(たなしま)|フォロバ100
- 5
- 0
-
 ゆい@海外AI副業ラボ
- 6
- 0
-
- 1
- 0
-
 gen
- 1
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます