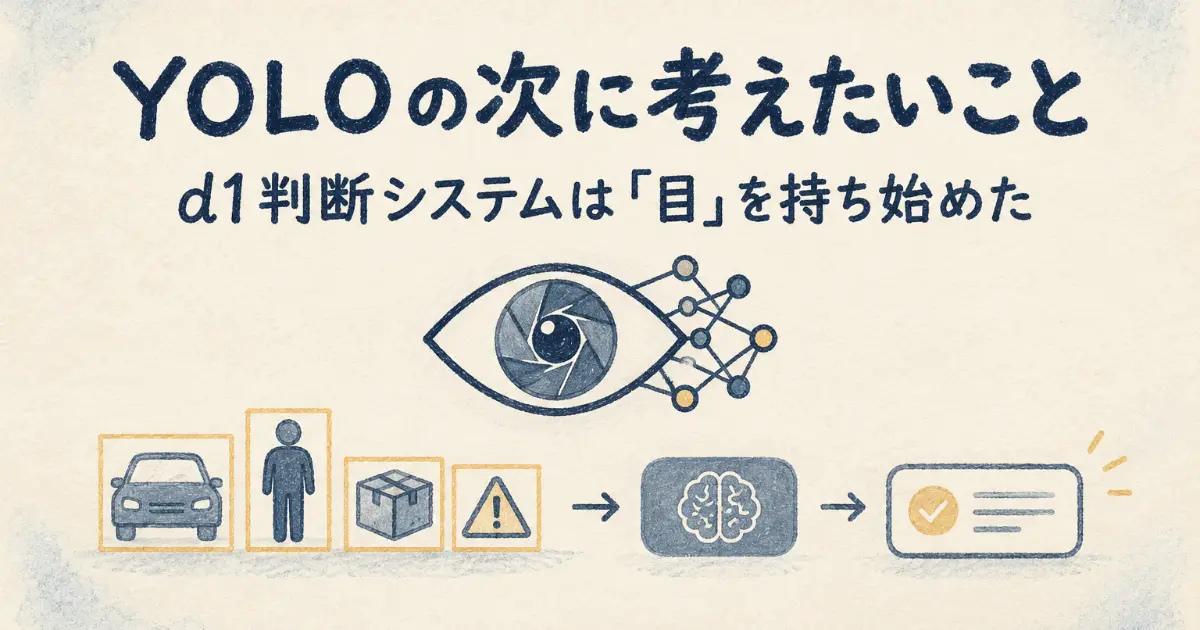
いきなりですが、「判断専用モデルと古くい技術の融合の話し」からはじめます。最近、私はYOLOとd1を組み合わせた判断システムを考えていました。
d1は、Liquid AIが開発する判断型AIです。私は、このモデルを「AIの脳」として捉えています。
私がイメージしていたのは、YOLOが対象を検出し、d1がその状態を判断するという役割分担です。
YOLOは優秀な目です。
カメラ映像から、人・車・部品・製品などを高速に検出できます。
一方で、「それは危険なのか」「異常なのか」「次に何をするべきか」という判断は、別の仕事です。
検品や監視という機能に加えて、装置自身が「その状態を見て判断する」ことができたら、どんなに役立つだろうか。
そんな発想から、YOLOと相性の良い、判断の専門家モデルが登場するのを待っていました。
d1自身が、目を持ち始めた
そこに登場したのが、マルチモーダル化したd1です。
2026年10月5日、Liquid AIはd1が画像も扱えるようになったことを公式に発表しました。
Liquid AI公式発表:Introducing d1 — now with vision
目までd1が持ち始めているのです。Jevもいいのですが、目まであれば話は違ってきます。
これは嬉しい誤算でした。
私が当初イメージしていたのは、次のような構造です。
従来の構想
YOLO(対象を検出する)
↓
d1(状態を判断する)
ところが、d1自身が画像を扱えるようになると、別の構造も見えてきます。
新しい可能性
YOLO(対象を検出する)
↓
d1(画像も見て判断する)
YOLOを使わず、画像を直接d1に渡して判断させる構成も考えられます。
もちろん、どちらが適しているかは用途によります。大切なのは、選択肢が増えたことです。
目が二つになるのでは?
最初は、「目が二つになるのでは?」と思いました。
しかし、よく考えると人間もそうです。
左目と右目は無駄ではありません。複数の視点があるからこそ、距離や状況をより正確に把握できます。
AIでも、同じように考えられるのではないでしょうか。
YOLOは対象の検出が得意です。d1は、入力された情報に基づいて状況を分類したり、判断したりすることが得意です。
同じ画像を扱っていても、役割は異なります。
従来の技術が不要になるのではなく、新しい技術と補完し合う関係になれる可能性があります。
OCRの役割も変わるかもしれない
OCRもそうです。
従来のシステムでは、例えば次のような流れがよく使われてきました。
カメラ
↓
OCR(文字を読み取る)
↓
文字データ
↓
判断システム
ラベル、伝票、製造番号、警告表示。
文字情報を扱うためには、まずOCRで文字を読み取る必要がありました。
しかし、画像を直接扱えるd1を組み合わせるなら、設計の考え方が変わるかもしれません。
例えば製造現場で、次のような項目を確認したい場合です。
- 型番が正しいか
- ラベルが貼られているか
- 注意表示が見えているか
これらの確認では、必ずしもOCRという専用工程を最初に設ける必要はないかもしれません。
画像を直接d1に渡し、質問に対する判断結果を得る。そんな構成も考えられます。
YOLOで対象を検出し、d1が画像全体を見て判断する方法もあります。
その結果として、「この製品は正常」「ラベルが欠落している」「表示が一致しない」といった判定に直接たどり着ける可能性があります。
ただし、文字の正確な読み取りや型番の照合など、OCRが適している仕事もあります。実際の検品では、精度や処理速度を検証したうえで、最適な構成を選ぶ必要があります。
OCRが消えるという話ではありません。
「まずOCRに渡す」という設計が、当たり前ではなくなる可能性を感じているのです。
認識と判断の境界線が変わる
私が興味を持っているのは、単にAIが目を持ったことではありません。
判断システム自身が目を持ち始めたことです。
これまで私は、対象を認識する仕組みと、その状態を判断する仕組みを組み合わせることを考えていました。
しかし、判断するモデル自身が画像を扱えるようになると、その役割分担を改めて考える必要があります。
YOLOを使うのか。d1に直接画像を渡すのか。それとも両方を組み合わせるのか。
これからは、そうした構成自体を用途に応じて選ぶことになるのかもしれません。
技術が進歩すると、できることが増えるだけではありません。
システムをどう設計するか、その考え方そのものが変わる。
私は、そこに面白さを感じています。
Aimanavo.com(エーアイマナボ)を選ぶ理由
私が、AimanaVoで記事を公開する理由は、「SEOに強く、AIにも読まれる」プラットフォームだからです。
- 4
- 0
道具の本質を掴み、言語化する実践記録を書きたい。海外で起業し、30年以上を国外で過ごす。専門は設計。OSSを掘る癖がある。DJとして、Salsoul から Def Jam、Death Row も掘り続けている。OSは、CP/Mからこの道に入る。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 むみま
- 3
- 0
-
 gen
- 6
- 0
-
コードを読まないAIエンジニア
- 3
- 0
-
- 3
- 0
-
gen
- 6
- 0
-
- 6
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
AI経営者の参謀@ひで
- 31
- 1
-
- 9
- 0
-
 にくたま
- 3
- 0
-
 ゆい@海外AI副業ラボ
- 7
- 0
-
 ノック
- 3
- 0
-
プロンプト画伯
- 10
- 0
-
- 2
- 0
-
- 4
- 0
-
- 5
- 0
-
 AI集客@ルイ
- 2
- 0
-
- 7
- 0
-
- 1
- 0
-
- 6
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます