
チケットの仕分けやモデルの振り分けのためだけにLLMを叩いて、3秒待たされたうえにJSONのパースに失敗する。心当たり、ありませんか。
TypeSafe AIが2026年9月15日に早期アクセスを開けた「Jev」は、そこだけを狙ったモデルです。公式が示す5つのカテゴリと19の業種を広げて、自分の現場のどこに刺さるか拾えるところまで持っていきます。

Xで見かけたJevのユースケース
リアルタイム接客
リアルタイムでゲームのステージ生成
スーパーマリオブラザーズの操作
メール分類
トロッコ問題
アルゴリズムトレード
Jevは、文章を返さずに何を返しているのか
Jevは「System One Model」という新しい分類の第1号です。発表ブログの一文が的確で、「unstructured state in, typed probabilistic decisions out」。構造化されていない状態を入れると、型の付いた確率的な判定が返る。返り値が文字列ではない、というのがすべての出発点です。
訓練手法もLLMとは別物で、RLCDという独自の学習が「生成テキストの代わりに判定と較正済み確率を返す」方向に振ってあります。確率0.2を付けた判定は、集団で見ればおよそ20%当たる。返信もコードも理由の説明も生成しない、と公式ドキュメントは素っ気なく書いています。
「Jevはハルシネーションしない」という言い方が出回っていますが、これは設計上の保証です。出力候補が事前に定義されているのでスキーマ適合が保証される、つまり型エラーを起こさない。判断を間違えないという意味ではありません。外し方はむしろ公式が9パターン公開していて、これは後半で扱います。
RLHFとInstructGPTの共同発明者である Diogo Almeidaさんが、共同創業者兼CEOです。元OpenAIで人に好かれる応答を作っていた人が、人が読まない出力に振り切った。
Jevの質問は、ノウル、チョイス、スコアの3つだけ
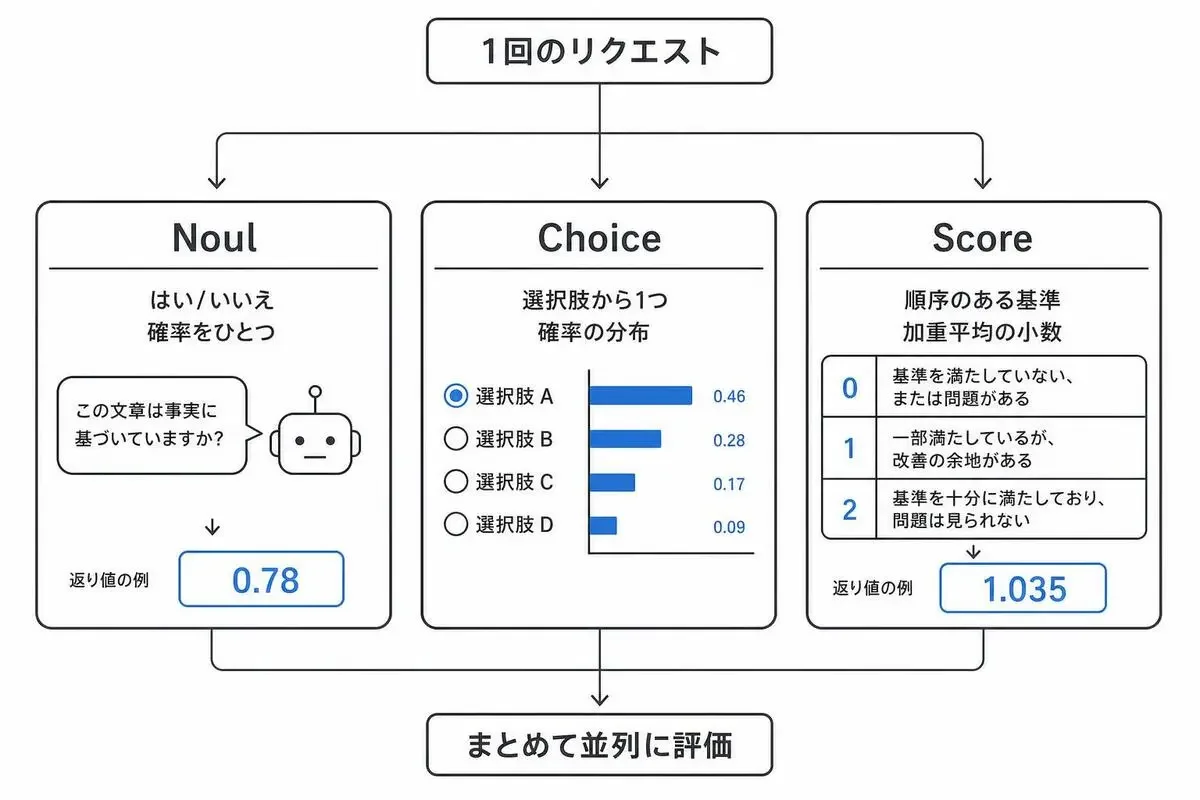
投げるのは state(判定対象の生テキスト)と questions(自分で決めたキーと質問オブジェクトのマップ)だけです。
noul はyes/noを聞いてyesの確率を0から1で返します。choice は選択肢から1つ選び、全選択肢の確率分布と confidence を返す。選択肢は最大255個。score は順序付きルーブリックで採点するもので、レベルは最低2、最大10。返る score は確率加重平均なので、3レベルなら0から2の小数になります。
アンケートに例えると、はい/いいえの質問、選択式の質問、段階評価の質問を1回のリクエストに混ぜて投げられる、というイメージです。
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": [
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
これで返るのは department が billing で確率0.84、frustration が1.035、is_urgent が0.999。noul にだけ confidence が付かないのは、単一の数値そのものが答えだからです。
効くのは、質問を並べても時間も値段もほとんど増えないところです。公式の言い方だと「使うか分からない質問を足すのは、ほぼタダ」。13問を1リクエストにまとめた実験では、1問ずつ投げるより12.2倍安く10.0倍速く、答えは変わらなかったと報告されています。
「とりあえず聞いておく」が許される判定器、今までなかったですよね。
Jevのユースケースは、5つのカテゴリに畳まれている
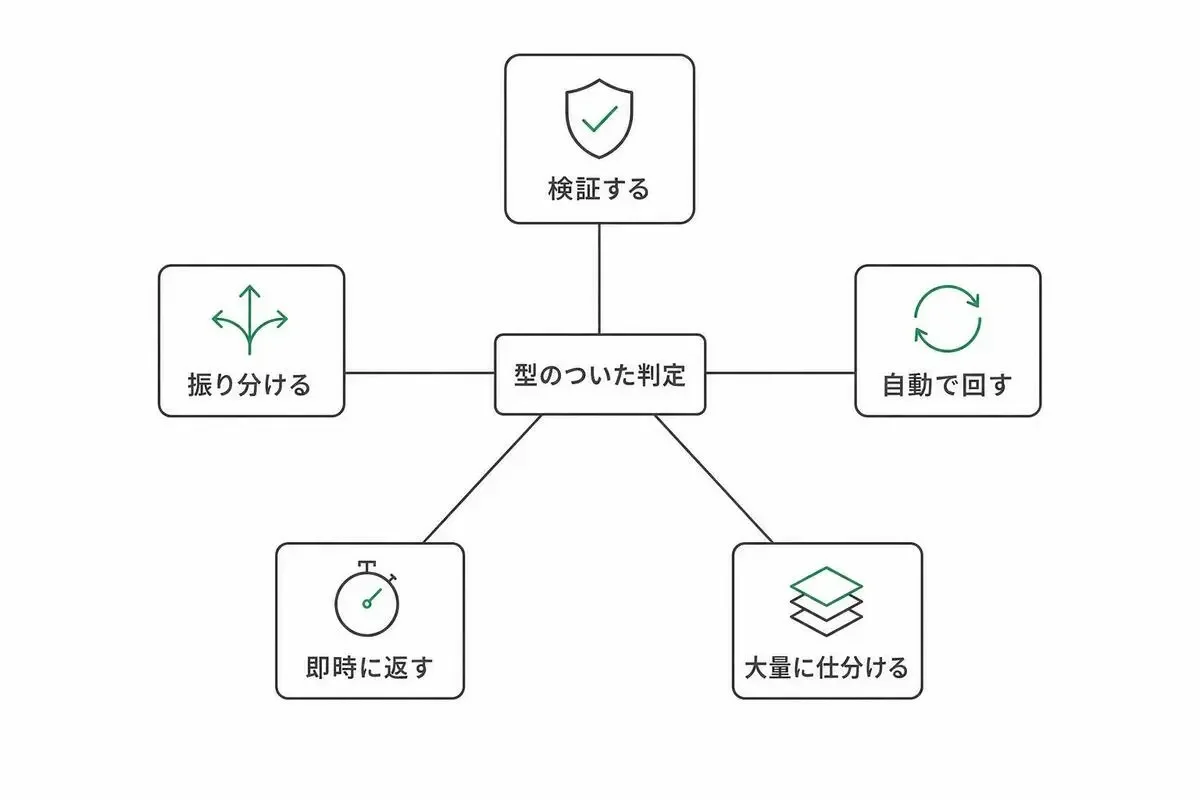
公式は用途をまず5つに束ねています。導入しやすい順に並べ替えると、自分のコードのどこから手を付けるべきかが見えてきます。
LLMの隣に置いて、出力とツール呼び出しを見張る
公式の言うUniversal Verificationです。入力プロンプト、抽出結果、推論トレース、ツール呼び出し、どれでも検証対象にできる。ジェイルブレイク、引用エラー、ハルシネーションといった失敗モードを、実際のLLM呼び出しのごく一部のコストで検出する、という位置づけになっています。
つまり、既存のLLM本体には手を触れず、入口と出口の両方を外側からダブルチェックする層を足せるということです。
既存のパイプラインを壊さずに横へ挿せるので、経路としては一番軽い。LLMの出力が返ったあとに noul を2つ3つ並べて、しきい値を超えたら止める。それだけで検証層が1枚増えます。今のパイプラインで、出力をノーチェックのまま通している箇所、思い浮かびますか。
モデルルーティングとガードレールで、ハーネスを賢くする
Harness Engineeringでは、どのLLMがどのプロンプトを受け取るかを決めるカスタムルーターをJevで組む使い方が挙がっています。意図とドメインを分類し、難易度とリスクを見積もり、高価なモデルが要るリクエストだけをエスカレーションする。
肝は confidence の3段構えです。高ければ自動実行、中程度なら確認かフラグ、低ければ人間へ。しきい値はリスクで変えるものとされていて、残高照会は緩く、送金承認は0.9を超えないと確認を挟む、という例が示されています。どこまでを自動実行に回してどこから人間を挟むか、この線引きを先に決めておくと、しきい値はあとから数字で詰められます。逆に決めないまま自動実行へ寄せると、事故は必ず confidence の低い側で起きます。
人間を挟まずに、100万回まわす自動化を組む
AI Automation Softwareの説明文は少し挑発的で、「制御フローはコードが持つ、マークダウンファイルではなく」。人間のコパイロットなしでバックグラウンドに100万回まわせる形にする、というのが狙いです。
ブログはこれを smart if-statements と呼びます。手書きだと脆すぎる分岐を分類やスコアや抽出に置き換え、周りのコードで自由度を縛る。マニフェストの脚注では、知覚をニューラルネットに、推論を記号論理に任せる neuro-symbolic AI の夢だとも書いています。if の条件式に意味理解を1つ埋める話だと思えば早い。
主導権はコードのまま、意味理解だけをJevに貸してもらう。役割分担がはっきりしているぶん、動かしたあとの挙動も追いやすくなります。
人間の知覚より速い判断を、UIとゲームに埋める
レイテンシはエンドツーエンドで70ミリ秒から500ミリ秒。比較対象のフロンティアLLMが3秒から329秒なので、同等の知能を要する判定で40倍から200倍速いというのが公式の主張です。ドキュメント側はリアルタイム用途の目安として150ミリ秒を挙げています。
速い方の70ミリ秒はまばたき1回より短く、遅い方の500ミリ秒でも、操作が途切れたと感じ始める1秒には届きません。知的な分岐を挟んでもUIの手触りを止めない、という速度帯です。
公式のDoomデモは毎秒10クエリで、時給にして約1,050円(約7ドル)。ただし画面を見てプレイしているのではなく、ゲーム状態を構造化データとして渡している。しかもTypeSafe自身が「AIなしのボットのほうが上手い」と認めています。速さのデモであって、強さのデモではありません。
巨大なデータを仕分けて、予測モデルの特徴量にする
安さがそのまま処理量に化けるカテゴリです。巨大なコーパスから関連情報を探す、大量のエージェントトレースを分類する、特徴量を抽出して予測に使う。
数字が出ているのが再ランキングで、法務クエリ40件にBM25で30パッセージのショートリストを作りJevをかけたところ、top-1精度が5%から18%、top-10精度が38%から62%に上がったと報告されています。埋め込み検索の後段に1枚噛ませる使い方です。
最初の1件が正解である確率が3倍以上に伸びた計算で、埋め込み検索だけでは拾いきれなかった順位のずれを、後段の一手で締め直せるということです。
19業種のユースケース一覧から、自分の現場に効くものを拾う
公式は業種・機能別に19項目を並べ、それぞれの判定が「決定の形」10種類のどれに当たるかも別表で定義しています。自分の担当領域から逆引きできるよう、両方を1つの表に畳みました。
表を眺めながら、自分のプロダクトがどの列に当てはまるか探してみてください。エンジニアの実務に直接降りてくるものを、いくつか厚めに見ていきます。
検索とリトリーバルは、RAGの埋め込みを置き換えるか補完する使い方です。クエリと候補の関連度をスコアリングし、ペアワイズ比較で並べ替え、精度が要る箇所はクロスエンコードする。下流に渡すコンテキストを選ぶ役もここに入ります。
セマンティックなコードlintは、私が一番すぐ試したい項目でした。自チームの規約と執筆ガイドラインを criteria に書いて、CIで違反をフラグする。静的解析では書けなかった「規約の意図」をチェックに載せられる。LLMでやると遅くて高くてCIに入らなかったやつです。
カスタマーサポートは公式の例が一番具体的で、チケットを課題と製品領域と顧客意図で分類し、通話の書き起こしから約束事項とフォローアップを抽出し、緊急度と苛立ちと解約リスクと返金要求を検出してキューに振る。モデレーションなら、深刻度と confidence を組み合わせて許可か警告かレビューかブロックかを決める設計が示されています。
1件のチケットが届いた時点で、振り分け先も緊急度も解約リスクも同時に出そろう、という組み方です。
金融犯罪とナレッジグラフは、どちらも実体の照合が中心です。表記の揺れた名前や記録を横断して同一のものを見つけ、アラートをリスクと証拠の質で並べ替え、曖昧なものだけ人に回す。score の3レベルが「統合する、未リンクのまま残す、人に回す」という3アクションと1対1で対応するので、判定がそのまま処理分岐になります。
入力10億トークンで約6,300円という料金が、ユースケースの下限を押し下げる
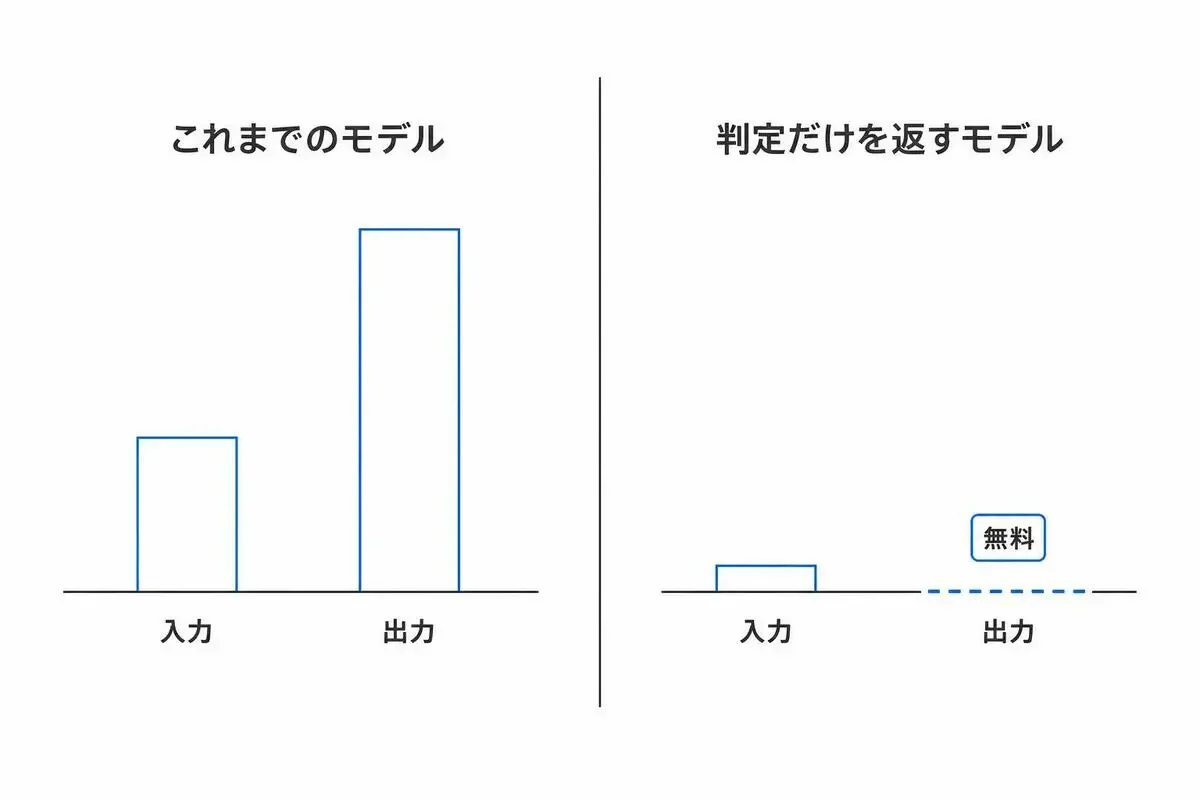
Modelsページによると、Jev 1.13 の価格は入力10億トークンあたり42ドル、日本円で約6,300円。100万トークンなら0.042ドル、6円強です。
効くのは金額より課金の形で、課金されるのは入力トークンだけ、出力トークンは無料。既存のLLMが入力100万トークンあたり0.20ドルから10ドルで、出力はその5倍前後という構造だったことを思えば、見積もりの前提が変わります。
制限はレートが毎秒250,000トークンと毎分1,200リクエスト。コンテキストは1リクエスト64kトークンで、うち state と最長の質問の合計が32kまで。入力はテキストのみで画像も音声も受け付けません。レート制限は予告なく動くとドキュメントが明言しているので、本番の前提に置くなら要確認です。
料金ページは typesafe.ai 側も docs 側も404で、無料枠やトライアルの有無は公開情報がありません。
Jevという名前は経済学者のJevonsから来ています。知能のコストが1桁下がるごとに、ユースケースが桁で増える。その読みが名前に入っている。
Jevが苦手なことは、公式が9つ並べている
jaggednessのドキュメントに、失敗モードが9つ、対処法とセットで公開されています。
数値と計算は苦手で、カウントすら正確ではない。日付も順序量ではなくテキストとして読むので比較はコード側でやれ、という指示です。多段の間接参照で精度が落ちること、state に無関係な情報を詰めると劣化すること、state は敵対的と見なされないのでプロンプトインジェクションで答えが動きうることも明記されています。
算数と時系列の比較と余計な情報の紛れ込みに弱い、というのが公式の自己申告です。書いてある通りに literal に読むこと、指示と基準が矛盾すると崩れること、テキスト生成には使えないことも、同じ9項目に並んでいます。
背筋が伸びるのが、同じ問いを noul と choice で聞くと数字が一致しない例です。「返金を求めているか」に対して noul が0.22、同じ問いの choice は no が0.99で confidence 0.97。別の文面で「返金要求か」「返金以外の要求か」を2つの noul に分けて聞くと0.72と0.47、合計1.19。構造的な整合性に寄りかかった設計は普通に破綻します。
日本語も公式が留保しています。英語が主要な訓練言語で精度が一番良く、CJKを含む他言語も扱えるが同等ではない、非英語で頼る前に自分のコンテンツでテストし、ルーティング時は confidence に注意を払え、と。日本語のチケットを流すなら、必ず自分で測ってから判断したいところです。
提供形態は早期アクセスのウェイトリスト制で、順次バッチで開放されています。公式ブログは「できるだけ早くウェイトリストから開発者を迎え入れている」と書くだけで、待ち時間の明示はありません。登録の翌日には通ったという報告も見かけますが、裏付けは取れていないので、待ち時間は読めないものとして登録しておくのが無難です。self-host不可、ファインチューニングやLoRAの提供もなし、単一リージョン。社内に閉じた運用や自社データでの追加学習は、今のところ選択肢に入りません。InfoWorldの記事では、確率は自信は示せても理由は説明しないので規制産業では問題になりうる、という指摘も出ています。
自分のコードのどこに、Jevの判定を差し込むか
トップページの193.6倍速い、444.6倍安いという数字は、TypeSafeが自社のワークフロー評価で出したものです。公開ベンチマークではないうえ、本人たちが「現実の改善幅としては高い方の端」「作ったのは自社のモデルチームなのでバイアスはありうる」と書いている。正直さは好きですが、自分の見積もりに流用する数字ではありません。
そもそも公開ベンチマークの成績を意図的に出していない会社です。ベンチマークに重みを置くな、自分のユースケースで自分のevalを作れ、evalのニュアンスを開示しろ、勝っているときでも強調するな。並んだベストプラクティスの最後が一番効きます。
なので宿題もそのままです。今LLMに投げている判定のうち、返り値が型で書けるものを1つ選ぶ。それを choice か score か noul に置き換えて、自分のデータでレイテンシと単価と正解率を測る。
型で書けるということは、判定の輪郭がもう決まっているということです。そこに文章生成モデルを置いておく理由、まだありますか。
- 5
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
AI脱社畜
- 3
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
コードを読まないAIエンジニア
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
 黒板とAI@直人
- 6
- 0
-
- 3
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
-
 カイ@プロダクトマネージャー
- 4
- 0
-
 弾丸旅プラン@りの
- 7
- 0
-
AI経営者の参謀@ひで
- 4
- 0
-
 NONOKA
- 5
- 0
-
ワンオペ育児×AI@まな
- 2
- 0
-
- 2
- 0
-
- 3
- 0
-
 キャリア迷子@そら
- 2
- 0
-
 タツヤ
- 2
- 0
-
クロージング師匠
- 1
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます