モデル比較をするための物差し
私は普段、Devin Desktop(旧Windsurf)や VS Code+Continue のような「IDE+AIエージェント」を比較するとき、YOLOv8の物体検出精度を改善させるタスクを自分なりの物差しとして使っています。
単なるコード生成ではなく、
- 現状分析
- 改善仮説の立案
- 実装
- 検証
- 次の打ち手の提案
までを見ることができるからです。
YOLOv8のmAPをあと数ポイント上げる。そのために何を試し、何を捨て、どんな根拠で次の一手を選ぶのか。この過程を見ると、AIエージェントの個性が意外によく見えてきます。
ただ、正直に言うと、Continueを十分に使いこなせているかと聞かれれば、自信はありません。
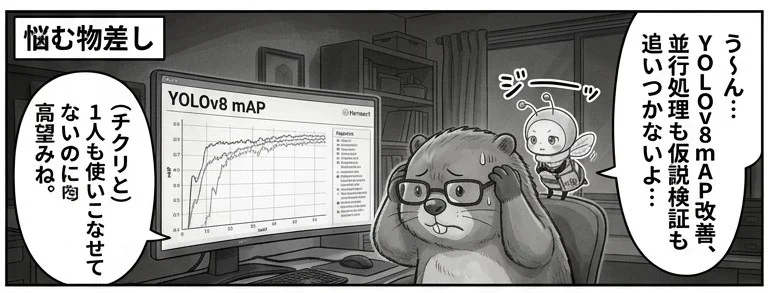
コードを書かせたり修正させたりはできる。でも、「では精度をあと5%上げるために何を試そうか」という探索のフェーズになると、途端に難しくなります。
そもそも私自身が、YOLOv8の改善実験を複数ブランチで並行して回しながら比較するような運用に、まだまだ慣れていません。
失敗した実験も含めて記録しながら、
仮説A
仮説B
仮説C
を同時に進める。頭では重要だと分かっていても、実際にはなかなかできません。
ようやく分かりかけているHarness
さらに言えば、私はまだ「このタスクならこのエージェント」という定番も持てていません。どのモデルを使うか。どのエージェントを使うか。どこまで自動化するか。
毎回少しずつ迷っています。
最近になってようやく、自分なりのHarnessが少し定まってきたかな、という程度です。そんな状態で、
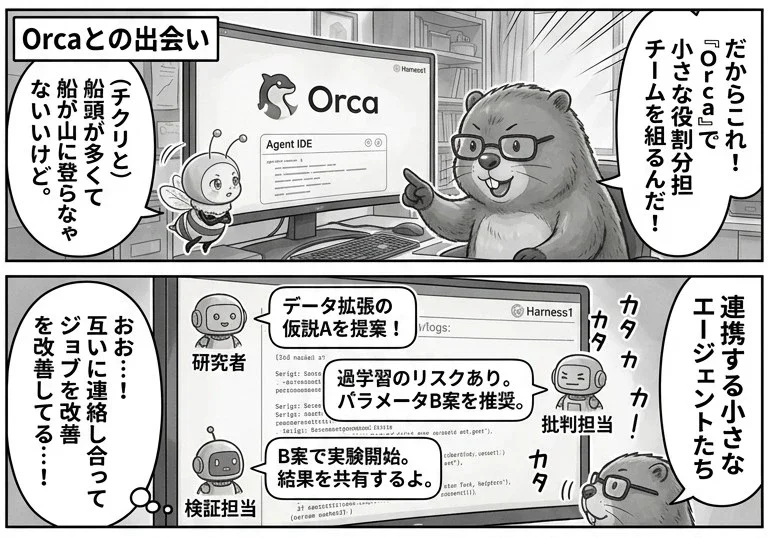
Orca (Stably AI) の記事を読んでいます。
「いや、待てよ? CrewAIの方が自分には合うのかな?」
という葛藤もあります。ちなみにCrewAI は、複数あるAIエージェントに仕事を依頼して、チームとして協調させるPython製のフレームワークです。
今回気になっている Orca のほうは、Stably AI が開発している、Claude Code などの IDE ベースのエージェントを並列に動かして協調させるための Agent IDE です。
Orcaをはじめるフェーズでなにをするのか
私自身はまだ触り始めたばかりですが、「1人の優秀なエージェントを探す」という発想から、「複数のエージェントに役割分担させる」という発想への転換点として興味を持っています。
Orca公式サイトは https://www.onorca.dev/ 、ソースコードは https://github.com/stablyai/orca で公開されています。
実際に触りながら、自分のYOLOv8検証やHarness運用とどう噛み合うのかを見ていきたいと思っています。
Orcaの魅力は、単独エージェントの性能というより、
「複数の専門家を同時に動かす」
という考え方にあるように見えます。
機械学習研究者。
MLOps担当。
データ分析担当。
レビュー担当。
それぞれの役割を持つエージェントが並列に考え、意見を出し合う。確かに面白そうです。でも、その一方で思うのです。
私はまだ、1人のエージェントを十分に使いこなせていない。
そんな私が、さらに複数人を率いる世界に進めるのだろうか。
遠回りになるのか。それとも近道になるのか。だから今の私は、
「Orcaはすごいのか?」よりも、
「Orcaの強みを観察できる入り口はどこだろう?」
の方に興味があります。
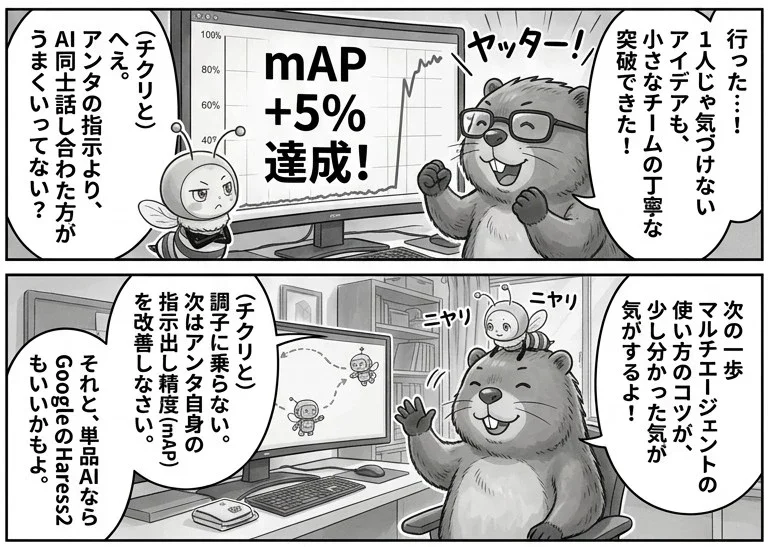
たぶん最初から完璧なマルチエージェント運用を目指す必要はないのでしょう。むしろ私が普段やっているYOLOv8の精度改善のような課題を題材にして、
- 研究者エージェント
- 検証担当エージェント
- 批判担当エージェント
ぐらいの小さな編成から始めるのが良いのかもしれません。Orcaを評価するというより、マルチエージェント時代への入り口を探している。
今のところ、そんな感覚です。
- 3
- 0
道具の本質を掴み、言語化する実践記録を書きたい。海外で起業し、30年以上を国外で過ごす。専門は設計。OSSを掘る癖がある。DJとして、Salsoul から Def Jam、Death Row も掘り続けている。OSは、CP/Mからこの道に入る。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
コードを読まないAIエンジニア
- 5
- 1
-
- 3
- 0
-
 カイ@プロダクトマネージャー
- 2
- 0
-
 むみま
- 4
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 3
- 0
-
bokuwalily
- 5
- 0
-
- 1
- 0
-
- 2
- 0
-
 gen
- 5
- 0
-
- 2
- 0
-
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます