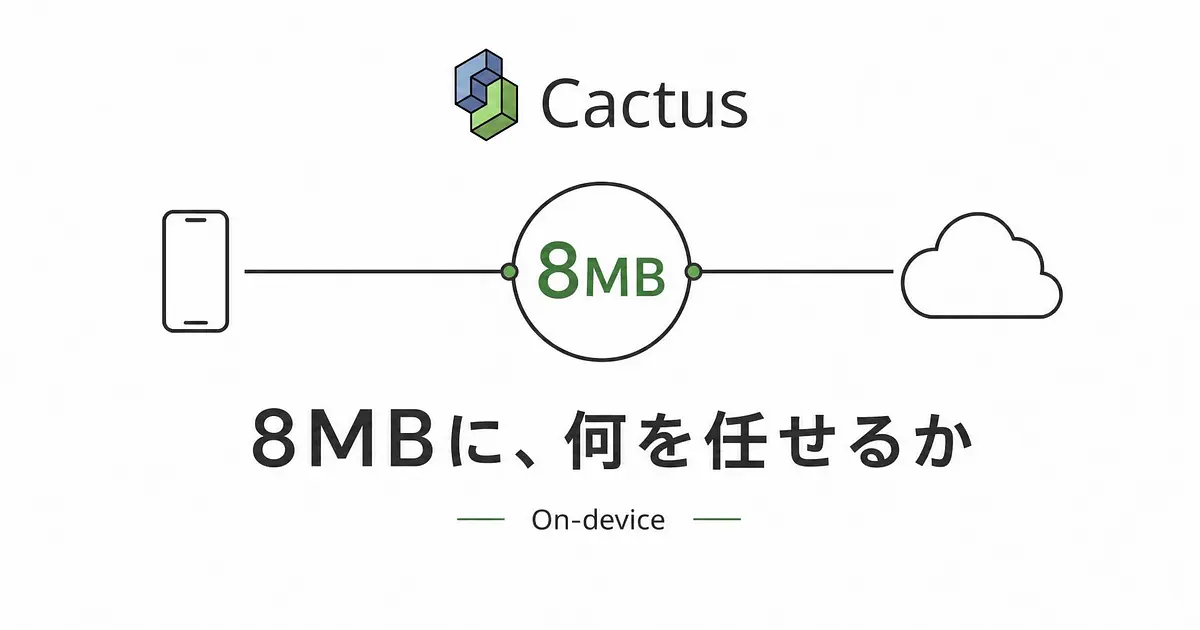
function callingを使っているアプリには、たいてい「壊れたJSONが返ってきたらもう一度投げる」処理が残っています。私の手元の案件でもそうで、リトライ回数の上限とバックオフをどこに置くかを毎回考えることになる。この処理ごと不要にしにいったモデルが、8MBという単位で出てきました。
チャットができないモデルという選択
Cactus ComputeがApache-2.0で公開したNeedle 3は、汎用チャットの能力を持っていません。持っていないのではなく、意図的に捨てています。
できるのは3つだけです。アプリが公開している関数から適切なものを選んで引数を全部埋めること、雑なテキストから型の付いたフィールドを抜き出すこと、ローカル検索やルーティングのために文をベクトルにすること。該当する関数がなければ空のリストを返す、という挙動まで設計に含まれています。
会話できないモデルに価値があるのか、と思いますよね。ここで一度、自分のアプリがLLMに投げている処理を数えてみてほしいんです。「ユーザーの入力から意図を取ってAPIを叩く」「レシートの写真のOCR結果から金額と日付を抜く」「入力文に近い項目をローカルのDBから探す」。このあたりが大半を占めているなら、会話能力に対してお金とレイテンシを払い続けていることになります。
8MBと29MBを分けているのは何か。
サイズに幅があるのは、層の深さを選べるからです。Needle 3はLaddered Simple Attention Networksという構成で、2層から20層までのどの深さでも、それ単体で1つのモデルとして成立するように学習されています。公式が intelligence laddering と呼んでいるのはこの性質です。
最大構成で121Mパラメータ、これをCactus Quantsの2ビット(.cact形式で1重みあたり2.125ビット)に圧縮した結果が8〜29MBという数字になります。ここで見落としやすいのが推論エンジン側で、各デプロイ先向けのプリビルドエンジンは1MB未満です。つまりアプリに足すのは「モデル本体 + 1MB未満のランタイム」で済む。
中身の工夫も公式が明かしています。FFNをMonarch Hadamard構成に置き換え、GQAアテンションにチャネルごとの3タップ因果畳み込みを足し、18,432スロットのハッシュ化された2-gram / 3-gramメモリを参照し、残差を4レーンに分けて流す。要するに、同じ重み数にどれだけ情報を詰められるかを層ごとに稼いでいる設計で、121Mパラメータのモデルが50Mモデル相当の演算量で動く、という結果に効いています。
速度の目安も出ています。Raspberry Pi 5でデコード400〜4,000トークン/秒、プリフィル1,000〜10,000トークン/秒。スマホより非力なボードでこの数字なら、手元の端末で詰まることはまずないと見ていいはずです。
スキーマを渡すと、なぜ壊れたJSONが返らないのか。
ここが私にとって一番大きいところでした。Needle 3は渡されたスキーマからバイトレベルの文法をコンパイルし、生成する全トークンをその文法に拘束します。
普通のfunction callingは「JSONっぽく出力するように学習されたモデル」の確率分布を信じているだけなので、低確率とはいえ構文的に壊れた出力が出る余地が残ります。文法拘束はそもそも構文違反になるトークンを候補から外すので、パースに失敗するという事象自体が起きない。冒頭に書いたリトライ処理は、少なくとも構文エラーを理由にしたぶんは消せます。
ただし消えるのは構文エラーだけです。「JSONとしては完全に正しいが、選んだ関数が間違っている」「引数の型は合っているが値が的外れ」というエラーは全部残ります。ここを混同すると設計を間違えるので、文法拘束はバリデーションの代わりにはならない、と押さえておいてください。
そのために用意されているのが信頼度スコアで、較正済みのヘッドから応答ごとにconfidenceが返ります。デフォルトの下限は0.1です。
86.0%という数字の読み方をどうするか。
公式が出している代表値は、20層モデルのMobile Actionsで86.0%。加えて、DroidCallでfine-tuningするとすべてのサブネットワークが18〜36ポイント上がる、としています。
Show HNでは231点を集めていて、見出しには「DeepSeek V4 Flashに匹敵」と書かれています。ここは割り引いて読む必要があります。DeepSeek V4 Flashは13Bをアクティブにする284BのMoEで、匹敵するとされているのは特定のベンチマークで、しかもそのタスク向けにfine-tuningしたあとの話です。汎用的に並ぶという意味ではない。
実際、公開直後から想定外の入力で妙な関数を選ぶ報告も出ています。しかも高い信頼度を付けたまま選んでしまう例がある。つまりconfidenceは「これなら安全」を保証するフラグではなく、実行するか、確認を挟むか、拒否するかを分けるための入力値として扱うべきものです。
公式ドキュメントに扱えるツール数の上限は書かれていません。裏を返すと、自分のツールセットで精度が落ち始める本数は自分で測るしかない変数ということになります。導入を検討するなら、ここを最初の実測項目に置くのが早いです。
iOSアプリに29MBを足す判断は、何と引き換えか。
サイズの話を上限で考えると判断を間違えます。Appleが定めるビルドファイルサイズの上限は、iOS 9以降を最小ターゲットにするアプリで非圧縮4GB、実行ファイルの合計で80MB。29MBは4GBに対しては誤差です。
効いてくるのは別の線です。App Storeにはセルラー回線でのダウンロードが200MBを超えると確認を挟む挙動があって、いま自分のアプリが何MBか即答できますか。現状120MBなら29MB足しても関係ありませんが、180MBなら話が変わる。ここを越えた瞬間に、電車の中で思い立ってインストールする人の一部が落ちます。
逃げ道としてBackground Assetsで本体から切り離す手はあります。ただし「初回起動直後、オフラインでも意図解釈が動く」ことを要件に置いたなら、切り離した時点でその要件は満たせません。オンデバイスを選ぶ動機がオフライン耐性なのか、単にAPI課金とレイテンシの削減なのかで、ここの答えは反転します。
オンデバイスとAPIの境界線をどこに引くか。
私なら次の順で切ります。
confidenceこの表の1行目が実質的な設計の核で、閾値未満だけをクラウドに回す形にすると、APIコール数はそのまま閾値の調整つまみになります。全件をAPIに投げていた頃と比べて、月次のコストが自分でコントロールできる数字に変わるということです。
副作用の行を分けているのは、さっきの「高い信頼度で誤る例」への保険です。温度設定や送信のような取り返しのつかない操作は、信頼度がいくつであってもローカルの判定だけで実行させない。
Needle 3は「クラウドのモデルを置き換えるもの」ではなく、「クラウドに投げる前に一段挟めるようになった8MBの層」だと捉えるのが正確です。その層を置く価値があるかは、自分のアプリのconfidence分布を測った時点でだいたい見えます。まずは手元のツール定義をそのまま渡して、どのくらいの割合が閾値を超えるかを見るところからだと思います。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 gen
- 3
- 0
-
gen
- 2
- 0
-
gen
- 6
- 0
-
 弾丸旅プラン@りの
- 5
- 0
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
 おうち筋トレ@あすか
- 2
- 0
-
弾丸旅プラン@りの
- 7
- 0
-
 そうた
- 3
- 0
-
- 2
- 0
-
AI脱社畜
- 3
- 0
-
 キャリア迷子@そら
- 2
- 0
-
クロージング師匠
- 1
- 0
-
 カイ@プロダクトマネージャー
- 5
- 0
-
 そう
- 5
- 0
-
- 4
- 0
-
- 3
- 0
-
gen
- 1
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます