問い合わせを「請求書」「返金」「その他」に分けるだけの処理に、毎回クラウドのAPIを呼んでいませんか? Ollayaを使うと、この手の判定を手元のPCで回せます。ただ、日本語で使うならモデル選びに1か所だけ落とし穴があります。
Ollayaは、文章を書かないAIのためのOllamaです
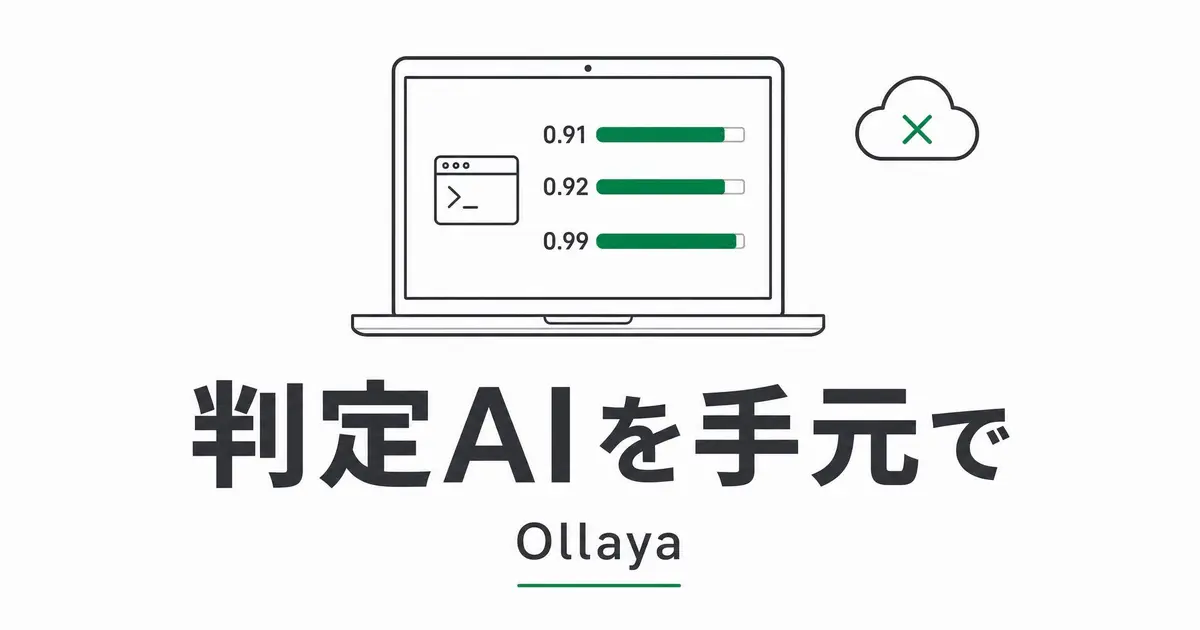
Ollamaが文章を生成するモデルを手元で動かす道具だとすると、Ollayaは判定専用のモデルを動かす道具です。テキストやJSONを渡して「これは返金の依頼か」「緊急度は3段階のどれか」と聞くと、答えを確率付きで返します。TypeSafeのJevと同じ型の判定を、オープンソースのモデルで動かすランタイムと考えると分かりやすいです。
Hacker Newsでは604ポイント、145コメントを集めました。本体はRust製でライセンスはApache-2.0、READMEには「OllamaともTypeSafeとも無関係の独立プロジェクト」と明記されています。
インストールから最初の判定までは2行です。
curl -fsSL https://ollaya.dev/install.sh | sh
ollaya run winnow:e4b --preset triage "Third time this year you've double-charged me. Refund it today or I'm cancelling and moving to a competitor."READMEに載っている出力例では、intent が refund で0.91、is_urgent が yes で0.92、churn_risk が yes で0.99と返ってきます。文章は1文字も生成されません。返ってくるのは確率付きの値だけなので、if文の条件にそのまま書けるんですよ。
コマンド体系もOllamaと同じ手触りです。ollaya pull で取得、ollaya list で一覧、ollaya ps で稼働中のモデル確認、ollaya stop で停止。--preset には triage のほかに email、guard、moderation、router、agent が用意されています。
Ollayaのモデル選びは、GPUの有無で決まる
収録モデルは複数ありますが、主力は laya、winnow、kev、decider の4系統です。公式サイトとリポジトリの資料から、判断に要る数字だけを並べます。
layawinnow:e4bkev:9bdecider:4bnli正答率は、Ollayaが共通で使っている判定テスト(400件、2,000問)での値です。応答時間は公式サイトの掲載値で、laya と winnow:e4b はRTX 4090で測った数字です。
READMEの案内ははっきりしていて、NVIDIAのGPUがないなら laya から始めてください、とあります。winnow:e4b は推奨モデルですが、GPUの載ったマシン向けです。MacではGGUF形式のモデルがllama.cpp経由でMetalを使って動きます。
手元のマシンにGPUは載っていますか? 載っていないなら、最初の1本は laya で決まりです。
日本語の問い合わせ振り分けで、Ollayaはどこまで使えるか?
表の右端の列が、日本語で使うときの分かれ目です。各モデルの資料を読むと、decider はモデルカードで「英語のみ」、nli も英語のみです。winnow はGemma 4をベースにした微調整モデルですが、資料に日本語での評価は載っていません。
多言語対応を明記しているのは laya の多言語版だけです。mmBERT-baseを元にした322Mの小さなモデルで、100以上の言語に対応しています。laya を指定すると、入力の言語を見て英語版か多言語版かを自動で選ぶルーターとして動きます。
問題は精度です。独立したベンチマーク「jevbench」の結果をまとめたexplainx.aiの記事によると、laya の421M版(英語版)は30.25点で、Jev本家の63.29点の半分以下でした。Hacker Newsのコメント欄でも、込み入った問い合わせで精度が落ちるという指摘が出ています。
私の見立てでは、laya に任せられるのは「どう見ても請求書の依頼」「どう見てもスパム」のように、確信度が高く出る一部だけです。winnow:e4b に日本語を投げてみる価値はありますが、使えるかどうかは自分のデータで確かめるしかありません。
あなたの受信箱に届く問い合わせのうち、人が見て一瞬で分類できるものは何割くらいでしょうか? その割合が高いほど、ローカルの判定モデルが効く範囲も広がります。
Jevのコードをローカルに向けるなら、環境変数3つ
すでにJevのAPIを呼ぶコードがあるなら、移行は環境変数の書き換えだけで済みます。Ollayaの /v1/systemone と /v1/models はTypeSafeのAPIと同じ形式で、公式サイトには「TypeSafe公式Python SDK 0.7.1が無改修で動く」と書かれています。
export TYPESAFE_BASE_URL=http://localhost:11435
export TYPESAFE_API_KEY=local
export TYPESAFE_DEFAULT_MODEL=laya
TYPESAFE_API_KEY は任意の文字列で動きます。サーバーは既定で 127.0.0.1 の11435番ポートで待ち受けます。社内のほかの端末から使うなら、待ち受け先を OLLAYA_HOST で変え、OLLAYA_API_KEY を設定してBearer認証をかけておくと安心です。
SDKを通さずに試すなら、ollaya serve を立ち上げてcurlで叩くのが早いです。日本語の問い合わせを投げる例を書いておきます。
curl http://localhost:11435/v1/systemone \
  -H "Content-Type: application/json" \
  -d '{
    "model": "laya",
    "state": {"subject": "請求書について", "message": "先月分の請求書を再発行してもらえますか"},
    "questions": {
      "intent": {
        "type": "choice",
        "instructions": "問い合わせの目的は何か",
        "criteria": {"invoice": "請求書や領収書がほしい", "refund": "返金してほしい", "other": "それ以外"}
      }
    }
  }'
返ってきたら、まずレスポンスの model を確認してください。API仕様書によると、ルーターを指定したときはここに実際に答えたモデル名が入ります。日本語の入力に laya:multilingual が答えていれば、振り分けは狙いどおりです。応答時間まで見たいなら、同じ形式で /api/decide に送ると total_duration や振り分けの情報が付いてきます。
質問セットを毎回JSONで送るのが面倒なら、Modelfileに焼き込めます。
FROM laya
QUESTIONS ./triage.json
PARAMETER precision fp32
ollaya create my-triage -f Modelfile で登録すれば、以降は my-triage を指定するだけで同じ質問セットが使えます。
Ollayaを入れる前に、ラベル付きの問い合わせ100件を用意する
公式の0.722も0.361も、Ollayaのテストセットで測った数字です。あなたの会社に届く日本語の問い合わせでの数字ではありません。
私が判定モデルを入れるときは、コードより先にテストを作ります。過去の問い合わせを100件ほど抜き出して、人の手で正解ラベルを付けておく。それを1件ずつ ollaya run laya -q @questions.json --format json に流し、正解率と confidence の分布を見ます。
分布が見えたら、確信度の高いものだけをローカルで確定させ、残りをJevやLLMに回す線を引けます。線の位置は公式の数字からは決まりません。手元の100件が決めます。
過去の問い合わせを100件、いますぐ抜き出せますか? そこまで用意できれば、毎回のAPI呼び出しのどこまでを手元のPCに移せるかは、一度流すだけで見えてきます。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 ぬまた
- 3
- 0
-
 Mako
- 3
- 0
-
 村井
- 6
- 0
-
 千賀
- 4
- 0
-
コードを読まないAIエンジニア
- 1
- 0
-
- 1
- 0
-
 かなえ@脆弱性診断
- 2
- 0
-
- 5
- 0
-
 にくたま
- 6
- 1
-
 gen
- 3
- 0
-
- 1
- 0
-
 さわこ
- 6
- 0
-
 みほ
- 5
- 0
-
AI脱社畜
- 2
- 0
-
- 5
- 0
-
gen
- 5
- 0
-
- 4
- 0
-
gen
- 3
- 0
-
- 3
- 0
-
 もえ@丁寧な生活
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます