
人には読めないAIの中身の数字を、OpenAIのGPT-6 Astraが読んで書き換え、小さなAIを作ったり、既存のAIを直したりした研究があります。MIT CSAILのRikiya Takehiさんら4人が2026年11月2日に公開した、Weight-Space Programmingです。学習し直さずにAIを直せるとしたら、何がどこまで直るのでしょうか?
Weight-Space Programmingとは何か?
AIの中身は、大量の数字の集まりです。この数字を重み(パラメータ)と呼び、小型のAIでも数億個あります。ふつうは、答えのずれが減るように数字を少しずつ調整する作業を何百万回も繰り返して決めます。この自動調整が学習です。
学習で決まった数字は、人が眺めても意味が読めません。この研究では、その数字をAstraが読み、プログラマーがコードを書くように直接書き換えました。
「AIがAIを開発した」と聞くと大げさに聞こえますが、一から作ったのはゲームや囲碁を遊ぶ小さなAIで、いちばん大きいものでも重みは約148万個です。もう1つは、既存の小型AIの不具合を直した例です。

GPT-6 Astraは、どんな手順でAIの中身を読み書きしたのか
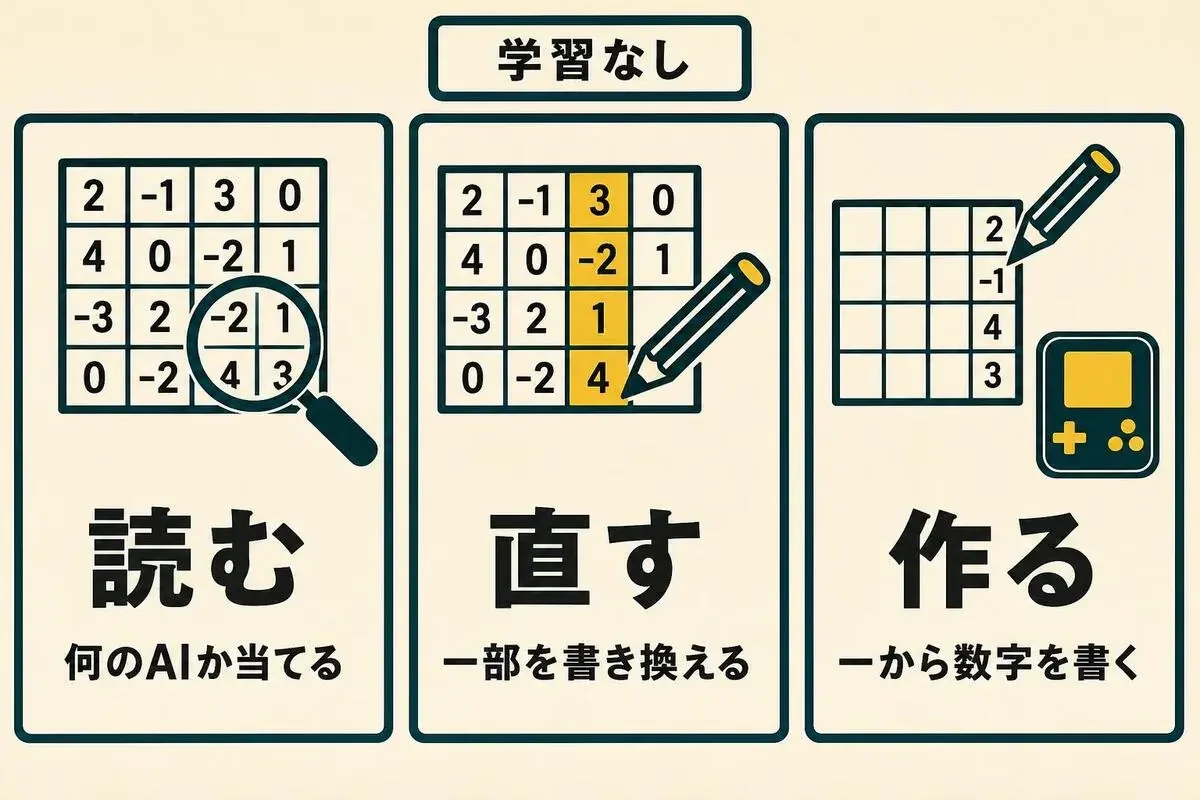
GPT-6 Astraは、OpenAIが2026年9月3日に発表したモデルです。研究者は、OpenAIのプログラミング用ツール(Codex CLI)からAstraを呼び出しています。どの実験でも学習は禁止で、Astraは数字を読んで考え、どこをどの値に変えるかを書いて返します。
作業は3種類です。
- 読む: 盤面とボタンの説明(ゲーム名は伏せる)と、17,253個の重みをそのまま文字で渡し、何のゲームのAIかを当てさせた。4つのゲームのAIを全部当てた
- 直す: AIを実際に動かして結果を見られる回数に上限を決め、結果から原因の見当をつけて書き換える。このあと紹介する小型AIの修理がこれ
- 作る: 全部0の重みから始め、ゲームのルールを読んで手順そのものを書き込む
学習なしで一から作った、ゲームと囲碁のAI
作る実験では、研究用の簡単なゲーム集MinAtarから3つのゲームを使いました。ブロック崩しのBreakoutでは、Astraにゲームのルールとソースコードを渡し、重みは全部0から始めています。Astraはツールも電卓も使わず、1回の返答(約8分)で数字を書き込みました。0以外の値を入れた重みは、20,486個のうち815個だけです。
AIは数字の計算を何段も重ねて答えを出し、その1段を層と呼びます。Astraは1段目の層でボールの落ちる先を計算し、2段目の層でパドルをそこへ動かす手順を組みました。
たとえば1段目のある計算には、「ボールが今このマスにあるなら、何列目あたりに落ちてくるか」をマスごとの数字で置き、そこからパドルのいる列を引き算するように数字を入れています。2段目は、その差がプラスならパドルを右へ、マイナスなら左へ、ほぼ0ならそのまま、と決めます。プログラムなら数行で書く判断を、表計算のセルを埋めるように数字で書き下したわけですね。
比べる相手はPPOです。ゲームを何度も遊ばせて、点につながった動きを強める練習方法(強化学習)の代表的な手法ですね。研究では、ゲームの1コマごとにボタンを1回選ぶ練習を1億回させたPPOと、5億回させたPPOの2通りを用意しました。Breakoutの平均点は、1億回のPPOが15.8点、5億回でも25.3点、Astraが書いたAIは517.4点でした。ただ、ほかの2つのゲームでは5億回のPPOのほうが上です。
なぜBreakoutでは練習したAIより強くなるのか? ルールが短いコードで書けるほど単純だから、と私は見ています。ボールの落ちる先を計算すればいいと分かっているなら、手順を書くほうが早いんですよ。
囲碁では、約148万個の重みに石の取り合いの判断を書き込みました。書いたAIを、対局させて結果を見ながら50回まで手直しすると、2,000万局練習させた同じ大きさのPPOのAIにも勝っています。
小型AIの思考ループは、どう見つけて消したのか
Qwen3.5-0.8Bは、Alibabaが公開している重み約8億個の小型AIです。答える前に考える文章を書く「思考モード」を持っています。
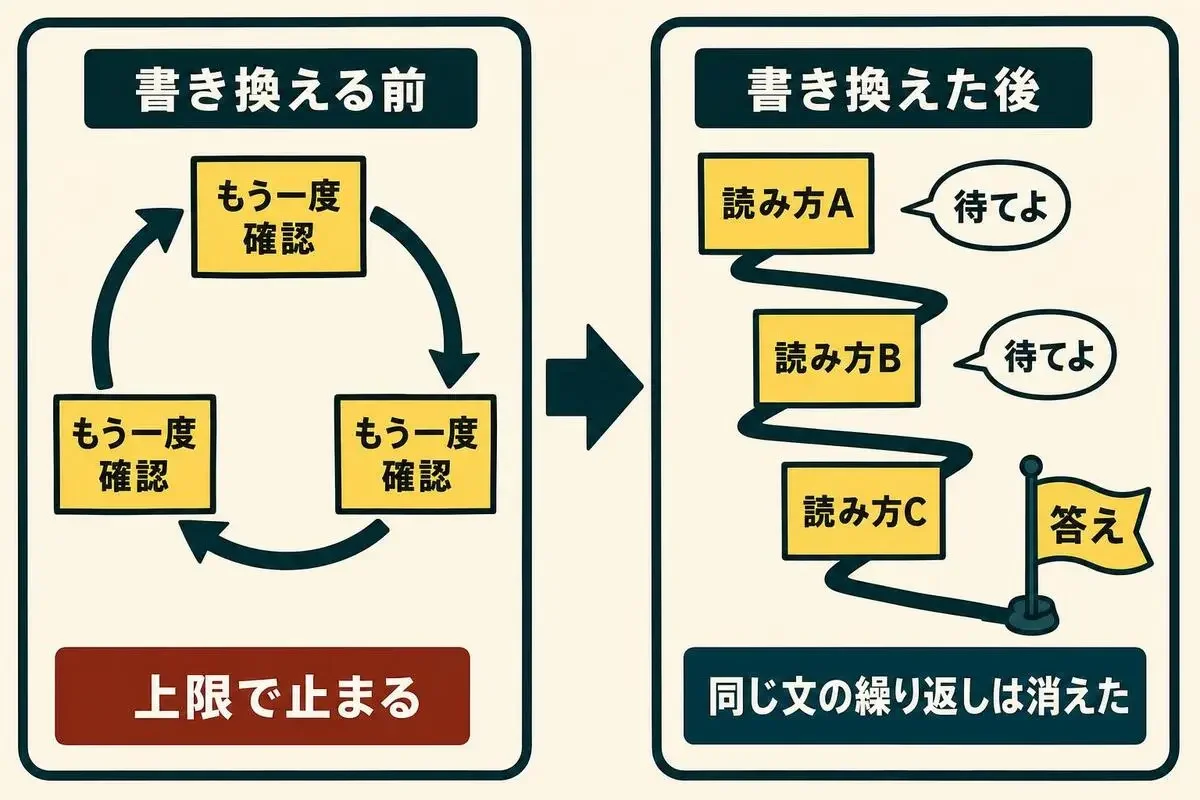
考える量には上限があり、トークン(AIが文章を区切って扱う単位。英語ならおおよそ単語1つ分)の数で決まります。このAIは、同じ確認の文を何十回も繰り返したまま答えにたどり着かず、上限で止まることがありました。ここではこれを思考ループと呼びます。
Astraに渡されたのは、テストとは別の練習問題約1万5千問と、AIを実際に動かして結果を見る道具です。道具は使える回数に上限があり、1回で最大512問を解かせるか、文章を読ませてAIの各層の途中の数字を取り出せます。道具を50回まで使えた実行では、次の順に進みました(10回・25回までの実行もありましたが、点の伸びは小さめでした)。
- 練習問題のうち最初に96問を解かせると、85問が上限で止まった。最後まで答えた問題は全部正解だった
- AIは考えている間、層ごとに途中の計算結果を次の層へ渡している。考えが先へ進んでいる場面と、同じ確認を繰り返している場面で、この途中結果を比べた。すると層19と層15の出す結果に、繰り返している場面でだけ強くなる特徴があった
- その特徴をいちばん強く出していた計算の部品1個だけを止めると、32問で正解が3問から5問になった。効果は小さかった
- 部品1個を止める代わりに、その特徴だけが途中結果から消えるように、2つの層の重みを書き換えた。まだ使っていない128問で試すと、正答率は8.6%から32.8%に上がった(この時点では2つの層の数字を広く少しずつ変えた版で、最終版より範囲が広い)
- 書き換えの強さを変える、層を1つずつ試す、同じ量だけでたらめに書き換えた場合と比べる、の3つで、効いているのが本当にこの特徴かを確かめた
最終的に書き換えたのは層15と層19の中の131,072個で、全体の0.016%です。Astraとのやり取りは158往復、約20時間かかりました(うち約5時間はサーバーの待ち時間)。
ブログの評価では、数学の問題集MATH-500の正答率が7.9%から48.1%、算数の文章題GSM8Kが13.8%から67.1%に上がっています。
賢くなったから点が上がったのでしょうか? 練習問題1,152問での確認では、新たに正解できた579問のうち576問が、元のモデルでは上限で止まっていた問題でした。元のモデルが最後まで答えた問題の正答率は、変わっていません。解けるのに最後まで書けなかった問題が、書けるようになったんですよ。
Qwen3.5-0.8Bで直せたのは、原因が1か所にある不具合だけ
同じ研究では、Googleの小型AIのGemma 3 270Mでも数学の点を上げようとしました。結果は、MATH-500で約1ポイントの上昇にとどまっています。このAIは上限で止まることが少なく、間違いの原因が1か所の壊れ方ではなく、ふつうの計算ミスの積み重ねだったからです。
Qwen3.5-0.8Bで直ったのは、決まった場面で決まった壊れ方をする不具合でした。全体の力が足りないAIは、この研究のやり方では伸ばせていません。著者は今後の見通しとして、学習し直さずにAIを良くすることや、仕込まれた悪い動き(バックドア)を中身から見つけることを挙げています。
「AIがAIを直した」というニュースを見たら、直ったのは決まった壊れ方なのか、全体の力なのかを確かめてみてください。それだけで、話の大きさを見誤らずに済みます。
書き換えたQwen3.5-0.8Bを手元で動かすと、本当に直っていたか?
公開されている書き換え後のモデルと元のモデルを、手元のMacのCPUだけで動かしました。軽くするため、数字の細かさを落とした版(量子化)を使っています。算数の文章題GSM8Kのテスト問題の先頭20問を同じ設定で各1回解かせ、考える量の上限は8,192トークンにしました。
まず、2つのモデルの数字を全部比べると、違っていたのは層15と層19の中の、ブログが説明したとおりの部分だけでした。
どちらも正解がブログの数字よりずっと少ないのは、手元では考える量の上限を短くしたためと見ています。研究の練習問題(算数と数学の混合)では、書き換えたモデルが正解したときに考えた量の中央値が9,172トークンで、手元の上限8,192を超えています。そのため、この表で見てほしいのは正解の数より、下の2行の繰り返しの数です。
1問目は「アヒルが1日16個の卵を産み、3個を朝食に、4個をマフィンに使って、残りを1個2ドルで売る。1日いくらになるか」という問題です。元のモデルは、ここでこうなっていました。
*   Wait, let me double check if "eats three" means she eats 3 units of food (like milk) and makes muffins? No.
*   Let's check if there is any other interpretation. Maybe "three" refers to the number of eggs eaten by the ducks themselves. Yes.
*   So, $16 - 3 = 13$.
「待って、"eats three"は牛乳のような食べ物を3つ食べてマフィンを作るという意味か確かめよう。違う」「ほかの解釈はないか。"three"はアヒル自身が食べた卵の数かもしれない。そうだ」「つまり16引く3は13」という3行です。この3行が最後まで62回続きました。引き算自体は合っているのに、確認を回し続けて答えを書かないんです。
書き換えたモデルでは、同じ行を10回以上繰り返す問題がなくなりました。代わりに「Wait(待てよ)」と言って問題の読み方を変え続けます。1問目なら「3羽のアヒルを食べる?」「16羽買った?」と別の解釈を次々に試し、そのまま上限に届きました。
上限を4倍の32,768トークンに上げ、打ち切られた17問のうち最初の4問を解き直すと、3問が答えまでたどり着きました。CPUでは1問に最大30分あまりかかるため、解き直したのはこの4問だけです。
ただ、解き直して答えた3問のうち、正解は1問でした。問題の読み違いも元のままで、8,192トークンで答えた問題の1つは「週に3回、1回に3本ずつ60メートル走る」の「週3回」を落とし、540メートルを180メートルと答えています。同じ条件で動かしても実行ごとに結果は揺れるので、20問の数字は傾向として見てください。
手元でも、直ったのは思考ループ(同じ確認を回し続けて止まること)だけ、というのが私の見立てです。
書き換えたモデルは、誰でもダウンロードして使えるライセンス(Apache 2.0)で公開されています。

元のモデルはQwen/Qwen3.5-0.8B、Astraとのやり取りの記録はGitHubのログで読めます。
- 3
- 0
家電メーカーで、音声リモコンに載せる小さな言語モデルを調整しています。論文やニュースの数字は、手元の小さなモデルで確かめてから信じる派。学習し直さずにモデルを直す話と、エッジで動くAIの話を書きます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 むみま
- 2
- 0
-
 bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
むみま
- 9
- 0
-
bokuwalily
- 1
- 0
-
 えかさ@データサイエンス解析
- 3
- 0
-
bokuwalily
- 2
- 0
-
 あおいパスタ
- 7
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
 AI集客@ルイ
- 7
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 3
- 0
-
AI脱社畜
- 4
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 1
- 0
-
 AI経営者の参謀@ひで
- 8
- 0
-
bokuwalily
- 0
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます