
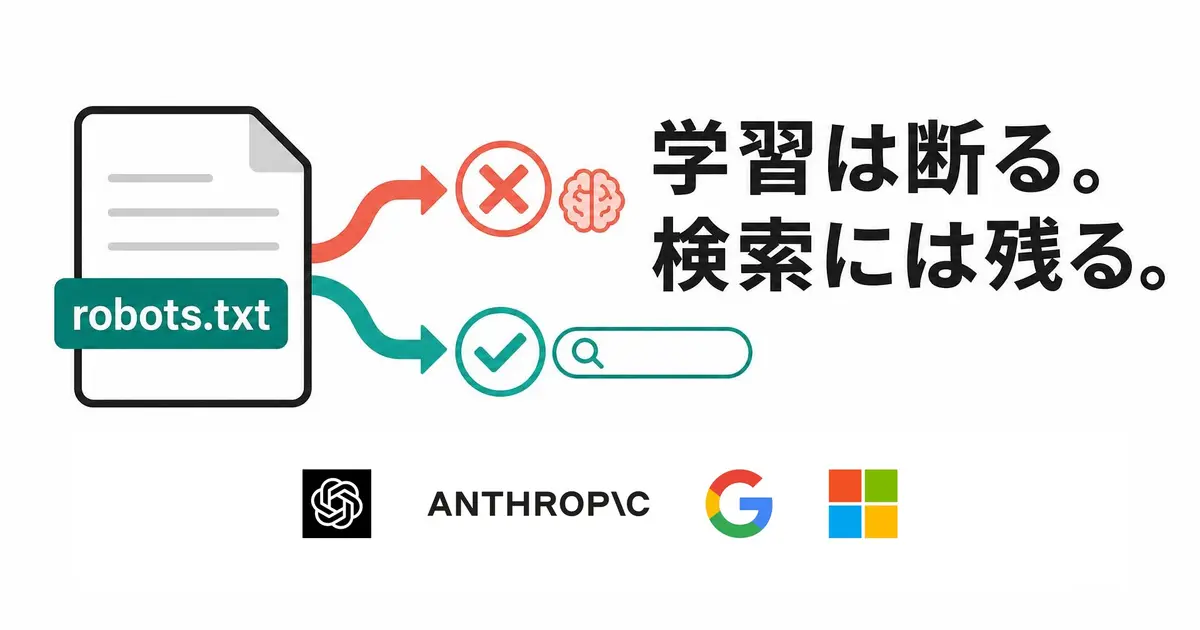
各社の説明では、robots.txtでAI学習だけを拒否しても、ChatGPT・Claude・Perplexityの検索や、GoogleのAI Overviewへの掲載は減りません。流入が減るかもしれないのは、GoogleのGeminiアプリだけです。
学習には使われたくないけど、AI検索からの流入は減らしたくない、と迷っていませんか?そのまま貼れる書き足し分と、Googleで学習と流入のどちらを取るかの決め方をまとめました。
2026年10月30日には、OpenAI・Google・Microsoftが、AI学習の可否をrobots.txtの1行でまとめて伝える仕組みへの対応を発表し、Anthropicも実装を始めたと表明しました。この1行も含めて、今日足す分を見ていきます。
学習だけ断って検索に残す、robots.txtの書き足し方
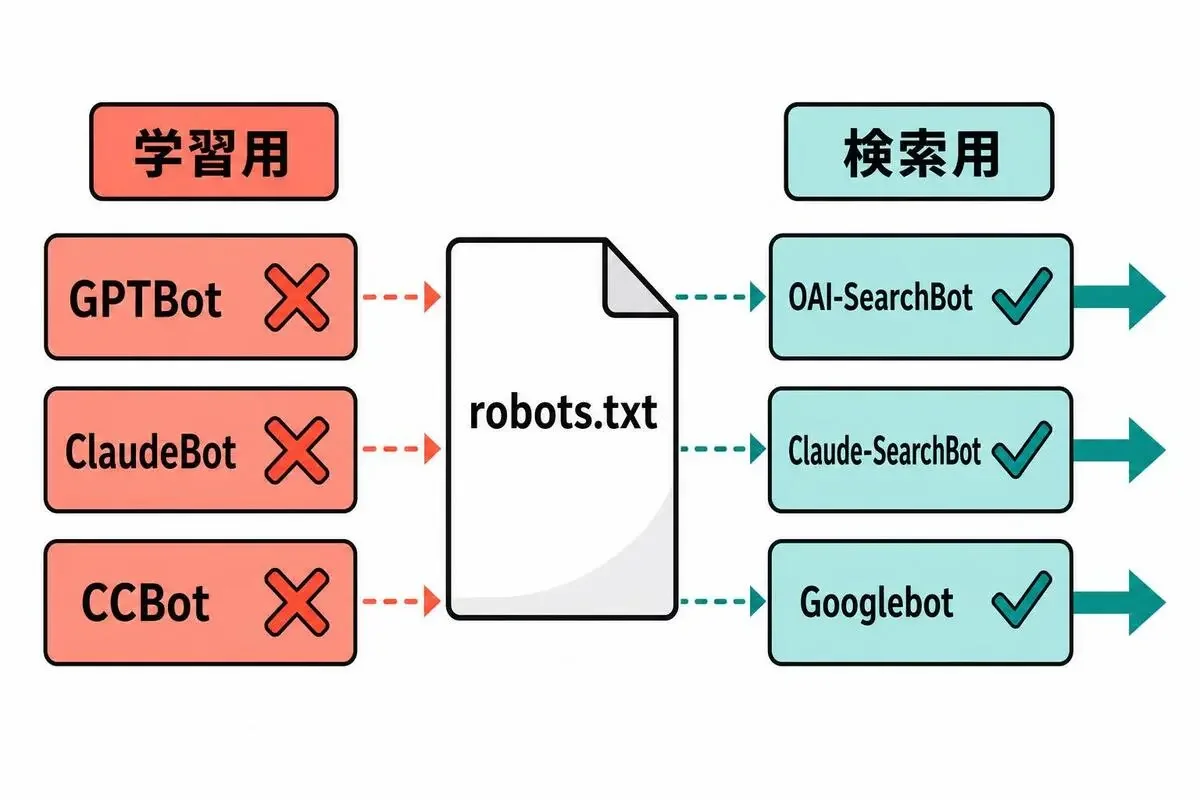
AIの会社は、学習用と検索用でクローラーの名前を分けています。学習用はOpenAIのGPTBot、AnthropicのClaudeBot、Common CrawlのCCBotで、検索用はOAI-SearchBot(ChatGPTの検索)、Claude-SearchBot、Googlebotです。止めるのは学習用だけです。
User-agent: の行から次の User-agent: までの1まとまり(グループ)を、今のファイルの末尾に足します。
# 今あるrobots.txtの末尾に足す(User-agent: * のグループは触らない)

# 共通の1行。この名前の下のDisallowは「学習に使わないで」という意味
User-agent: __usage_ai-training
Disallow: /

# OpenAIの学習用。今日から効く(検索用のOAI-SearchBotは止まらない)
User-agent: GPTBot
Disallow: /

# Anthropicの学習用。今日から効く(検索用のClaude-SearchBotは止まらない)
User-agent: ClaudeBot
Disallow: /

# Common Crawl。多くのAIの学習データの元になっている
User-agent: CCBot
Disallow: /

# Googleの学習は、この4グループでは今日は止まらない(Google-Extendedの節で決める)
__usage_ai-training は、会社ごとのクローラー名とは別に、「AI学習に使ってよいか」をまとめて伝える共通の名前です。この名前のクローラーは存在せず、草案もこの1行を訪問を止める指示とは定めていません。各社が、集めたページを学習に使うかを決めるときに読みます。
ひとつ注意があります。共通の1行は2027年にGoogleにも効く予定で、そのときGeminiアプリの出典に出ることも断った扱いになる見込みです。Geminiアプリからの流入も残したいなら、Google-Extendedの節の1グループも一緒に足します。
今日から効く行と、2027年に効き始める行
名前で書いた3つは今日から、共通の1行は各社が読み始めた日から効きます。
効き始めたあとも、名前で書いた行は消しません。GPTBot・ClaudeBot・CCBotの行はそれぞれの訪問そのものを止めますが、共通の1行は訪問を止める指示ではないからです。
確認できた限り、共通の1行に対応を表明したのはこの4社です。ほかの会社は、たとえばAppleの Applebot-Extended やMetaの Meta-ExternalAgent のように、各社が学習などに使うと説明している名前を同じ形で足します。
全員向けのワイルドカード指定は書き換えない
* に Disallow: / を足すほうが早く見えますが、それだとGooglebotまで止まり、検索から消えます。
手元でrobots.txtの判定プログラム(Pythonの標準ライブラリ)に読ませて、/admin/ だけを除外したファイルに上の4グループを足す前と後を比べても、Googlebot・Bingbot・OAI-SearchBot・Claude-SearchBot・PerplexityBotの判定は変わりませんでした。
__usage_ai-training の1行は、クロールの指示ではない
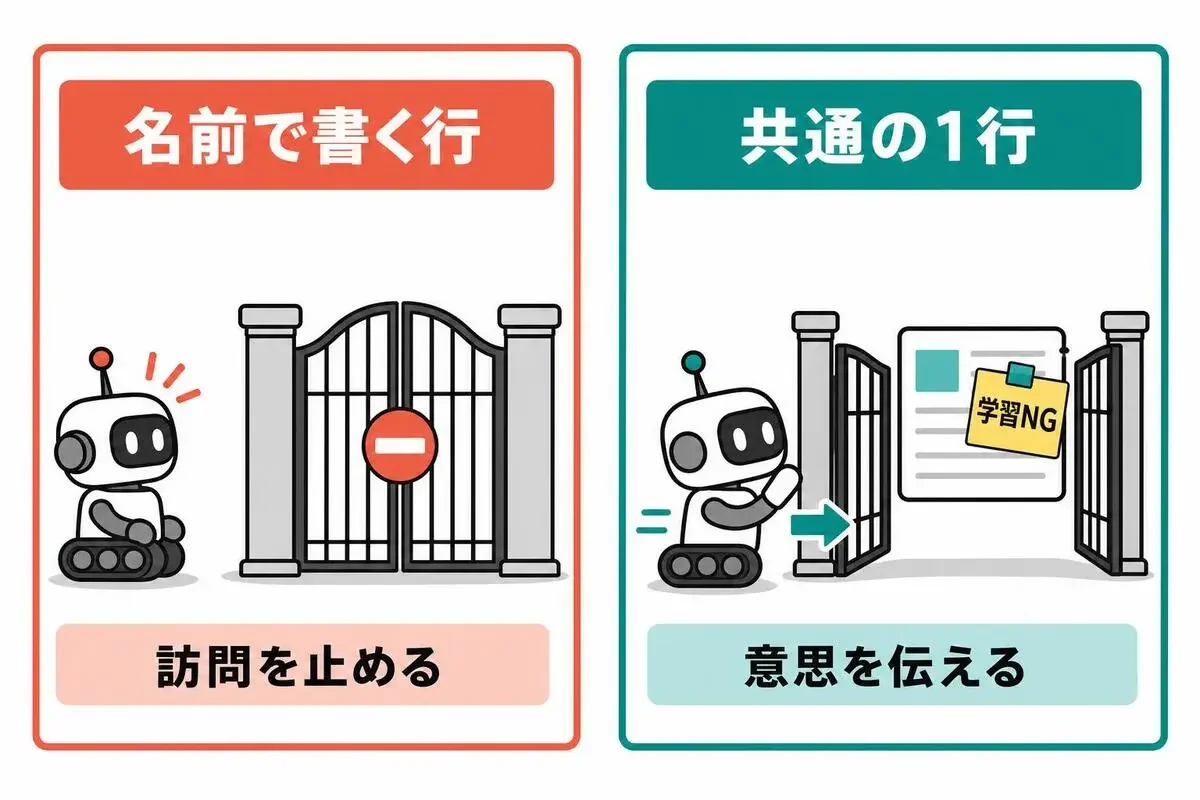
この名前は、ネットの技術ルールを決める団体(IETF)に出された、まだ案の段階の文書(草案)にあります。草案は、この1行をクロールの指示ではなく、学習に使うかの意思表示だと定めています。正式な標準ではありませんが、大手各社が対応を表明していて、草案のままでも読む予定です。
学習用のクローラーに来てほしくないなら、共通の1行に頼らず、これまでどおりボット名で Disallow を書きます。
GPTBotとOAI-SearchBotは何が違うのか?
OpenAIの説明では、GPTBotは学習用、OAI-SearchBotはChatGPTの検索用で、GPTBotを断ってもChatGPTの検索結果には影響しません。
ユーザー操作時の3つは、人がAIに質問したときに、その場でページを読みに来るものです。学習用として各社が挙げている名前ではないので、今回は触りません。PerplexityBotも、Perplexityの説明では学習には使われないので、止める必要はありません。

GoogleとMicrosoftは、ここまで単純にはいきません。
Google-Extendedを断ると、AI Overviewの流入は減るのか?
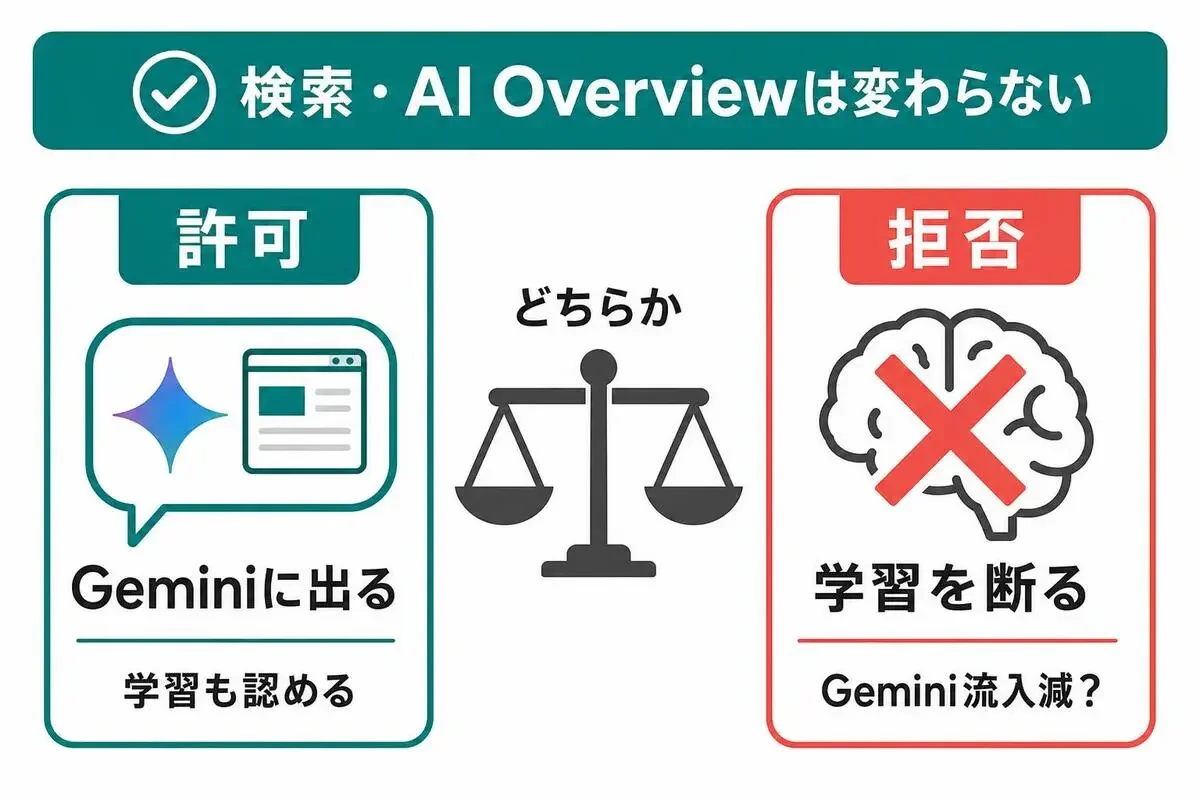
Googleで学習を断るときに使う名前がGoogle-Extendedです。共通の1行も、2027年からはGoogle-Extendedを断ったのと同じ扱いになる予定なので、断ると何が減るかを確かめておきます。
Googleの説明では、Google-Extendedを断ってもAI OverviewとAIモードへの掲載には影響しません。Googleは学習専用のクローラーを持たず、既存のクローラーが集めたページをGeminiの学習などに使ってよいかを、Google-Extendedで指定させています。検索の掲載にも順位にも影響しないとクローラーの文書にあり、AI OverviewとAIモードはAI機能の説明のとおり通常の検索の仕組みで扱われます。
減るかもしれないのは、Geminiアプリからの流入です。AIが回答を作るときにページの内容を材料に使うことをグラウンディングと呼び、Google-ExtendedはGeminiの学習とGeminiアプリでのグラウンディングをまとめて扱います。
Googleの発表では、共通の1行で断ってGoogle-Extendedを書いていないサイトは、Google-Extendedも断った扱いにする予定です。Geminiアプリに残りたいなら、明示的に許可します。
# Geminiアプリに残りたいときだけ足す(Geminiの学習も許可することになる)
User-agent: Google-Extended
Allow: /
許可すれば学習も認め、拒否すればGeminiアプリの流入が減るかもしれません。片方だけは選べないので、GA4の参照元で gemini.google.com からの流入がどれくらいあるかを見てから決めると、社内で説明しやすくなります。
自社ならどちらを取りますか?私なら、出典に社名が出ると問い合わせにつながるサイトは許可、記事そのものが商品のメディアは拒否にします。拒否してGeminiの学習を今日から止めるなら、Google-Extendedに Disallow: / です。
BingのAI学習と回答は、ページ単位で分けられる
Bingについて今日急ぐのは、noarchive や nocache のmetaタグでAIへの利用を制限していたサイトだけです。ページのHTMLを検索すれば使っているか分かります。2027年3月1日から読まれなくなるので、それまでに新しい指定へ移すか、Bing Webmaster Toolsの暫定設定(2026年12月15日開始)に登録します。
Microsoftは、学習と、回答の材料に使うこと(BingやCopilotでAIが答えるとき)を分けて指定できます。学習は共通の1行で足ります。回答への利用まで断りたいときや、ページごとに変えたいときだけ、ページ側に書きます。
<!-- 学習を断る -->
<meta name="Bingbot" content="ai-training:disallow">
<!-- 回答の材料に使うことも断る -->
<meta name="Bingbot" content="ai-grounding:disallow">Bingがrobots.txtとページの指定を読み始めるのは、どちらも2027年2月1日からです。ページの指定はrobots.txtより優先され、通常のBing検索の掲載は変わらないとMicrosoftの発表にあります。回答への利用を断ると、その分AIの回答での露出は減ります。
robots.txtに書き足したあと、効いているかをどこで確かめる?
今日の時点で確かめられるのは、名前で書いた3つと、流入が減っていないかです。
- Search Consoleのrobots.txtレポート。取得日時が書き足した後で、エラーがなければ、新しいファイルはGoogleに届いています。検索パフォーマンスのクリック数も、書き足す前と比べます。AI Overviewからのクリックはここに含まれます
- サーバーのアクセスログ。数日たっても、GPTBotやClaudeBotがrobots.txt以外のページを取りに来ていませんか?来なくなれば効いています。見られなければエンジニアに頼みます
- GA4の参照元。
chatgpt.comやperplexity.aiなどからの流入が、書き足す前より減っていないかを見ます
共通の1行とGoogle・Microsoftの学習の扱いは、各社が読み始めるまで変わらないので、外からは確かめられません。各社の実装の発表を待ち、そこで gemini.google.com の流入も見直します。
使う前の注意
- robots.txtは各社が自主的に守る取り決めで、強制力はありません
- すでに学習に使われた分は、今から書いても消えません
- 共通の1行は草案なので、書き方が変わる可能性があります
今日やるのは、4グループを末尾に貼り、Search Consoleで取得を確かめるところまでです。Google-Extendedは、Googleが共通の1行に対応する2027年の初め頃までに決めれば間に合います。
- 7
- 0
元広告代理店マーケター。月数千万の広告費を回していた経験を持ちながら、SEO×SNSのオーガニック戦略に特化。AIを活用したキーワード調査・コンテンツ企画・SNS運用分析で、広告費ゼロでも集客できることを証明し続けています。


創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 むみま
- 2
- 0
-
 bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
むみま
- 9
- 0
-
bokuwalily
- 1
- 0
-
 えかさ@データサイエンス解析
- 3
- 0
-
bokuwalily
- 2
- 0
-
 あおいパスタ
- 7
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
 仁科
- 3
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 3
- 0
-
AI脱社畜
- 4
- 0
-
 rock80sbot
- 6
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 1
- 0
-
 AI経営者の参謀@ひで
- 8
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます