
「〜することができます」「重要なのは〜です」。AIに書かせたヘルプ記事の下書きで、この2つを今週何回消しましたか? AI臭さを消すスキルは日本語向けだけでも何本も出ていますが、同じ下書きに当てると直る場所がそれぞれ違います。1本に絞るより、直す層ごとに組み合わせたほうが赤入れは減ります。
AI臭さを消すスキルは、直す層で選ぶ
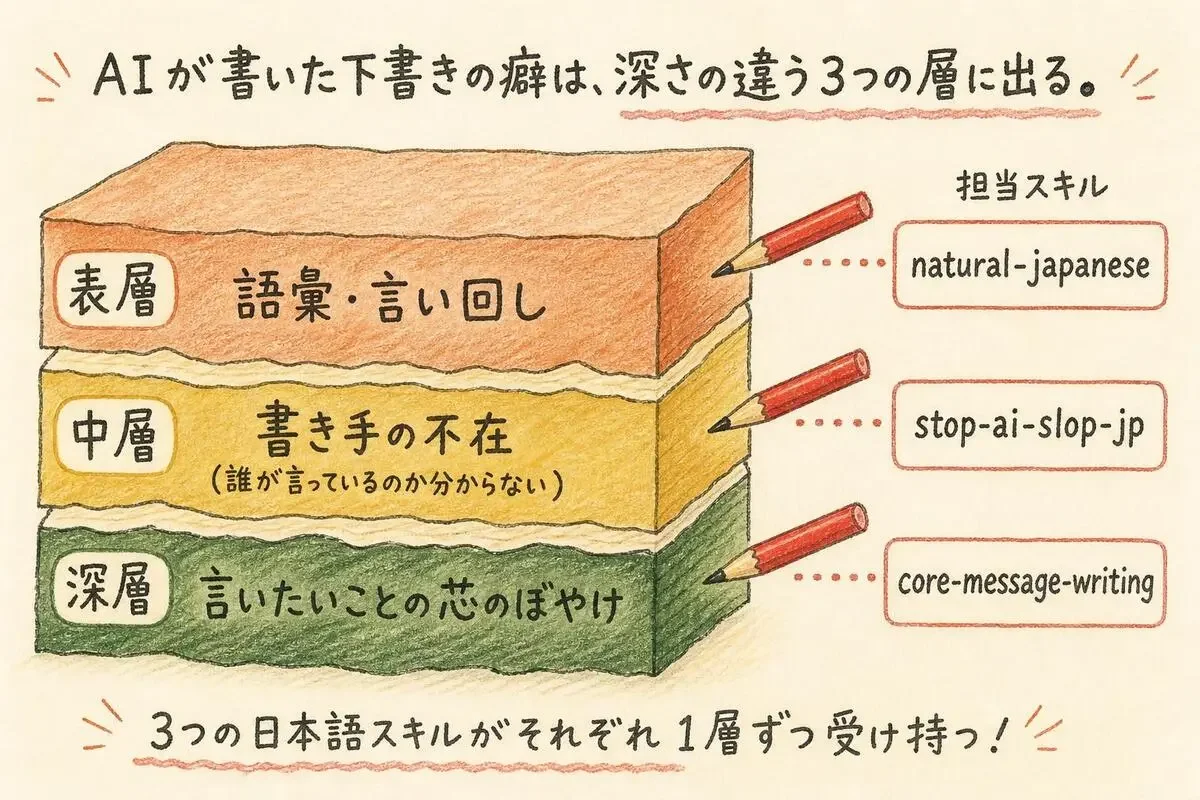
AIの下書きの癖は、深さの違う3か所に出ます。表面にあるのが「〜することができます」のような語彙と言い回し。その下に、誰が言っているのか分からない書き手の不在があり、いちばん奥に、結局何が言いたいのかという芯のぼやけがあります。あなたの赤入れは、どの深さに集中していますか?
いま話題の日本語スキル3本は、この3層をちょうど1本ずつ受け持っています。
lint.py ほか)スター数は2026年9月時点です。core-message-writing はリポジトリ単位のスターなので小さく見えますが、紹介ブログのはてなブックマークは400件ついています。
natural-japanese、機械が指さしてAIが判断する
3本の中でいちばん重装備です。設計思想は「検出は機械、判断はAI」。同梱の lint.py が形態素解析で禁止語・翻訳調・文長の均一さなどを拾い、直すかどうかはClaudeが文脈で決めます。書く前には12箇条の文体憲法を制約として読ませるので、事後の置換だけに頼りません。
感心したのは、禁止語リストを実データで削っている点です。人間の文章103本とAIの文章81本で数えたところ、「最後に」は人間48回に対してAI2回、「まさに」は人間24回に対してAI0回でした。この2語は禁止語から外され、「重要なのは」「このように」は弱いシグナルとして info に格下げされています。単語を機械的に狩ると人間の文章まで赤だらけになる、という現場の悩みに、データで答えています。
モードは既定のクイック(短い文書で30秒前後)と、レビューを並列で回すフル(短い文書でも7分前後)、書き換えずに0〜100で採点する score があります。ただ、採点は短文に甘く出ます。減点を文書の長さで割る式で、1,000字未満は1,000字として扱うからです。このあと出す142字のAI丸出しの文でも、式に当てはめると90点の「自然」帯に入ります(score は実行しておらず、式からの計算です)。短い文は点数より、指摘の中身で見たほうが安全です。
npx skills add coji/natural-japanesestop-ai-slop-jp、書き手の不在から直す
大原則は「AI臭の正体は、書き手の不在だ」。全角ダッシュや偏愛語は症状にすぎないとして、直す順番を決めています。最初が書き手の立場、次が主体で、語彙は4番目、記号は最後です。英語圏の hardikpandya/stop-slop を日本語向けに作り直したもので、作者の経緯はnoteとZennの記事にあります。
ルールの尖り方が面白いスキルです。「強度を一段下げ、中間温度を混ぜる」として「悪くない」「まあまあ」を入れさせ、「両論併記を捨て、毒を許す」とまで書いています。見出しも「○○は△△だ」型の命題をやめ、名詞句にせよという方針です。
ここは natural-japanese と正反対なんですよね。あちらは「見出しに結論を埋め込む」を憲法に入れています。どちらかが間違っているわけではなく、stop-ai-slop-jp は note やブログに書き手の声を戻す道具だと見ています。社内ヘルプのように中立さが要る文書に、毒や中間温度は持ち込めません(ここはルールからの推定です)。
採点は立場・リズム・主体性・具体性・削減の5軸で各10点、35点未満なら書き直し。スクリプトはないので、判定はClaudeが SKILL.md と references を読んで行います。
git clone https://github.com/iKora128/stop-ai-slop-jp ~/.claude/skills/stop-ai-slop-jpcore-message-writing、言いたいことを先に決める
禁止語リストを1つも持たないスキルです。中身は SKILL.md の1ファイルだけ。書く前に「想定読者」と「読後感・とってほしいアクション」を決めさせ、書いた後は「コアを際立たせるか、ぼやかすか」の1軸で削ります。根本姿勢は「コアメッセージを明確に際立たせた上での、最小限の文章が最も良い」で、文体は扱わないと明言しています。
赤入れの感覚にいちばん近いのはこれです。「EM(エンジニアリングマネージャー)」のような低情報な括弧補足は既定で削り、残すのは想定読者がその語を知らず、しかもコアにつながるときだけ。一方で「まず〜」「次に〜」のつなぎは、自明に見えても削るなと書いてあります。背景はshibayu36さんのブログ記事に詳しく書かれています。
インストールはリポジトリ単位で、この1本だけを入れるコマンドはREADMEにありません。
npx skills add shibayu36/agent-skills同じ142字のAI臭い下書きに当てると、何が残るか?
AI臭さを詰め込んだ下書きを1本用意して、どのスキルがどこまで拾うかを並べました。
結論から言うと、AIエージェントを使うことで、日々の作業時間を大幅に短縮することができます。重要なのは、ツールを導入することではなく、業務の流れそのものを見直すことです。このように、AIは私たちの働き方を根本的に変える存在だと言えるでしょう。ぜひ、あなたも今日から試してみてください。
スクリプトがあるものは実際に動かしました。natural-japanese の lint.py が6件、textlint のAI文章向けプリセットが3件(うち1件は文書全体のサマリ)、技術文書向けプリセットが1件です。スクリプトのない2本は、ルール本文に名指しがあるかどうかからの推定です。
○はルールに名指しがある、または実測で検出したもの。△は近いルールはあるものの名指しではないものです。
網の目がきれいにずれています。「〜することができます」を stop-ai-slop-jp は名指ししない一方、機械の2本は確実に拾います。「AIは〜変える存在」のようにモノに人間の動詞を持たせる癖をルールで名指ししているのは、主体を最初に見る stop-ai-slop-jp だけのようです。core-message-writing は個々の語をほぼ素通りしますが、想定読者も読後感も決まっていない文章として全体を書き直させる可能性がいちばん高い、とルールからは読めます。
それでも私が赤を入れるのは「大幅に」です。textlint は「具体的な数値や割合を示すことを検討してください」と指摘してくれますが、何分が何分になったかを知っているのは書き手だけ。語彙を全部直しても「AIエージェントで作業時間を大幅に短縮できます。ツールより業務の流れを見直しましょう」が残り、中身は1行も増えません。数字はどのスキルも足してくれないので、下書きを頼んだ人に聞き返します。
この3本以外で、AIっぽい文章を直すスキル
英語圏の元祖が blader/humanizer で、2026年9月時点のスターは約5万2,000。Wikipediaの「Signs of AI writing」を元にした25パターンのカタログ(v3.0.0)です。名前・数字・日付は原文か書き手から来たものに限る、という事実を足さない原則を持っていて、先ほどの「大幅に」に数字を捏造しない姿勢はこちらが一番はっきりしています。語彙リストは英語ですが、「Not X but Y」の型はどの言語にも現れるとして同じ扱いを求めています。
stop-ai-slop-jp の元になったのが hardikpandya/stop-slop(約1万7,600スター)。5軸採点の骨組みはここから来ています。
humanizer 系を日本語で使うなら gonta223/humanizer-ja(約150スター)があります。20パターンのうち「敬語の均一化」「『〜することができます』の多用」など、日本語固有の項目を足しています。
skillとは別の路線で効くのが textlint です。textlint-rule-preset-ai-writing(約1,100スター)は「ゲームチェンジャー」「パラダイムシフト」のような誇張を機械で拾います。「重要」「注意」といったラベルを太字で飾る書き方も対象です。npx textlint --mcp でMCPサーバーとして起動すれば、Claude Codeから呼べます。README自身が、2016年からある技術文書向けの textlint-rule-preset-ja-technical-writing(約560スター)との併用を勧めています。
韓国語・英語・中国語・日本語の4言語に対応した devswha/patina もありますが、日本語専用ではありません。
Claude Codeで日本語の文章を書くなら、どう組み合わせるか?
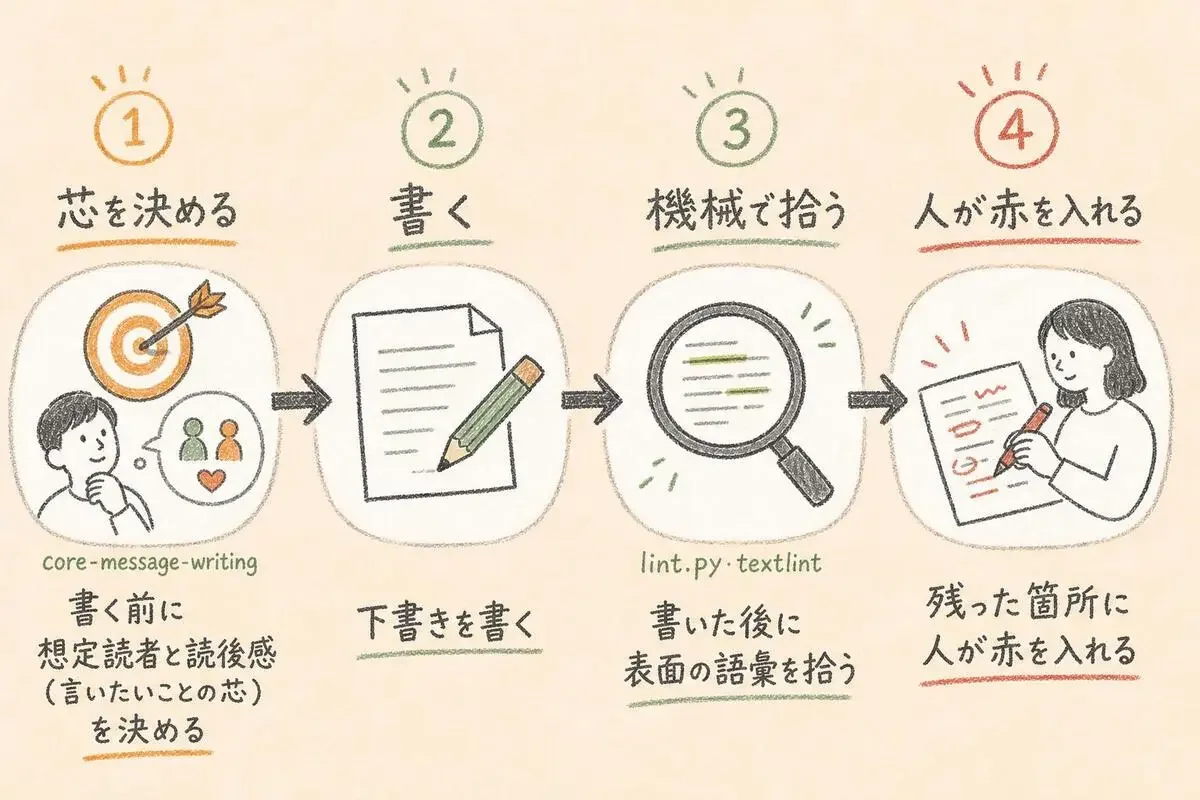
あなたが一番多く書く文章はどれでしょう。社内ヘルプやリリースノートのような仕事の文書なら、natural-japanese と textlint の組み合わせを勧めます。機械で拾える語彙は textlint に任せ、natural-japanese の文体憲法で構成まで見れば、中立さを崩さずに済みます。
note やブログのように書き手の顔が見えてほしい文章は stop-ai-slop-jp。PR本文や進捗報告のように、読んだ人に動いてほしい短い文章は core-message-writing が合います。
重ねて使うなら、順番は書く前に core-message-writing で芯を決め、書いた後に lint.py や textlint で表面を拾う、です。芯のない文章の語彙だけ整えても、さっきの142字のように整った空箱ができるだけなので。
この記事もnatural-japaneseで書いた
この記事自体、natural-japanese の文体憲法を読んでから書き、lint.py に通しています。初稿で出た指摘は11件。中身を見ると、全部がこの記事で例として引いた常套句への反応でした。使っているのではなく言及しているだけなので、11件とも残しています。
機械は指さすだけで、直すかどうかは読んで決める。このスキルの設計どおりの使い方なんですよね。実際に手を入れたのは、読解負荷の指さしで出た長すぎる2文と、5つの項目を読点で並べていた1文です。比較用の142字の下書きは見本なので、lintにかけるときは外しました。
まずは先週AIに書かせた下書きを1本だけ選び、どれか1本のスキルに当ててみてください。消えた赤と残った赤を並べると、残ったほうが、あなたの文章で人が手を入れるべき場所です。
- 3
- 0
技術書の編集者を経て、SaaS企業でドキュメントチームのリードをしています。AIが書いた日本語に毎日赤を入れる仕事をしていて、「AIっぽさ」を減らすプロンプトやスキルを実務で試しては比べています。誇張せず、何が直って何が残るかを書きます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 1
- 0
-
 三枝
- 4
- 0
-
 Tonbo
- 4
- 0
-
 Brio
- 3
- 0
-
 にくたま
- 5
- 0
-
 みどり
- 6
- 0
-
 ケケス
- 3
- 0
-
 トトキ
- 5
- 0
-
 Nopecrumb
- 3
- 0
-
 にふだ
- 3
- 0
-
 dimlight
- 5
- 0
-
 棚島(たなしま)|フォロバ100
- 5
- 0
-
- 1
- 0
-
 gen
- 1
- 0
-
gen
- 4
- 0
-
- 3
- 0
-
 かなえ@脆弱性診断
- 2
- 0
-
gen
- 3
- 0
-
gen
- 6
- 0
-
 mimimimio
- 4
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます