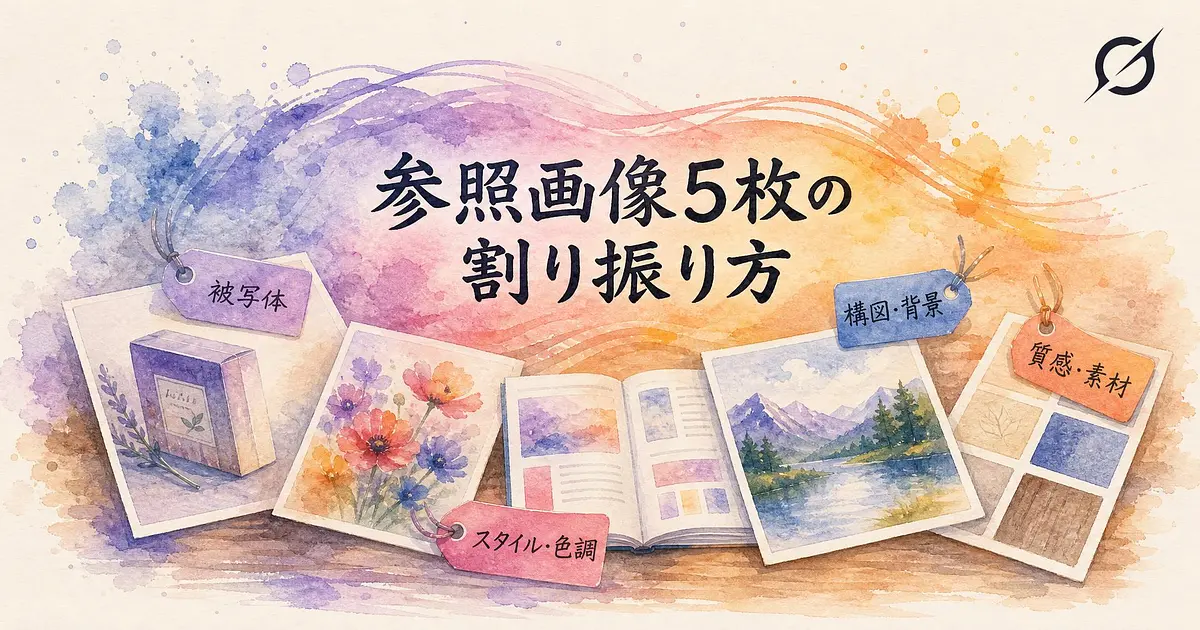
手元の写真を5枚まとめてGrok Imagineに渡したのに、狙った絵から遠ざかった経験はありませんか?
参照画像は増やすほど効くように見えて、1枚ごとに何を借りるかを決めないと、写真同士が同じ役を奪い合います。
Grok Imagine 2.0の5枚の枠を役割で埋める組み立て方と、その効き方を確かめる手順をまとめます。

参照画像を5枚ともとりあえず入れると、何が起きるか
Grok Imagineの画像モデルは2026年8月7日にImagine Image 2.0へ更新され、1回の生成に最大5枚の入力画像を渡せるようになりました。
Web版とiOS、Androidアプリでは、Quality Modeとして使えます。
xAIの発表によると、Arenaのテキストから画像生成と画像編集の両部門で世界2位(8月7日時点)。
1位はOpenAIのgpt-image-2で、そのすぐ後ろにつけた位置です。
たとえば新作コーヒー豆の広告画像を作るつもりで、商品パッケージの写真、好きな水彩イラスト、カフェ店内の写真、雑誌の見開き、豆を持つ手のアップを5枚まとめて置き、こう頼んだとします。
この5枚を参考に、新作コーヒー豆の広告画像を作ってください。
おしゃれで温かい雰囲気にしてください。
この頼み方には、崩れる余地が少なくとも3か所あります。
- 水彩のにじみが、パッケージのロゴや文字にまで乗る
- 店内写真の電球色が、クラフト紙の色味を変えてしまう
- 雑誌の余白の取り方と、店内写真の奥行きのある構図がぶつかる
原因は写真の質ではありません。
1枚の写真には、被写体、色、タッチ、構図、光が全部入っています。
どの要素を借りるのかを書かなければ、選ぶのはモデルの側です。
5枚もあれば、「構図」という1つの役を2枚が取り合う状況も普通に起きます。
Grok Imagineの参照画像に役割を割り振ると、何が変わるか
先に断っておくと、「被写体」「スタイル」「レイアウト」といった役割の分類は、xAIが定めた仕様ではありません。
公式が示しているのは5枚という上限と、キャラクター、場所、小道具を別々に作ってスタイルを揃えたまま組み合わせる、という使い方の例までです。
ここから先は、画像を組み立てる側の実践的な割り振り方として読んでください。
役割は、1枚につき1つだけ持たせます。
さっきの5枚なら、店内写真と手のアップは外して3枚にします。
役を持たない写真は、残しておくほど他の3枚の邪魔をするからです。
5枚の枠を使い切らない判断も、割り振りのうちです。
プロンプトでは「1枚目」「2枚目」と番号で呼ぶより、写っている内容で呼ぶほうが確実です。
アップロードした順番をモデルがどう扱うかは、公式に説明がありません。
比率は画面側で16:9を選んでおきます。
クラフト紙のコーヒー豆パッケージの写真からは、袋の形、ロゴ、ラベルの文字だけを使う。
水彩画のイラストからは、にじみのある筆のタッチと淡い色づかいだけを借りる。
雑誌の見開きからは、左側に広い余白を取り、右下に主役を置く配置だけを借りる。
朝の窓辺、柔らかい自然光。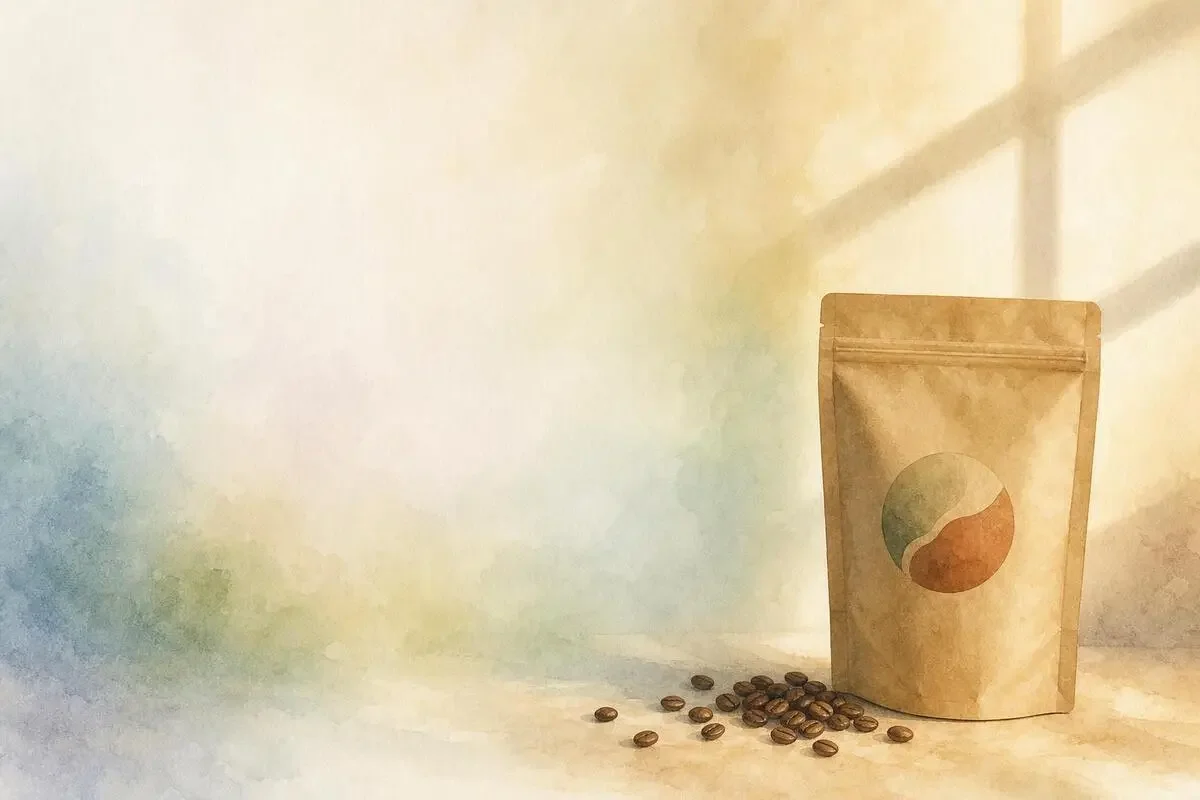
作例は仕上がりの方向を示すために別の画像生成AIで作ったイメージで、Grok Imagineの出力ではありません。
効いているのは、各行が「どの写真から、何を、どこまで借りるか」を1文で言い切っている点です。
「だけを借りる」と範囲を閉じておくと、水彩画に描かれていた花瓶やカップが紛れ込む余地が減ります。
参照画像を1枚だけ差し替えて、効き方を確かめる
役割を書いたからといって、その通りに効いているとは限りません。
確かめ方はシンプルで、プロンプトの他の行はそのままに、参照を1枚だけ入れ替えて見比べます。
スタイル参照を水彩画から切り絵のイラストに替えるなら、書き換えるのもその1行だけです。
切り絵のイラストからは、紙を重ねた段差と影、くっきりした色面だけを借りる。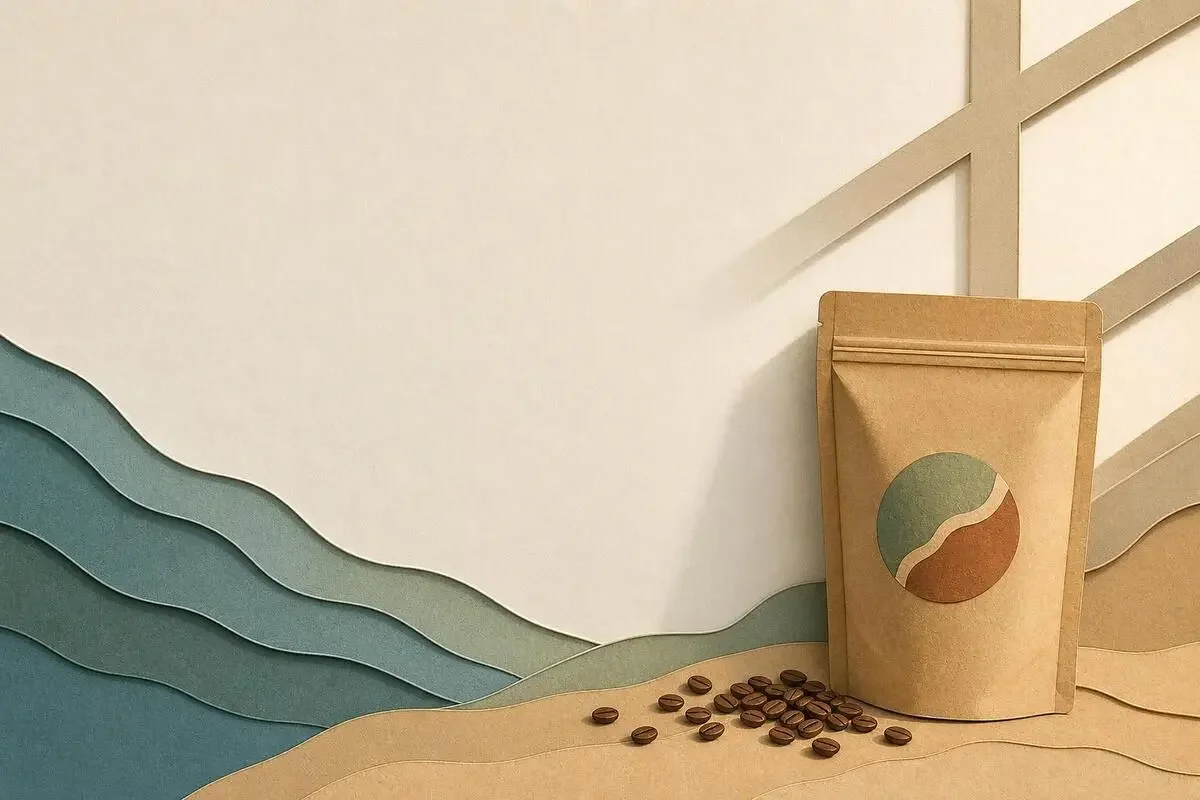
見比べるのは次の3点です。
- パッケージの形とロゴが、水彩版と同じか
- 左の余白と右下の配置が保たれているか
- 変わったのが、タッチと色面だけか
タッチだけが変わっていれば、3枚はそれぞれの役に収まっています。
もしパッケージの形まで変わったら、切り絵のイラストに描かれていた物が被写体として拾われた可能性が高いです。
物が写っていない部分だけを切り出して渡し直すと、スタイルとして読まれやすくなります。
レイアウト参照も同じ要領で、雑誌の見開きを、中央に主役を大きく置いた別の見開きに替えます。
今度は配置だけが動き、タッチと商品が水彩版のままなら合格です。
1回に替えるのは1枚だけ。2枚同時に替えると、どちらが効いたのか分からなくなります。
普段いちばん崩れやすいのは、形、タッチ、配置のどれでしょうか?
そこを担当する1枚から差し替えると、原因が早く絞れます。
Grok Imagineのマジックワンドは、組み上げた後に使う
役割を分けても、ラベルの小さな文字だけが崩れる、といった局所的なズレは残ります。
ここで参照を入れ替えたり全体を作り直したりすると、うまくいっていた部分まで動いてしまいます。
2.0で入ったマジックワンドは、指した範囲だけを編集して、残りには手を付けない機能です。
ラベルだけ、余白に入り込んだ小物だけ、と狙って直せます。
全体の方向は参照で決めて、細部はマジックワンドで詰める。
この分担にしておくと、うまくいった部分を守ったまま仕上げに進めます。
同時に入った背景除去は、参照の下ごしらえにも使えます。
商品写真から背景を抜いて透過で書き出しておけば、被写体の参照に部屋の照明や床の色が混ざりません。
役割を1つに絞る作業を、素材の段階で済ませておくわけです。
ChatGPT Images 2.5やNano Banana 2と比べて、参照画像5枚は少ないのか?
数字だけ並べると、Grok Imagineの5枚は控えめです。
ChatGPT Images 2.5の16枚はAPIの仕様で、ChatGPTの画面から一度に添付できる枚数とは別に考えてください。
ただ、枠が多いことと、狙いの絵に届くまでの手数が少ないことは別の話です。
枠が広いツールほど、1枚ごとに役割を決める作業もそのぶん増えます。
登場人物が4人いる絵本の見開きや、小物を10個並べる商品カタログのように、固定したい対象そのものが多い仕事なら、Nano Banana 2やAPI経由のgpt-image-2.5のほうが1回で渡しきれます。
逆に、商品1つを決まったタッチで決まった位置に置く広告なら、要る役は3つ程度です。
5枚の枠で足り、残るズレはマジックワンドで詰められます。
どちらが自分の仕事に合うかは、同じ条件で数えると見えてきます。
- 同じ3枚の参照と、同じ役割の文を3つのツールに渡す
- 狙いの絵に届くまでの生成回数を数える
- 届いた後の部分修正の回数も数える
この合計が、そのツールでの手数です。
あなたがよく作る画像は、固定したい物が3つで収まる仕事と、10個を超える仕事のどちらに近いでしょうか?
参照画像を渡す前に、何を決めておくか?
参照画像の枠は、埋めるものではなく割り振るものです。
アップロードする前に、1枚ごとに「この写真から何を借りて、何を借りないか」を1行ずつ書き出してみてください。
1行で書けない写真は、今回は外して構いません。
まずは被写体、スタイル、配置の3枚から始めて、崩れた要素が出たときだけ、その担当の1枚を差し替える。
5枚目を使うのは、それからで十分です。
- 2
- 0
元デザイナー → AI画像職人。絵心ゼロだったけどプロンプト極めたらなんとかなった。「センスじゃない、言語化だ」 使えるプロンプト&失敗例を晒していく
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 Mako
- 3
- 0
-
 三枝
- 4
- 0
-
 トロメ
- 4
- 0
-
 Brio
- 3
- 0
-
 にくたま
- 5
- 0
-
 Saki
- 2
- 0
-
 千賀
- 4
- 0
-
 しげ
- 4
- 0
-
 Nao
- 3
- 0
-
 Nina
- 4
- 0
-
 Nopecrumb
- 3
- 0
-
 棚島(たなしま)|フォロバ100
- 5
- 0
-
プロンプト画伯
- 4
- 0
-
コードを読まないAIエンジニア
- 3
- 0
-
 かなえ@脆弱性診断
- 2
- 0
-
棚島(たなしま)|フォロバ100
- 7
- 0
-
- 5
- 0
-
にくたま
- 6
- 1
-
 AI経営者の参謀@ひで
- 6
- 0
-
- 1
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます