P-JiT 21Kは、研究ラボのLinumが2026年11月4日に公開した画像生成モデルで、学習にかかったお金は2万1,038ドル(1ドル150円で約316万円)です。同じ英語のプロンプトをOpenAIの画像API「gpt-image-2」と3本並べたところ、写真風のマグカップと柴犬は破綻なく描けた一方、黒板の看板の文字は読めない線になりました。勝ち負けの分かれ目は、このモデルが学習のときに何を捨てたかにあります。
P-JiTの約316万円は、GPUを借りた代金
316万円の中身は、NVIDIAのH100というGPUを1時間2.50ドル(約375円)で8,415時間借りた代金です。主な学習は64枚を並べて回したので、ざっと割ると約131時間、5日半ほどの計算になります。公開したのは共同CEOのサヒル・チョプラさんとマヌ・チョプラさんで、公式ブログは次に作る動画モデルへの足がかりと位置づけています。
誤解しやすいのは「6.6億サンプルで学習」という数字です。これは画像6.6億枚という意味ではなく、学習中にモデルへ画像を見せた延べ回数です。1回に2,048枚ずつ、512ピクセル級で297,985回、1024ピクセル級で24,400回見せた合計なので、同じ画像を何度も見せている可能性があります。重複を除くと何枚なのか、画像をどこから集めたのかは公開されていません。
絵を描く本体は2.18B(約22億個のパラメータ)ですが、プロンプトの文章を読む係として、別のモデルQwen3.5-4Bを組み合わせます。ダウンロードするのは本体の8.7GBとQwen側の約8GBで、合わせて約17GBです。

では、有名なモデルと比べてどうなのか。公式ブログが比べている相手は自社の前のモデルLinum v2だけで、「11分の1のサンプル数で学習が収束した」という効率の話です。FLUXやSDXLのような有名モデルと点数で並べた結果は、公式には1つも出ていません。だから自分で並べました。
P-JiTとgpt-image-2を、同じプロンプトで3本勝負
P-JiTは、Hugging Face上の非公式デモ(Space。誰でもブラウザやAPIから呼べる公開デモ)をログインなしで呼び出しました。設定は正方形の1024×1024、seed(絵の出方を決める乱数の種)42、steps(描き込みの回数)50、guidance(プロンプトに従う強さ)15です。gpt-image-2は、OpenAIのAPIをquality=mediumで使いました。

このデモには、40語未満のプロンプトを自動で長く書き足す機能があります。両方にまったく同じ文を渡したかったので、オフにしました。1本目はマグカップの商品写真です。
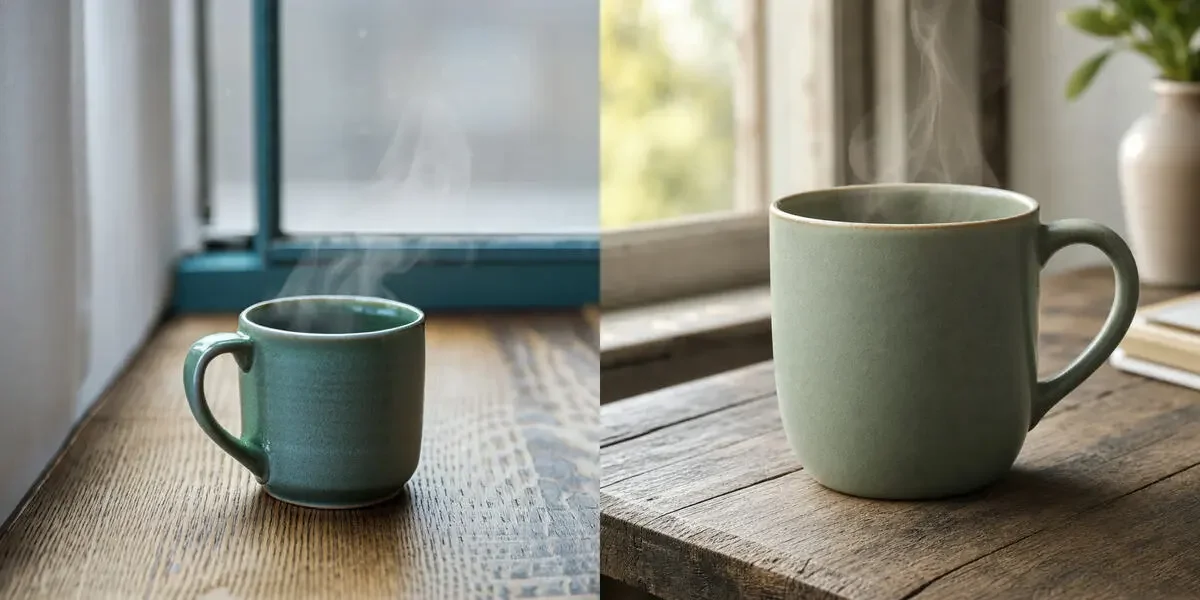
A ceramic coffee mug with a matte sage green glaze on a weathered oak table beside a window, soft morning light, steam rising, shallow depth of field, product photograph3本の結果を先に並べます。判定は私の目で見たものです。
時間は、P-JiTが無料のデモ、gpt-image-2が有料のAPIなので、同じ土俵の比較ではありません。
P-JiTのマグカップには、窓辺、古びた木の天板、立ちのぼる湯気、背景のぼけまで、頼んだ要素が全部入りました。約316万円で作った研究用のモデルと聞いて想像するより、ずっと商品写真らしい1枚です。差がついたのは色で、sage green(灰色がかった緑)と頼んだ釉薬が青緑に寄りました。gpt-image-2は色が指定に近く、天板の木目や奥の小物まで描き込まれていて、商品写真としてはこちらが上です。
普段、プロンプトは何語くらいで書いていますか? 今回の3本は22〜29語で、公式が勧める50〜80語の半分にも届きません。READMEには、短いプロンプトだと絵が目に見えて悪くなるとあります。この勝負は、P-JiTに不利な条件で戦わせています。
柴犬と神社では、gpt-image-2も漢字で崩れた
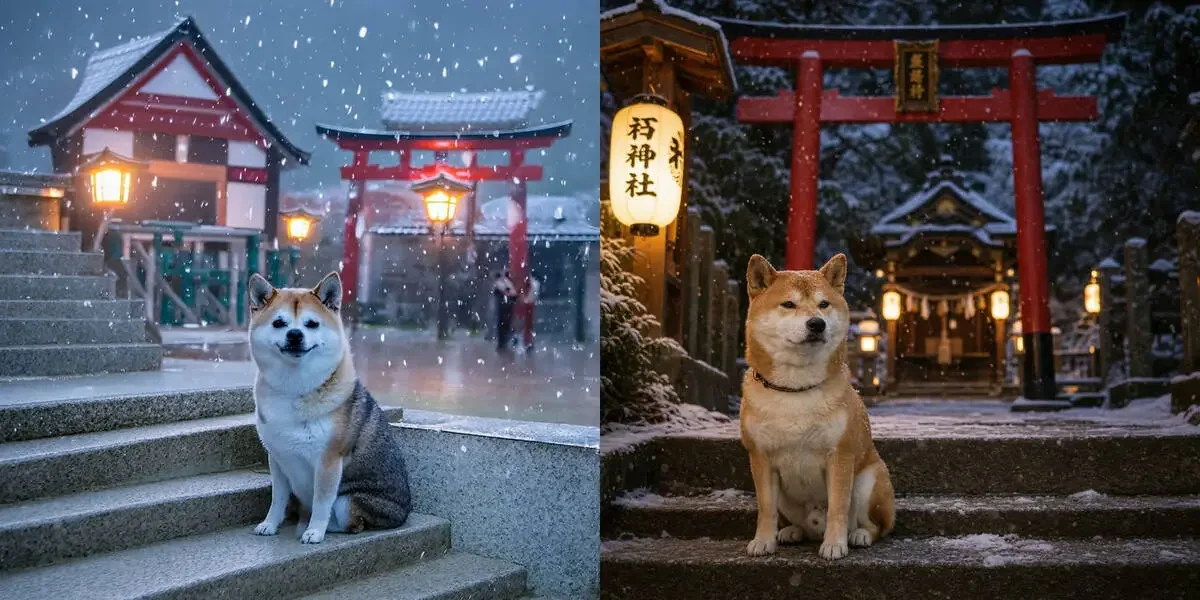
A shiba inu dog sitting on stone steps of a small Japanese shinto shrine in light snowfall, red torii gate behind, evening lanterns glowing, photographP-JiTは、雪、鳥居、灯籠、石段を全部そろえ、柴犬の顔も犬としてちゃんと成立していました。気になったのは毛色で、体の左右で灰色と茶色が混ざり、よく見る柴犬の色から外れています。頼んでいない人影が2人、背景に入ったのも減点です。
ここが面白いところで、gpt-image-2にも崩れがありました。柴犬の形と毛色は自然なのに、提灯と鳥居の額に漢字らしい文字を描き込み、そこに読めない字や意味の通らない字が混ざったんです。「神社」の前の字は形が崩れていました。
文字を書けるモデルは、頼んでいない場所にも文字を描きにいく。日本の風景なら提灯や額がその場所になる、というのが私の見立てです。文字の要らない絵では、どこを無地にしたいのかまでプロンプトで言葉にしておく価値があります。
黒板の看板で、P-JiTが文字を書けなかった理由
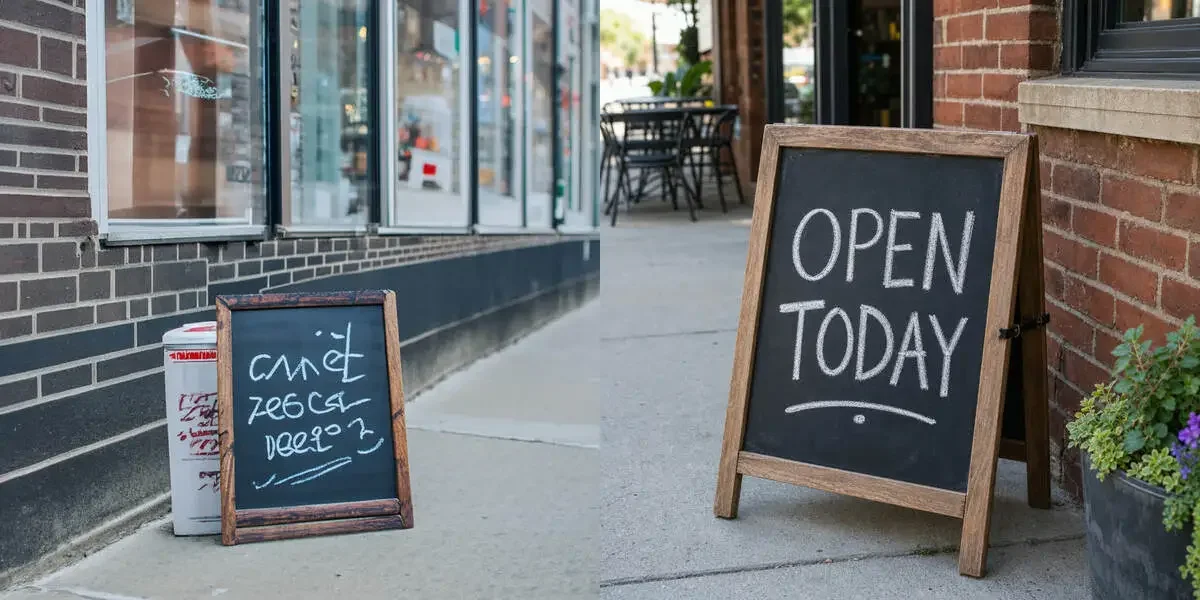
A small cafe chalkboard sign on a sidewalk with the words OPEN TODAY written in white chalk, brick wall behind, daylight photographP-JiTの黒板には「OPEN TODAY」が出ず、読めない筆記体のような線が並びました。看板、歩道、レンガの壁はきちんと描けているので、崩れたのは文字だけです。gpt-image-2は「OPEN TODAY」を正しく書きました。
これはP-JiTの不具合ではなく、設計どおりの結果です。Linumは学習データから、図表、PDF、本のページ、スライドのような文字が写った画像を意図的に外しました。目指しているのは動画やアニメーションの道具なので、文字の画像は役に立たないという判断です。
モデルの説明ページにも「このモデルは文字を書けず、ポスターも作れない」とはっきり書かれています。公式の手順には、短いプロンプトを長く書き直す仕組み(既定ではClaude Opus 5.5が担当)がありますが、これも文字を入れてほしいという依頼は text_requested というエラーで止めます。
公式が挙げる苦手はほかに、人物の全身、車6台や群衆のように数の多いもの、複数人が触れ合う場面、ギターの弦が6本といった世界の知識です。
P-JiTを手元で動かすなら、NVIDIAのGPUが要る
手元にNVIDIAのGPUはありますか? 公式のコードは、CUDA(NVIDIAのGPUを計算に使う仕組み)が前提です。READMEには「CUDAのGPUが必要。重みはfp32で8.7GB、文章を読むモデルはbf16で8GB、これに計算中のメモリが加わる」とあります。CUDAが使えないMacでは、公式の手順では動きません。必要なVRAM(GPUのメモリ)の数値は公式にありませんが、重みだけで約17GBあることは頭に入れておいてください。
GPUがなくても、無料で触る方法はあります。今回使ったHugging Face上のSpaceです。運営しているのはLinumではなく「hugging-apps」というアカウントで、公式ブログやREADMEからはリンクされていません。

このSpaceはZeroGPU(Hugging FaceがSpace向けに無料で貸すGPUの枠)で動いていて、回数に上限があります。ログインなしでは3枚作れて、4枚目は1秒で「ZeroGPUの実行回数の上限を超えた。Hugging Faceのトークンで認証すれば枠が増える」という意味のエラーで止まりました。もっと作りたいなら、Hugging Faceのアカウントでログインしてから使ってください。
P-JiTを触ってよい人、見送ってよい人
P-JiTは有名モデルとどこまで戦えるのか。文字の入らない写真風の静物や動物なら、破綻のない1枚は出せます。指定した色の再現や細部の作り込みはgpt-image-2が上で、文字は勝負になりません。3本を1回ずつ並べた範囲での答えです。
触ってよいのは、次のような人です。
- 文字の入らない写真風の絵を、無料のデモで試したい人
- 自分のGPUで回せて、商用で使えるライセンスの重みを探している人
- 数百万円で画像AIがどこまで作れるのか、学習の効率に興味がある人
ライセンスはApache 2.0で、重みもコードも商用で使えます。ただし、学習に使った画像の出どころは公開されていません。文章を読むQwen3.5-4Bは別のモデルなので、そちらのライセンスも確かめてください。公式自身も「実験的な研究用の成果物で、製品向けのモデルではない」と書いています。
見送ってよいのは、サムネイルやポスターに文字を入れたい人、人物の全身や大人数を描きたい人、Macだけで手元で動かしたい人です。当てはまるなら、gpt-image-2のような有名モデルを使うほうが早く終わります。
あなたが次に作りたい絵は、文字の要らない1枚ですか? そうなら、まず非公式のSpaceで、プロンプトを50〜80語に書き足してから1枚作ってみてください。主役の色と素材、光の向き、構図、背景の小物まで言葉にすると、それくらいの長さになります。センスじゃなくて言語化で引き出すモデルです。
- 4
- 0
元デザイナー → AI画像職人。絵心ゼロだったけどプロンプト極めたらなんとかなった。「センスじゃない、言語化だ」 使えるプロンプト&失敗例を晒していく
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 むみま
- 4
- 0
-
 モルル
- 4
- 0
-
 さくら
- 6
- 0
-
プロンプト画伯
- 7
- 0
-
AI脱社畜
- 7
- 0
-
 AI献立部@ひなた
- 6
- 0
-
 弾丸旅プラン@りの
- 6
- 0
-
さくら
- 6
- 0
-
さくら
- 3
- 0
-
- 4
- 0
-
 宮坂沙耶
- 4
- 0
-
 Mina
- 6
- 0
-
 商店街の貼り紙係@ゆう
- 4
- 0
-
 Saki
- 4
- 0
-
 棚島(たなしま)
- 8
- 0
-
- 4
- 0
-
- 5
- 0
-
さくら
- 3
- 0
-
- 2
- 0
-
 このは
- 4
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます