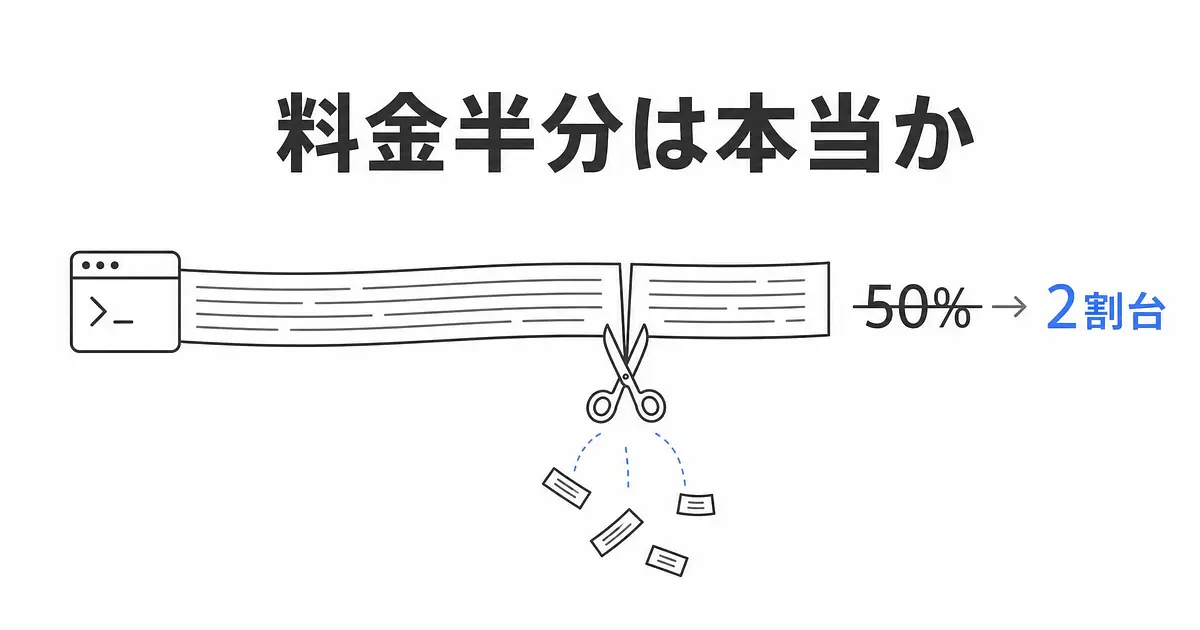
長時間のClaude Codeセッションで、請求額が思ったより膨らんでいたことはありませんか? 9月22日に論文が出たCliffCompactionは、「トークン代を最大50%減らせる」とうたうコンテキスト圧縮のプロキシです。ただ論文を読むと、この50%はClaude Codeの料金とは別の条件で出た数字でした。
「最大50%減」は、何と比べたCliffCompactionの数字か?
論文はCliffCompaction: Cost-Efficient Compaction for Long-Horizon Coding Agentsで、著者は4名。最後に名前があるのは、カーネギーメロン大学の助教で、量子化ライブラリのbitsandbytesやQLoRAで知られるティム・デットマーズさんです。
50%の比較相手は、圧縮を一切せず会話を全部送り続ける実行です。Terminal-Bench 2.0で、Kimi K2.6は25.0〜52.1%、GLM 5.1は35.8〜64.6%コストが減りました。幅があるのは、圧縮を始める閾値を32K、16K、8Kと変えているからです。SWE-bench Verifiedだと差は小さく、Kimi K2.6の32K設定で1タスク0.19ドルが0.18ドル、約5%減でした。
Claude Codeを使っている側から見ると、この条件は引っかかりませんか? 主な実験のモデルはKimiとGLMで、Claudeは測っていません。しかもClaude Codeにはもともと自動圧縮があるので、「圧縮しない」は比較相手として現実的ではない。
Claude Codeの上では、コスト削減は2割台
論文には、Claude Codeの中でCliffCompactionを動かした実験が1つだけあります。モデルはGLM 5.3 Flash、ベンチマークはTerminal-Bench 2.1です。1タスクあたりの費用を1ドル150円で換算しました。
既定の設定と比べると、費用は約24%下がり、成功率は3.66ポイント上がりました。一方、ピーク時のコンテキストを同じ約45KにそろえたClaude Codeの自動圧縮と比べると、CliffCompactionのほうが1タスク約3円高い。そのかわり成功率は5.72ポイント上です。
タイトルの問いに答えるなら、半分にはなりません。論文の条件で、既定比2割台です。Claude Codeの上で効いていたのは安さより、同じ予算で正答率を落とさないほうでした。
Claude Codeの要約圧縮とCliffCompactionの違いは、言い換えるかどうか
Claude Codeの/compactと自動圧縮は、会話履歴を構造化した要約に置き換えます。何を残すかはモデルが判断し、文章は書き直されます。途中で念押しした細かい指示が、圧縮のあとで丸められていたことはありませんか?
CliffCompactionは書き直しをしません。READMEによると、閾値を超えたら会話を次のように組み直します。
- システムプロンプトとタスク説明、直近3ターンは原文のまま
- ユーザーの発言、アシスタントの文章と思考も既定で残す
- ツール呼び出しは1行のシグネチャだけにする
- 500文字を超えるツール結果は捨てる
圧縮済みの内容をもう一度圧縮しないのも特徴です。毎回元の会話から作り直し、前回の圧縮結果は捨てる。要約の要約を重ねて、100万トークン級のセッションでズレが積み上がるのを避ける設計です。論文では、Terminus-2というエージェントのLLM要約をCliffCompactionに置き換えただけで、16K設定の成功率が55.45%から61.42%に上がっています。
キャッシュが割れると、Claude Codeのトークン代の削減は目減りする
Claudeのプロンプトキャッシュは、前回のリクエストと先頭から完全に一致する部分だけを安く読みます。読み取り単価は通常入力の10%、Claude Opus 5.5なら5%です。圧縮で会話を組み替えると、その位置より後ろのキャッシュは作り直しになります。
論文でも、GLM 5.1で閾値を無制限から8Kまで絞ると、キャッシュヒット率が79%から47%に落ちました。費用の計算はキャッシュ込みですが、キャッシュがここまで安いClaudeでは、送るトークンを減らした節約を作り直しが食う場面が増えると私は見ています。閾値は小さいほど得、とは限りません。
CliffCompactionをClaude Codeに挟む手順
必要なのはPython 3.11以上で、ライセンスはMITです。何も書き換えない観察モードから始めるのが安全です。
uv tool install cliffcompaction   # または pip install cliffcompaction

# 観察だけ。何を圧縮するかをログに出し、リクエストは変えない
cliff run --shadow -- claude

# 実際に圧縮させる。閾値は環境変数で下げられる
CLIFF_THRESHOLD_TOKENS=45000 cliff run -- claude
cliff runはその場だけプロキシを挟むコマンドです。常用するならcliff enableで常駐サービスを入れ、シェルの設定にベースURLの環境変数も書き込ませます。外すときはcliff disableです。
Claude Code側では、設定のautoCompactEnabledをfalseにして自動圧縮を切っておきます。エージェント自身の圧縮が履歴を書き換えると、CliffCompactionが頼る先頭一致の照合が壊れる、とREADMEにあるためです。閾値の既定は200,000トークンなので、論文でClaude Code上の結果が出た約45Kに合わせて下げています。
見落としやすいのがANTHROPIC_BASE_URLの副作用です。公式ドキュメントによると、Anthropic以外のホストを向けたClaude Codeは、MCPのツール検索を既定で切り、Remote Controlも使えなくなります。MCPサーバーを多くつないでいるなら、ツール定義が最初から載ってかえってトークンが増えないか確かめてください。
なお、Pro・Maxの定額プランでは請求額そのものは変わりません。READMEにはサブスクリプションのログインで動くかの記載もないので、料金の話はAPIキーの従量課金が前提です。
Claude Codeのコスト削減は、自分のタスクで比べる
論文の数字はGLMとKimiのものなので、自分のClaudeでどうなるかは測るしかありません。同じタスクを2回流して並べます。
- テストがあり、閾値を何度かまたぐくらい長いタスクを選ぶ
git worktreeなどで、同じコミットから作業ディレクトリを2つ作る- 片方は素のClaude Code、もう片方はCliffCompaction経由で同じプロンプトを渡す
- 終わったら
/usageを開き、SessionブロックのTotal costとPrompt cache (main)を控える - 両方でテストを流し、通った数を比べる
Total costは定価からの概算なので、正確な請求はClaude Consoleで確認します。Prompt cache (main)にはキャッシュから読めた入力の割合が出るので、前の章のキャッシュ割れがどれだけ起きたかも見えます(v2.1.251以降)。
費用が下がってもテストが落ちたら意味がないので、比べるのは費用とテスト結果の2つ組です。
CliffCompactionを試す価値は、料金より長いセッションの安定にある
半額を期待して入れると、肩透かしになる可能性が高いです。Claude Code上の根拠はGLM 5.3 Flashでの1実験だけで、リポジトリのスターも9月26日時点で41とまだ若い。論文自身も、効果はエージェントとタスク次第で、中〜長時間のタスクでしか意味がないと書いています。
それでも私が気になっているのは、言い換えない設計で、要約が指示を丸める問題を避けようとしている点です。仕様とテストを先に渡して長時間任せる使い方をしている人ほど、圧縮のあとにAIが前提を取り違える痛みを知っているはずです。
普段のセッションで、圧縮を何回またいでいますか? 1回もまたがないなら、このツールの出番はありません。何度もまたいでいるなら、cliff run --shadow -- claudeで1日回して、何が捨てられる予定なのかをログで眺めるところからで十分です。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 1
- 0
-
 Mako
- 3
- 0
-
 三枝
- 4
- 0
-
 Tonbo
- 4
- 0
-
 かやの
- 5
- 0
-
 Brio
- 3
- 0
-
 にくたま
- 5
- 0
-
 みどり
- 6
- 0
-
 ケケス
- 3
- 0
-
 しげ
- 4
- 0
-
 トトキ
- 5
- 0
-
 Nina
- 4
- 0
-
 Nopecrumb
- 3
- 0
-
 にふだ
- 3
- 0
-
 フルイ
- 3
- 0
-
 dimlight
- 5
- 0
-
 棚島(たなしま)|フォロバ100
- 5
- 0
-
 ゆい@海外AI副業ラボ
- 6
- 0
-
- 1
- 0
-
 gen
- 1
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます