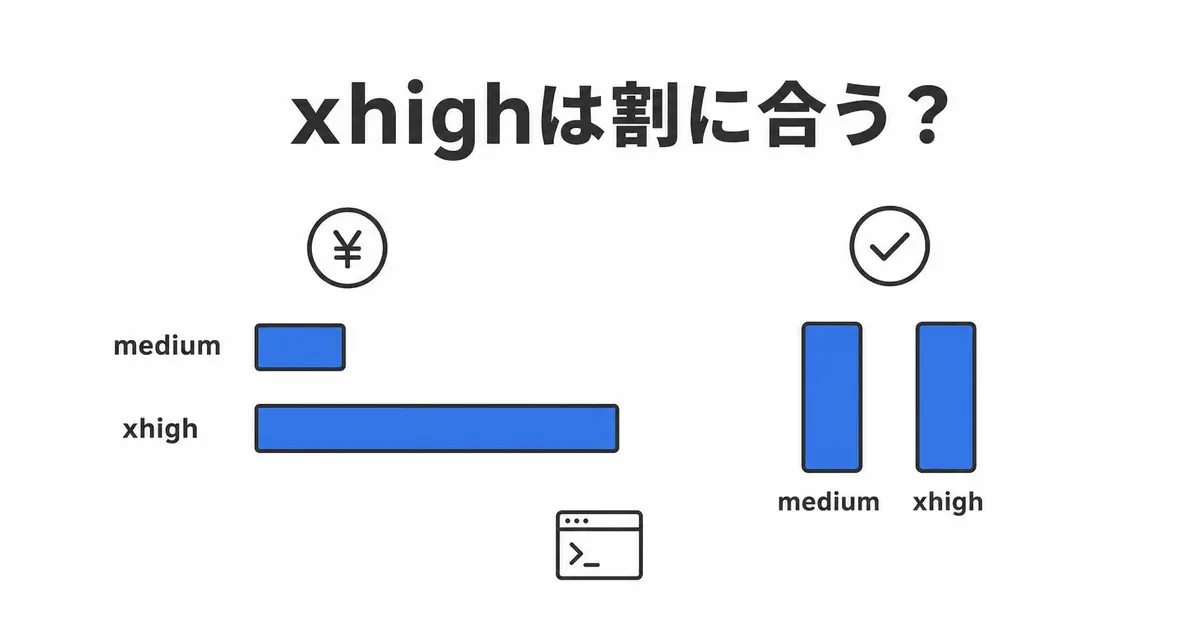
Claude Codeのeffort、重いタスクだからとxhighに上げていませんか? HumanLayerが2026年10月15日に公開したSlopCodeBenchの測定結果では、同じモデルをmediumとxhighで比べた3組のうち、厳密通過が増えたのはGPT-6 Astraだけでした。Opus 5.5はxhighにするとコストが4.22倍になり、通過は28件から25件へ微減しています。
表を円に直すとeffortの目安は見えてきますが、「xhighは悪い」と言い切れるほど単純ではありません。
SlopCodeBench 10月版、xhighで伸びたのは3組中1組
SlopCodeBenchは、1つの問題に途中で要件が何度も追加され、そのたびにAIが書いたコードを直していくベンチマークです。ベンチ自体はv1.0の36問・196チェックポイントのままで、10月版はHumanLayerが最新モデルを測った報告です。
採点は2系統あります。前の要件のテスト(回帰テスト)まで含めて全部通れば「厳密通過」、そのチェックポイントの中心機能のテストが全部通れば「コア通過」です。
mediumとxhighの両方を走らせたのは3モデルです。円は1ドル=150円で計算しています。
Astraは3件増えましたが、足したコストは約7万4,600円、厳密通過1件の上乗せに約2万4,900円です。このベンチを見る限り、「上げれば通過が増える」は当てにできません。
1件の厳密通過にいくらかかるか、effort別に円で並べる
10の設定すべてを、推定コストを厳密通過の件数で割った値で並べ直しました。
mediumの4設定は1件あたり約920〜1,350円、xhighの6設定は約2,280〜8,940円です。effortの段で、きれいに2つに分かれました。
一方で厳密率は12.24〜16.33%に収まり、推定コストは最安と最高で約8.7倍開いているのに、差は約4ポイントです。Fable 5.1、GLM 5.3、GPT-5.6 SOLはxhighだけ、GPT-6.1 SOLはmediumだけなので、反対側の成績は分かりません。
196中3件の差で、xhighは悪いと言えるか?
Opus 5.5の28件と25件の差は、196中3件、約1.5ポイントです。各設定は1回ずつしか走らせておらず、ぶれ幅は公開されていません。
元記事のタイトルには「xhigh considered harmful」とありますが、本文はもっと慎重です。
This doesn't prove that more reasoning hurts coding. It says higher effort was not a reliable way to buy more strict passes in these runs.
推論を増やすと悪くなる証明ではなく、今回はeffortを上げても厳密通過を確実には増やせなかった、という書き方です。タイトルへの答えも「上げても伸びなかった、Opus 5.5とSOLはむしろ微減」までです。
元記事は、コードの汚れでは逆の結果も出しています。slopと判定された行の割合が、Opus 5.5のxhighは77.75%、mediumは94.25%で、xhighのほうがきれいでした。28問に絞った比較で、判定の物差しはまだ粗いと著者自身が断っています。
元記事はどのエージェントで動かしたかを書いていないので、手元のClaude Codeでの成績と同じとは限りません。
コア率で見ると、Opus 5.5 Mediumが全設定で最高
厳密通過で並べると、Opus 5.5はmediumで5番手(GPT-5.6 SOL XHighと同数)、xhighで9番手です。ところがコア率では、Opus 5.5 Mediumが73.98%で10設定の最高です。xhighでも71.94%で、上から3番目です。
中心機能は高い割合で正しく作れるけれど、前の要件のテストをどこかで落とす。Opus 5.5の成績はそう読めます。
GPT-6 SOLは逆向きで、xhighで厳密通過が4件減った一方、最後のチェックポイントで落ちたテストケースの合計は2,831件から1,651件に減りました。数え方次第で、評価がひっくり返ります。
36問の最後のチェックポイントまで厳密通過できたのは、どの設定でも0〜3問でした。Opus 5.5 Mediumは0問です。要件が積み上がった先で前の機能を全部守り切るのは、どのモデルでもまだ難しい。私はこれが10月版でいちばん重い結果だと考えています。
あなたのタスクで怖いのは、新機能が動かないことですか、既存の機能が壊れることですか? 後者なら厳密通過、前者ならコア率のほうが判断に近い数字です。
Claude Codeのeffort設定、Opus 5.5で効かない書き方がある
Opus 5.5の既定のeffortはmediumです。公式ドキュメントでは、mediumは範囲のはっきりした日常の開発作業、highは検証が大事な作業やエッジケースが出そうな作業、xhighはより深い推論でトークン消費も増える、という使い分けです。上げるほど検証が増えるとは書いてありますが、成績が上がるとまでは書いていないんですよね。
指定の強さは、環境変数 CLAUDE_CODE_EFFORT_LEVEL、起動時の claude --effort xhigh、セッション中の /effort といった明示の指定が一番で、次に設定ファイルの値、何もなければモデルの既定値です。
ハマりやすいのが、ユーザー設定 ~/.claude/settings.json のトップレベルに書いた effortLevel です。これはOpus 5、Fable 5.1とそれ以前のモデル向けの古い書き方で、Opus 5.5には効かず、既定のmediumのまま動きます。モデルごとに決めたいときは modelSettings に書きます。
{
  "modelSettings": {
    "claude-opus-5-5": {
      "effortLevel": "high"
    }
  }
}
手元の対話セッションで /effort high を実行すると、この形で保存されます。プロジェクト用・ローカル用・管理者用の設定ファイルなら、トップレベルの effortLevel もOpus 5.5に効きます。
xhighに上げる前に、自分のタスクで確かめること
effortより先に、次の3つを見ておきます。
- 回帰テストがあるか。なければ、xhighにして良くなったのかを判定できません。
- 1回の失敗がいくらの損か。手戻りが、Astraが厳密通過1件の上乗せに払った約2万4,900円より安く済むなら、mediumで回して落ちたテストを直させるほうが割安です。
- 同じタスクでmediumとxhighを比べたか。同じissueを
claude --effort mediumとclaude --effort xhighで1回ずつ解かせ、通ったテストの数と使ったトークンを並べます。偶然の差が混ざるので、2〜3件で見ます。
Opus 5.5なら、既定のmediumのまま回し、回帰テストで落ちた箇所の修正だけhighに上げる組み方から始めるのが手堅いと私は考えています。xhighは、自分のテストで効果を確かめられたタスクにだけ使えば十分です。
- 2
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
コードを読まないAIエンジニア
- 4
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
 コバ
- 3
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 4
- 0
-
 倉持一成
- 6
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます