
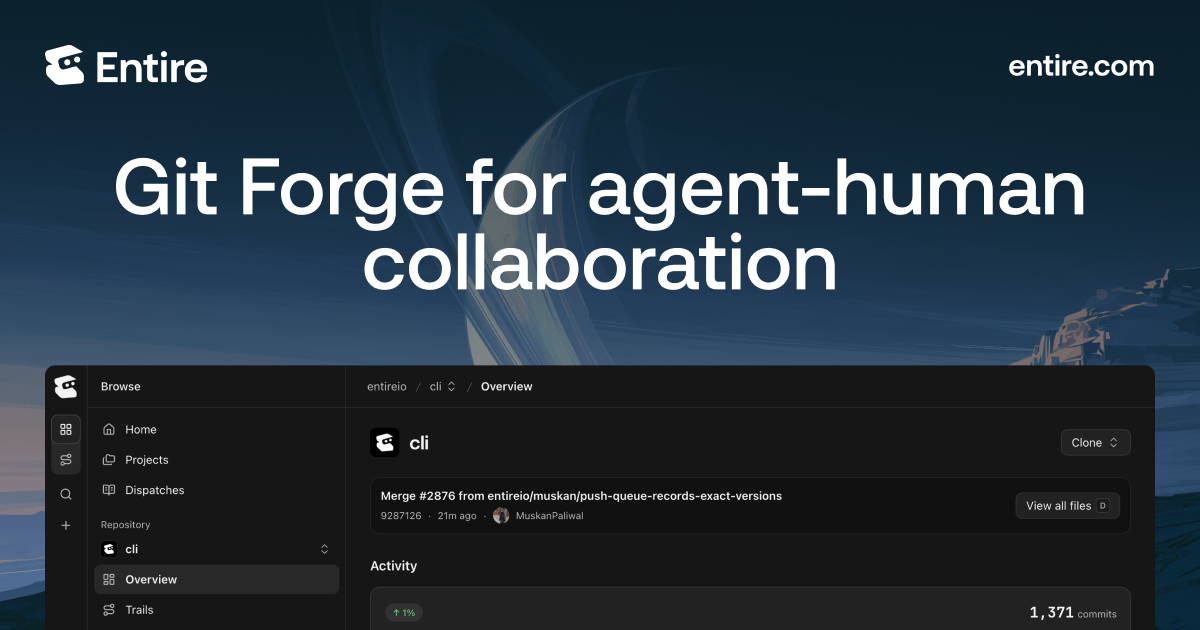
Entireは、元GitHub CEOのトーマス・ドムケさんが立ち上げた、AIエージェントと人が一緒に使う前提のGit forge(コードを置き、レビューし、マージする場所。GitHubの仲間)で、2026年10月26日に誰でも使えるようになりました。
大きなリポジトリでエージェントを走らせると、同じファイルを何度も開き直してトークンを食っている場面、見かけませんか?この記事では、Entireの全体像と、GitHubのまま持ってこられるOSSのentire-graphを公開のRailsアプリに入れたら何が起きたかを、入れ方とあわせてまとめます。
Entireは何をするGit forgeなのか?
公式ブログが挙げる柱は3つです。
速さの数字も出ていて、pushはGitHubの最大89倍速いとしています。ただしEntire自身の測定で、比べているのは1秒あたりのpush数です。
僕が一番気になったのはContinuous Memoryでした。部品は2つあり、コードの地図を作るentire-graphと、過去のセッションを索引するentire-brainで、どちらもOSSとして手元で動きます。CIがコードを統合し、CDが出荷するなら、エージェントの理解を次へ運ぶのがContinuous Memoryだ、という立て付けなんですよね。
日本語で「Entire」を検索すると、2026年2〜3月の「Entire CLI」の記事がたくさん出てきます。あれはエージェントとのやり取りをコミットと一緒に記録するCLI(Checkpoints)の話で、今回のforgeはその上に、コードの置き場とレビューの場を足したものです。会社は2026年2月に6,000万ドル(約90億円。この記事では1ドル=150円で計算します)のシード資金を集めたとTechCrunchが報じています。
Entireのうち、GitHubのまま使える部分
新しいforgeに乗り換えるのは無理でも、OSSの部分だけ持ってこられるなら話は別です。Entireを部品ごとに分けると、GitHubとの距離はかなり違います。
ミラーは、GitHub Appを許可してリポジトリと地域を選ぶ方式です。Entire CLIのREADMEによると、pushはGitHubへ転送され、GitHubの権限、branch protection、必須チェックはそのまま効きます。早期アクセス中はホスティングもTrailsも無料で、お金がかかるのはEntireのエージェントが使ったトークンの分だけです(料金ページ、10月31日時点)。
それでも、ログインもGitHub Appの許可もなしに今日入れられるのは、表の下の2行だけです。entire-graphはEntire CLIのプラグインで、ライセンスはMIT。解析中はネットワークにもモデルにもつながらず、APIキーもテレメトリもありません。
entire-graphを手元のリポジトリに入れる
entire-graphは、tree-sitter(コードを構文として読む解析器)でリポジトリを読み、関数やクラスとその呼び出し関係を地図にしておく道具です。エージェントはgrepとファイルの読み込みを往復する代わりに、entire graph query に自然文を投げ、関係しそうなコードを順位つきで受け取ります。
公開のRailsアプリmaybe-finance/maybe(Rubyファイル794個、約4.5万行)を使い捨てのコンテナに置き、Entireのアカウントは作らずに入れました。打ったのはこれだけです。
# Entire CLI本体(~/.local/bin に入るので PATH に足す)
curl -fsSL https://entire.com/install.sh | bash
# entire-graphプラグイン
entire plugin install graph
# リポジトリのルートで
entire graph setup --repo .
entire graph index
インストールが4秒、プラグインが5秒、setupは1秒未満、索引づくりが2秒でした。合計十数秒で、ログインを求められる場面は一度もありません。入ったのはEntire CLI 0.12.2とentire-graph v0.6.0です。
setupが書き換えるのはCLAUDE.mdとフック
Claude Codeとのつなぎ方は、MCPサーバーではありません。READMEにも「MCPサーバーは持たない」とあり、実際にMCPの設定は追加されませんでした。代わりに、CLAUDE.md の末尾に空行を含めて5行が足されます。
<!-- entire-agent:begin -->
Read .entire/agent-guide.md for this repository's workflow, source inspection, and verification guidance.
@.entire/agent-guide.md
<!-- entire-agent:end -->
読み込ませている .entire/agent-guide.md は63行の手引きで、AGENTS.md にも同じ案内が4行入ります。もう1つ、.claude/settings.local.json にClaude Codeのフックが書き込まれました。
{
  "hooks": {
    "SubagentStart": [
      {
        "hooks": [
          {
            "command": "entire graph hook claude-subagent-start 2>/dev/null || true",
            "timeout": 10,
            "type": "command"
          }
        ],
        "matcher": "*"
      }
    ]
  }
}このフックには理由があります。docs/agents.mdによると、Claude Codeに組み込みのExploreとPlanのサブエージェントは CLAUDE.md を読みません。そこでサブエージェントが立ち上がるたびに、1KiB未満の短い指示を差し込んでいます。調べ物をExploreに任せている人ほど、ここが効いてくるはずです。
entire graph queryとgrepで出力を比べた結果
同じ3つの質問を、entire graph query と、話題の語で絞った grep -rniE(app/ と lib/ の .rb)に投げました。queryには英語の文で質問しています。
PlaidItem.perform_sync。4位に起動元の Sync.performBalanceSheet.net_worthImport.parsed_csv。5位に Import.csv_valid?3問とも、1位にその質問の中心になるメソッドが来ました。質問1のgrepは「plaid」と「sync」が並ぶ行を拾うだけで、同期を起動する側までは届きません。queryは4位に Sync.perform を出し、そのコード片には syncable.perform_sync(self) を呼ぶ行まで載っていました。grepのあとに打つはずだった1手を、先に済ませてくれる感覚です。
一方で、出力が短くなる道具だと思って入れると肩すかしを食います。queryは毎回JSONでほぼ1万字を返し、質問1と2ではgrepの方がずっと短い。queryの方が短かったのは、「csv|import」のように語が広すぎてgrepが344行を吐いた質問3だけでした。
あなたのリポジトリでgrepを打つとき、語を一発で絞れていますか?grepは語の選び方しだいで1千字にも2.9万字にもなりますが、queryは質問の語に左右されにくく、量がほぼ一定です。1件ずつコード片が付くので、ファイルを開き直す回数は減るだろうと見ています。1回のqueryは約1.3秒でした。
Entireの「最大71%削減」はどこまで信じていいのか?
公式ブログはentire-graphについて「in our testing saved up to 71% on tokens」、READMEは「depending on the coding scenario」と書いています。10月31日時点で、どのモデルで、どのリポジトリの、どんな作業を、何と比べたのかは、どちらにも書かれていません。
READMEには、ほかに2つの数字があります。1つはBenchmarksの表にある94.74という値で、これはLoCoMo(長い会話の中から根拠を探す、記憶系のベンチマーク)での検索精度です。コード調査のトークン削減を測ったものではありません。
もう1つは、むしろ71%と逆向きの話です。最初のプロンプトに検索結果を差し込むフックを既定でオフにしている理由として、READMEは対にしたエージェント実行の結果を載せています。graph searchをツール呼び出しにすると1ターン分を食ってトークンが増え、同じ答えをプロンプトに差し込んだ場合はトークン差が+0.7%(95%信頼区間で約±11%)でほぼ変わらなかった、というものです。どちらの差も統計的に有意ではないと、README自身が書いています。
CLIのヘルプも率直で、entire graph stats の説明には「not measured savings」とあります。削減量は実測ではなく、モデル上の見積もりだという断り書きです。
僕が比べたのは、コマンドが返す文字数です。エージェントが調査全体で使うトークンは、queryを何回打ち、そのあと何回ファイルを開くかで決まるので、上の表から71%が本当かどうかは言えません。71%は条件の書かれていない最大値として受け取り、自分のリポジトリでの使われ方で判断するのが妥当だと見ています。
entire-graphを入れる前に決めておくこと
効きそうなのは、grepの語を絞りにくいリポジトリです。「import」のように、あちこちで使われる語で調べ物をすることが多いなら、量の一定したqueryの方が扱いやすいはずです。反対に、公式も認めるとおり静的解析はヒューリスティックで、リフレクションや動的ディスパッチ、実行時に配線されるコードは取りこぼします。Railsなら send や method_missing、コールバックでつながる処理がこれに当たりそうです。あなたのリポジトリで、エージェントが迷うのはどちらの場面でしょうか?
入れるときに気をつけたい点は4つです。
.claude/settings.local.jsonは個人用なので、自分で.gitignoreに足す。setupの出力も「keep it untracked」と言っています- チームで使うなら、
.entire/agent-guide.md、AGENTS.md、CLAUDE.mdの3つを見直してからまとめてコミットする(READMEの案内) impact(変更したときの影響範囲を出すコマンド)は、entire graph impact "PlaidItem.perform_sync"と打つと unexpected argument で止まりました。READMEの例はentire graph impact --symbol Router.Matchの形です- 最初のプロンプトに検索結果を差し込むフックは既定でオフで、
ENTIRE_GRAPH_PROMPT_CONTEXT=1で有効になる。READMEの測定で、ツール呼び出しよりトークンが増えにくかった側です
最初の一歩は、作業用のブランチでsetupまで済ませ、いつもどおりエージェントに仕事を頼むことです。しばらくして entire graph stats を打てば、手元のエージェントの記録から、graphとgrep、ファイル読み込みがどう使われたかが出てきます。
Entireに乗り換えるかどうかは、Trailsのレビューを使いたいかで決めればいい話なんですよね。entire-graphはそれと切り離して、今のGitHubのまま十数秒で入ります。
- 5
- 0
物流会社の社内システム部で、15年続くRailsアプリを保守しています。古くて大きなリポジトリでAIエージェントをどう働かせるかを、手元で試しては書き留めています。休日は渓流釣りです。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 むみま
- 2
- 0
-
 bokuwalily
- 2
- 0
-
 AIの見張り番しおり
- 5
- 0
-
bokuwalily
- 2
- 0
-
 梢
- 4
- 0
-
むみま
- 3
- 0
-
むみま
- 4
- 0
-
むみま
- 9
- 0
-
bokuwalily
- 1
- 0
-
 えかさ@データサイエンス解析
- 3
- 0
-
bokuwalily
- 2
- 0
-
コードを読まないAIエンジニア
- 6
- 0
-
 しの
- 3
- 0
-
むみま
- 0
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
むみま
- 3
- 0
-
むみま
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます