
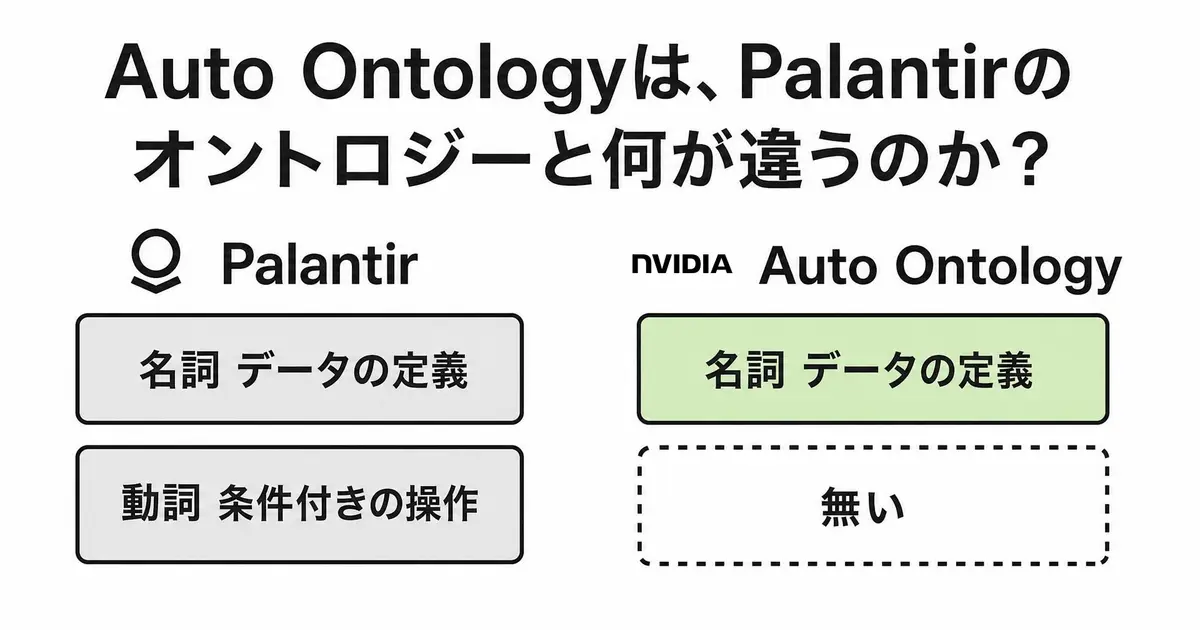
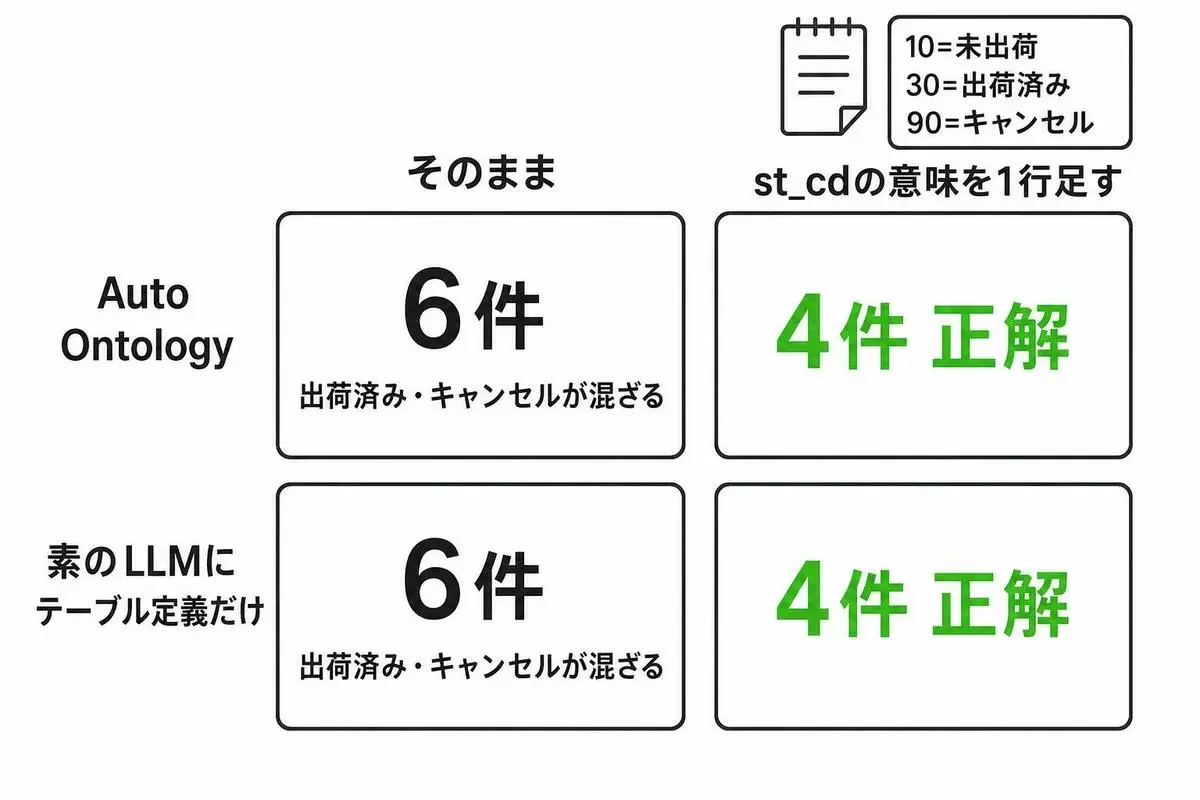
NVIDIAのAuto Ontologyは、業務DBのテーブルや列が何を意味し、どうつながるかを自動で書き出して、AIエージェントのtext-to-SQLに渡すOSSです。外部キーもコメントも無い略号だらけの8テーブルで動かすと、未出荷の注文の答えは正解4件のところ6件で、人が説明を1行足すと正解の4件になりました。同じLLMにテーブル定義だけを渡しても結果は同じで、答えを正しくしたのは、どちらもその1行でした。では、Palantirの製品と同じ「オントロジー」を名乗るこの道具は、何を作り、何を作らないのでしょうか?
Auto Ontologyは、AIエージェントのためにDBの意味を書き出すOSS
列の意味とテーブル同士のつながりを、AIが読める形で自動で書き出し、DBの横に置く道具です。ここでのオントロジーは、テーブルや列が業務で何を指すかの定義の集まりで、近いものをセマンティックレイヤー(データの意味を定義しておく層)と呼ぶ製品もあります。
作った定義はMCPサーバー、CLI、REST APIでほかのエージェントに渡せるほか、自前の質問用APIで質問からSQLを作り、業務DBで実行もします。対応DBはDatabricks、Postgres、Snowflake、DuckDBで、ライセンスはApache-2.0です。LLMの既定はNIM(NVIDIAがモデルをAPIで提供する仕組み)で動くNVIDIAのモデルNemotronで、OpenAI互換のエンドポイントにも差し替えられます。
NVIDIAは公式ページでこれを「出発点のオントロジー」と呼び、業務を知る人が手直しして認定(人が確かめた定義だと印を付けること)してから使う前提にしています。
前回の記事で扱ったPalantir(業務データの基盤を売る米国の会社)のオントロジーには、「注文」「在庫」のようなデータの定義(名詞)と、「出荷元を振り替える。ただし未出荷で在庫が足りるときだけ」のような条件付きの操作の定義(動詞)があります。仕入先の供給停止への対応をAIに聞くと、操作の定義まで渡した条件では、システムに無い操作を提案しなくなりました(各条件1回の実測)。今回は、Auto Ontologyが自動で作るのが名詞と動詞のどちらなのかを、同じデータで確かめます。

試した題材は、外部キーもコメントもない8テーブル
題材は、前回も使った架空のEC企業「ノース工房」の8テーブルです。注文、在庫、製品、部材構成表、部材、仕入先、顧客、倉庫で、主キーだけを付け、外部キー制約も列やテーブルのコメントも付けていません。列名は ord_no、st_cd、qty_rsv のような略号です。
質問は、仕入先S2の供給停止で影響を受ける未出荷の注文で、正解は4件です。同じ部材を使う出荷済みとキャンセルの注文を外せるかが分かれ目です。
NVIDIAのAPIキーを使わないため、LLMはMac(M1 Max、メモリ64GB)のOllamaで動くgemma4:12bに、埋め込みモデルはqwen3-embedding:4bに差し替えました。Web画面は使わず、生成と質問用APIだけを、業務DBとオントロジー用のPostgresと一緒に使い捨てのコンテナで動かしています。
略号だらけの8テーブルから、オントロジーは何が自動で作られたか?
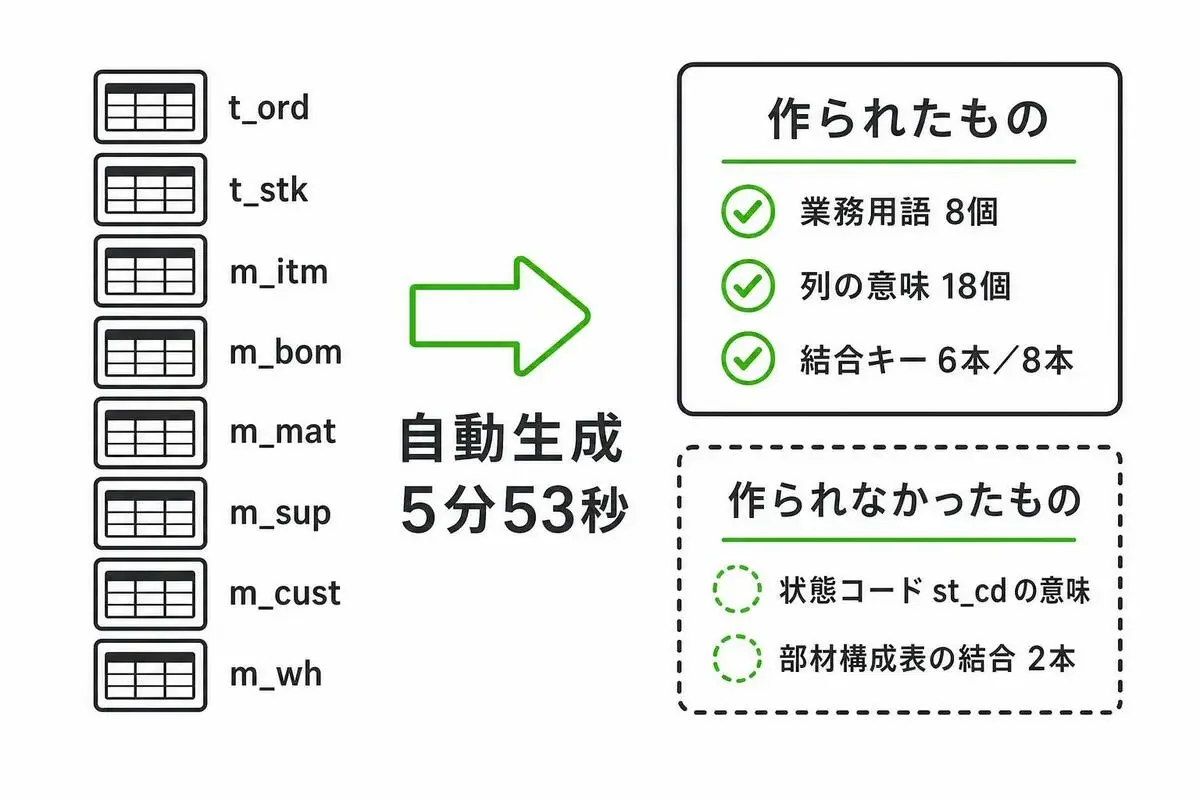
オントロジーの生成は5分53秒で終わりました。
業務用語8個と、列の意味18個が英語で付いた
業務用語は、テーブルが表す業務上のもの(エンティティ)の名前で、1テーブルに1つずつ、OrderやStock Level、Bill Of Materialsなど8個が付きました。用語の説明欄は空でした。
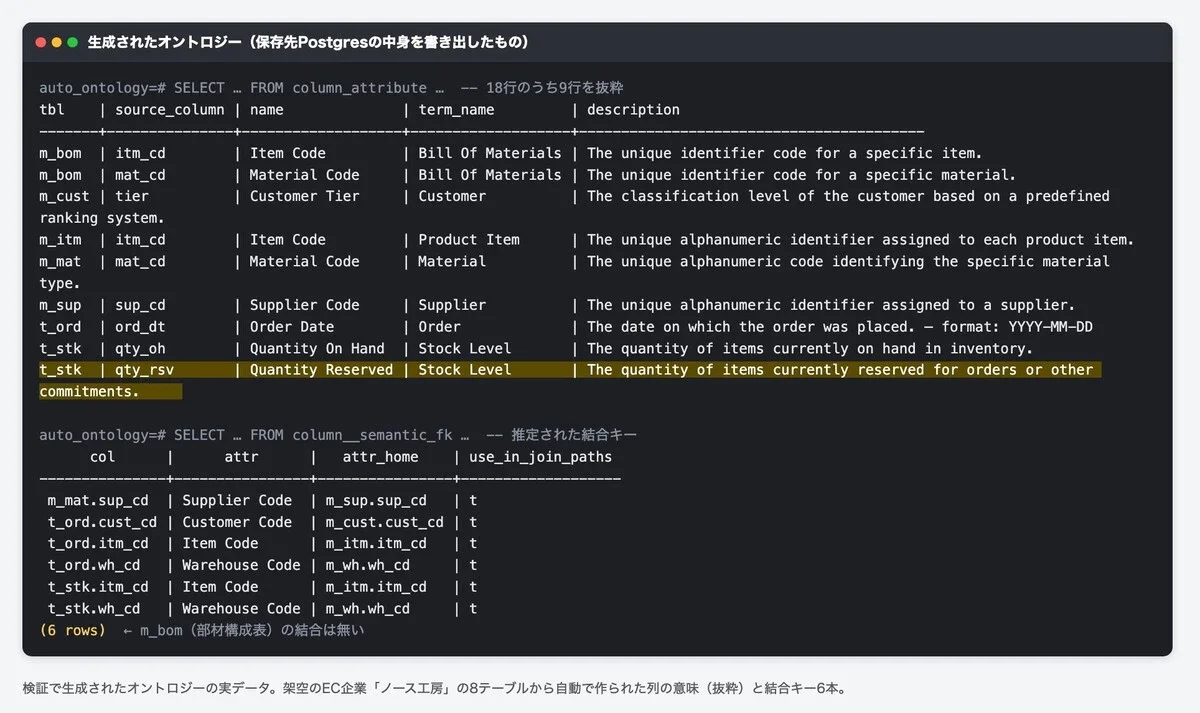
列は25列のうち18列に、英語の名前と説明が付いています。qty_rsv は「Quantity Reserved」で、注文などのために確保されている数量という説明でした。在庫の引当数を略号だけから言い当てていて、素直に感心しました。
結合キーは8本中6本、部材構成表の2本が欠けた
外部キー制約が無いので、テーブル同士のつながりは推定です。部材から仕入先、注文から顧客・製品・倉庫、在庫から製品・倉庫の6本は、すべて正しいものでした。
欠けたのは部材構成表 m_bom から製品と部材への2本です。m_bom の製品コードと部材コードの列には意味は付いたものの、製品表や部材表の同じ列とは結ばれませんでした。
状態コードの意味は空のままだった
注文の状態 st_cd には、名前も説明も付きませんでした。Auto Ontologyは列の実際の値もサンプルとして集め、説明を作るLLMへの手がかりにしています。10、30、90という値も集められていたのに、なぜでしょうか? 10が受注済みで90がキャンセルという取り決めは、データのどこにも書かれていないからです。
text-to-SQLの答えが6件から4件へ、人が足した1行
出荷済みとキャンセルが混ざった理由
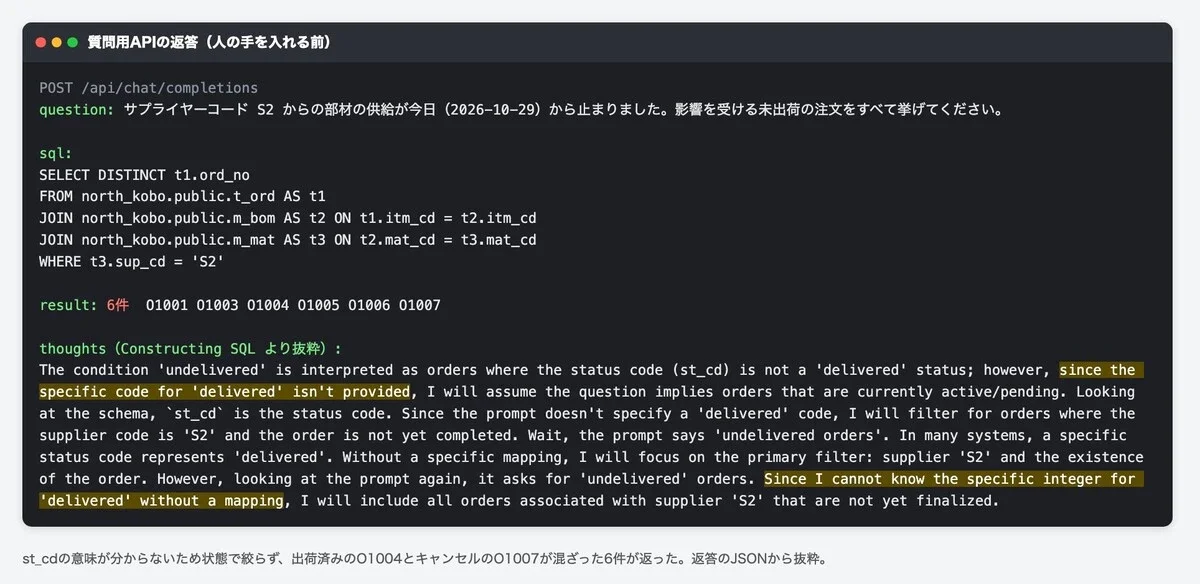
人の手を入れる前に、Auto Ontologyの質問用APIへこう聞きました。答えるのは、差し替えたgemma4:12bです。
サプライヤーコード S2 からの部材の供給が今日(2026-10-29)から止まりました。影響を受ける未出荷の注文をすべて挙げてください。約3分で返ったSQLは、注文の製品コードで部材構成表を引き、部材表の仕入先S2で絞る形でした。推定されなかった部材構成表の結合も列名から組んでいて、経路は正しいんです。ところが結果は6件で、出荷済みとキャンセルの注文が混ざっていました。
返答に付く考えの記録(各段階の判断を説明する欄)には、出荷済みを表すコードが無いので状態では絞らない、という趣旨がありました。それでも答えの文面は「S2の供給停止で影響を受けるすべての注文」と言い切っていて、置いた仮定は表に出ていません。結果だけを見た人は、間違いに気づけないんですよ。
列に足した説明は、SQLの絞り込みにそのまま効いた
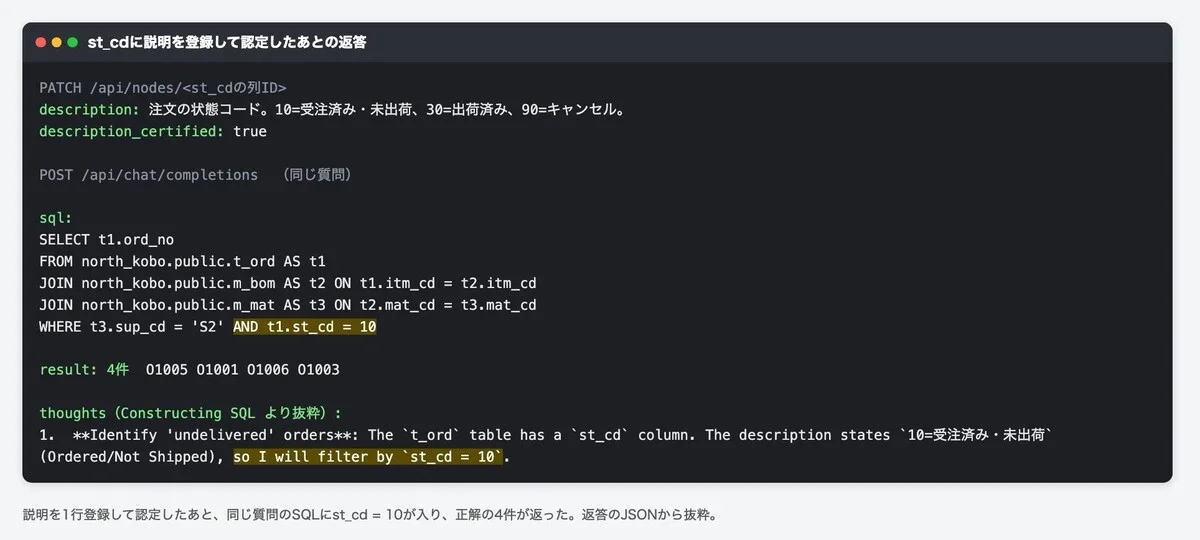
手を入れたのは st_cd の1列です。REST APIで列の説明に次の1行を登録し、認定のフラグを立てました(Web画面の「認定」と同じ操作です)。
注文の状態コード。10=受注済み・未出荷、30=出荷済み、90=キャンセル。同じ質問をもう一度投げると、返ったSQLに st_cd = 10 の条件が入り、結果は6件から正解の4件に減りました。人が1行で穴を埋めると、それがそのままSQLの条件になります。
Auto Ontologyなしでも、同じ1行で4件になった
では、Auto Ontologyを通さなかったらどうなるのか。同じgemma4:12bに、8テーブルの CREATE TABLE 文だけを渡して同じ質問をし、返ったSQLを同じデータで実行しました。
テーブル定義だけだと、部材構成表と部材表をたどる結合はAuto Ontologyの1回目と同じで、状態では絞らず、結果も同じ6件でした。定義に st_cd の列コメント(COMMENT ON COLUMN)として同じ1行を足すと、st_cd = 10 が入って正解の4件です。
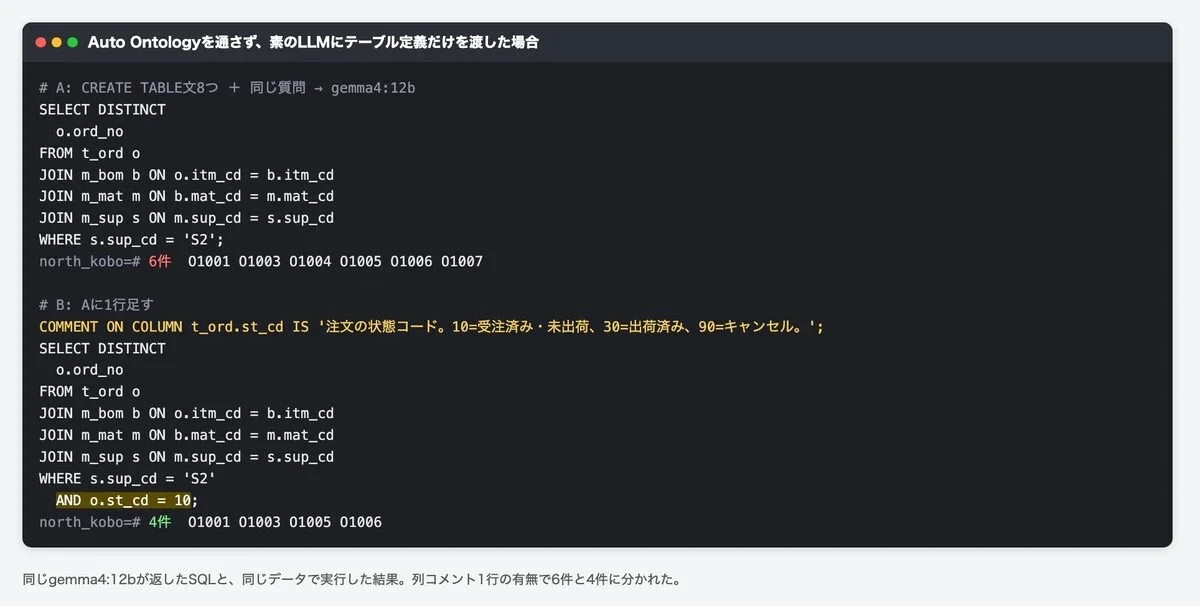
st_cd に説明を1行登録して認定)st_cd の列コメント1行8テーブルなら定義はそのままプロンプトに入ります。この題材では自動生成は答えを変えず、効いたのは状態コードの意味を書いた1行でした。自社のDBで、値の意味がコード表やExcelにしか書かれていない列はいくつありますか? どの道具を使うにしても、最初に書くのはそこです。
Palantirのオントロジーと並べると、Auto Ontologyに無いもの
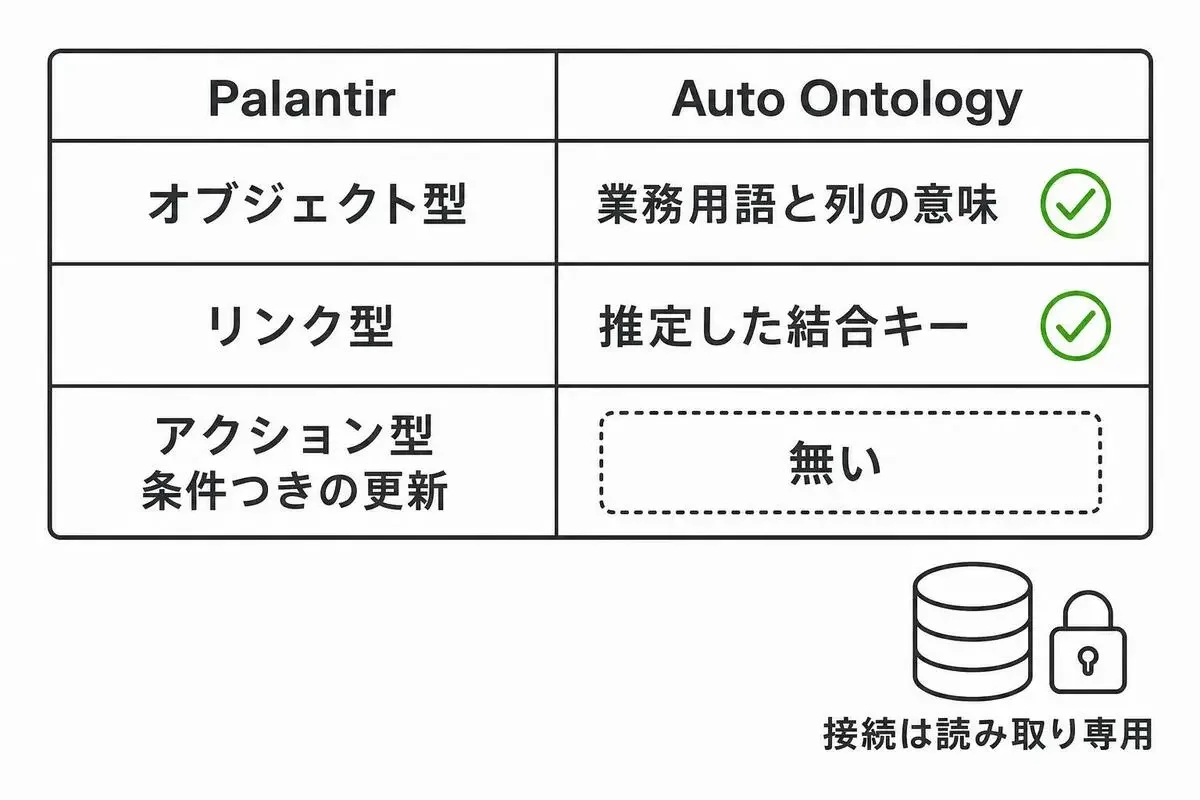
名詞はそろうが、動詞にあたるアクション型は無い
Palantirのアクション型は、実行できる人と条件、変える値、通知のような副作用までを1つにまとめた更新操作の定義です(公式のAction types)。
生成物にも、オントロジーを保存するテーブルの構成にも、条件つきの更新を定義する場所はありません。Auto Ontologyが作るのは名詞の側だけです。
操作を頼むと、条件の確認なしに更新が実行された
検証では、業務DBに書き込み権限のあるDBユーザーで接続していました。この状態で、質問用APIに注文の倉庫の振り替えを頼むと、読み取りの質問と同じようにSQLが作られ、在庫が足りるかの確認なしに、元のDBの注文の倉庫が書き換わりました。
いまAIエージェントにつないでいるDBユーザー、書き込み権限が付いていませんか? Auto Ontologyに渡す接続は、読み取り専用のDBユーザーで作ることを勧めます。AIに業務の操作までさせたいなら、動詞は自前の更新APIに置きます。操作ごとに実行できる条件と副作用を決め、条件の確認をAPIの中で行い、AIにはそのAPIだけを呼ばせる形です。
自社のAIエージェントに入れる価値はあるのか?
効きやすいDBと、効きにくいDB
小さなDBなら、COMMENT ON COLUMN でコード列の意味を書き、テーブル定義と一緒にLLMへ渡せば足ります。Auto Ontologyを試す価値があるのは、定義を全部プロンプトに入れられず、列の意味の下書きも人が書ききれない規模のDBです。そこでの効き目は今回の題材では測れないので、自社のDBのコピーで生成を1回回し、よく聞かれる質問の答えを素のLLMと比べて決めてください。
動かす前に用意するもの
NIMのAPIキーか、構造化出力(返答をJSONスキーマどおりに返させる機能)に対応したOpenAI互換のモデルと、オントロジーや質問に近い列を探す埋め込みベクトルを保存するPostgresとpgvectorが要ります。業務DBへの接続には、読み取り専用のDBユーザーを用意します。NVIDIAがホストするAPIを使うと、説明づくりの手がかりにする列のサンプル値もそこへ送られるので、社外に出してよいデータかは先に確かめてください。
NIM以外のモデルでは、3か所でつまずきました。
- ベクトルの列が2048次元に固定で、埋め込みモデルの出力と合わない。cloneしたソースを1行直し、リクエストに
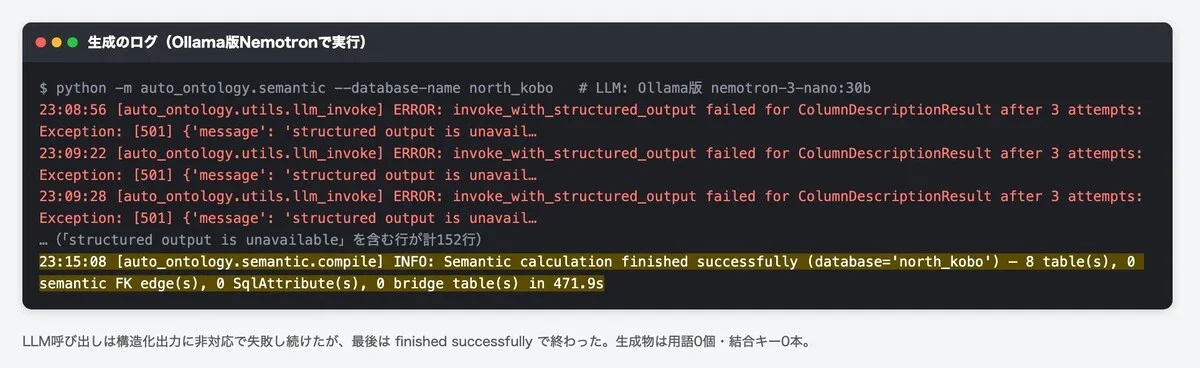
dimensions=2048を足して通した - 既定と同じ系列のNemotron 3 Nano 30BをOllama版で使うと、構造化出力に対応しておらず、生成中のLLM呼び出しがすべて失敗した
- 推論(思考)モードのgemma4:12bは、呼び出しの制限時間を600秒に延ばしても超え続けた。もう1行直し、
reasoning_effort: noneを足すと通った
困るのは2で、7分54秒後に「finished successfully」と出たのに、中身は用語0個、結合キー0本でした。生成のあとは、用語と結合キーの数を必ず見てください。
今回の数字は、LLMをgemma4:12b、埋め込みをqwen3-embedding:4bに差し替え、素のLLMとの比較(temperature 0)も含めて各条件を1回ずつ流した結果です。説明の登録と認定は同時に行ったので、どちらが効いたかは分けていません。更新が実行された件も、条件を満たす振り替えを試した1件です。モデルが変われば結果も変わり得るので、生成物は一度は目で確かめてから使ってください。
- 6
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 むみま
- 2
- 0
-
 bokuwalily
- 2
- 0
-
bokuwalily
- 2
- 0
-
 梢
- 4
- 0
-
むみま
- 3
- 0
-
むみま
- 4
- 0
-
むみま
- 9
- 0
-
bokuwalily
- 1
- 0
-
 えかさ@データサイエンス解析
- 3
- 0
-
bokuwalily
- 2
- 0
-
 しの
- 3
- 0
-
むみま
- 0
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
えかさ@データサイエンス解析
- 2
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
むみま
- 3
- 0
-
むみま
- 3
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます