
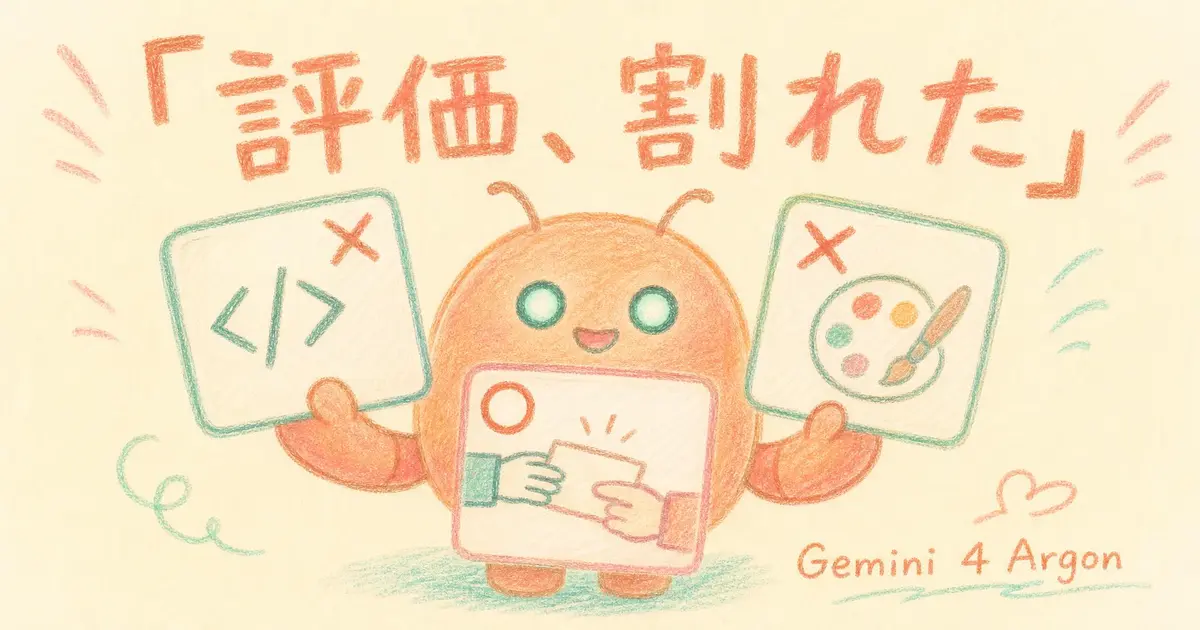
Gemini 4 Argonは、10月13日から一般に使えるようになったGoogleの新しいモデルです。海外の使い手の評価は用途でくっきり分かれていて、コード作業とデザインには厳しい声が、AIに長い作業を任せる使い方には好意的な声が出ています。
有料プランに入ってまで試す価値があるのか、迷っていませんか? 誰がどの用途で何と言ったのかを並べると、自分の仕事で先に試す用途と、後回しにする用途が決められます。
GeminiアプリでGemini 4 Argonを使えるのは、ProとUltraの加入者
日本のGeminiアプリでは、Google AI ProとGoogle AI Ultraの加入者が対象です。Googleの日本語ブログが10月14日付で伝えていて、無料のままでは選べません。
9月30日に発表された時点では、セキュリティ担当者向けの先行提供が中心でした。Geminiアプリでは、最上位のUltra加入者だけが先に使えたと報じられています。一般向けの提供は、英語の公式ブログで10月13日に始まっています。Googleが売りにしているのは、曖昧な表現を減らして質問に直接答えること、長い作業の途中経過をこまめに伝えること、パソコンの前を離れている間も作業を進めるタスク機能です。
APIで自社のツールに組み込む人向けに補足すると、今の料金は導入価格です。100万トークンあたり入力2ドル、出力10ドル(1ドル=150円で計算して約300円と約1,500円)で、導入価格は11月30日までです。12月1日からは倍の4ドルと20ドル(約600円と約3,000円)になります。
1. コード作業では、Argonは「使えない」という評価
開発者向けの発信で知られるTheoさんは、自分のコードベースでの実作業について「outright unusable」(まったく使えない)と投稿しました。理由は、システムがどう動くかについて、もっともらしい間違いを強気に言い切ってくることです。AIが事実と違う内容をそれらしく答えてしまう現象を、ハルシネーション(幻覚)と呼びます。
続く投稿の要旨はこうです。ある点で5%劣る、別の点で3%勝るといった程度の差の話ではなく、試したほぼすべてのテストで主張の半分以上が事実と違っていた。自分のコードベースでは、ほかのモデルが首位を入れ替える中で、Geminiは常に最下位だった。
コードを書かない人には関係ない、と思いますよね。でも、表計算の関数が何をしているのか、社内の申請がどこで止まっているのかをAIに説明させる場面はあるはずです。私は、仕組みの説明を頼む用途ほど、Argonの答えを鵜呑みにしないほうがいいと考えています。使うなら、根拠の場所まで書かせて、元の資料と照らし合わせる前提にします。
2. 3時間任せても、Argonにイライラしなかった
反対に好意的だったのが、Keshav Jindalさんです。Gemini 4 Argonと3時間作業して、その間一度もイライラさせられなかった、Googleよくやった、と投稿しています。
ただし条件つきです。使っていたのはDroidというツールの中で、パソコンの画面操作はOpenAIのCodexに任せていた、と本人が補足しています。Droidは、ゴールを伝えるとAIが計画を立て、ファイルの編集やコマンドの実行まで進めるエージェントのツールで、主にソフトウェア開発のチーム向けです。
3時間で何を仕上げたのかは、投稿には書かれていません。それでも「長い作業を任せてもストレスが少ない」という声は、Googleが売りにする「途中経過をこまめに伝える」「離れている間も作業を進める」と同じ方向を向いています。
あなたの仕事に、AIに任せると30分以上かかりそうな作業はありますか? 複数の文書を読み比べる下調べや、過去の議事録から決定事項を拾い直す作業がそれに当たります。途中で何度も口を挟みたくなるタイプの仕事こそ、Argonを試す候補の筆頭です。
3. デザインを任せたArgonは、遅くて見栄えが悪かった
AIニュースレターBen's Bitesを書いているBen Tossellさんは、10月15日の号でArgonを取り上げました。主に試したのはデザインの力で、遅いうえに見た目も良くなかった、それほど良いモデルだとは思わない、という評価です。
何をデザインさせたのかまでは書かれていません。会社員の仕事に置き換えるなら、スライドの見た目や資料の図、簡単な画面の見本を作らせる使い方が近いところです。
資料の見た目づくりを、いまAIに頼っていますか? この用途のためにプランを変えるなら、今使っているAIと同じ指示を出して、出来上がるまでの時間と見た目を並べてから決めても遅くありません。
ベンチマークでも、Gemini 4 Argonの順位は1位と8位
評価の割れ方は、第三者の性能評価にも出ています。Vals AIのVals Indexは、金融・法務・税務・コーディングの8つのテストを、各分野が米国経済に占める割合で重み付けした指標です。10月12日時点で、Argonは68.90%で1位でした。
一方、10種類の評価を合わせたArtificial Analysisの総合指標では53点で、216モデル中8位にとどまります。Artificial Analysisが測ったTerminal-Bench 4.0(コマンド操作中心のコーディング)でも、Argonは57%で、Claude Sonnet 5.5の64%、Claude Opus 5.5の60%を下回りました。Let's Data Scienceの記事は、Vals Indexが測っているのは文書や表計算を使う長い実務で、GoogleがArgonを作った狙いもそこにある、と整理しています。
ハルシネーションの数字は、Theoさんの評価と逆に見えます。Artificial Analysisの測定では、Argonの幻覚率は15%で、GPT-6 Astraの51%を大きく下回りました。ただ、これは間違えると減点され、答えを控えても減点されない知識問題のテストです。Theoさんが見ていたのは、自分のコードの仕組みについての説明でした。測っている場面が違うので、どちらが正しいかはこの2つの数字だけでは決められません。
自分の仕事でGemini 4 Argonを試すなら、どこから?
3人の評価を並べると、試す順番は見えてきます。先に試すのは長い作業を任せる使い方で、仕組みの説明とデザインは、今のAIと並べて確かめてから決める。どれもPro以上の加入が前提なので、無料体験や1か月だけの加入で確かめられるかを、加入画面で先に確認しておきましょう。
- 30分以上かかっている作業を1つ選ぶ。複数の資料を読み比べる作業が向いています
- 今使っているAIとGemini 4 Argonに、同じ資料と同じ依頼文を渡す
- 終わるまでの時間、途中で口を挟んだ回数、事実の間違いの数を書き留める
- デザインも比べたい場合は、同じ指示でスライドを1枚ずつ作らせて並べる
依頼文は、間違いを数えやすい形にしておくのがコツです。
次の資料を読んで、{{知りたいこと}}をまとめてください。
まとめの中の事実には、それぞれ資料のどこに書いてあるか(ページ番号か見出し)を添えてください。
資料に書かれていないことは推測で補わず、「資料に記載なし」と書いてください。

{{資料の本文}}
根拠の場所が添えてあれば、元の資料と照らし合わせるのが数分で済みます。Theoさんが指摘した幻覚が自分の資料でどれくらい出るのかも、この照合で分かります。社外秘の資料を入れる前に、会社のAI利用のルールも確認しておいてください。
海外の評価が割れているからこそ、決め手になるのは自分の仕事での数字です。最初の1回、どの作業をArgonに任せますか?
- 7
- 0
元ブラック企業社畜。残業100時間超の職場を抜けて、今は普通の会社員。 次は会社そのものから抜ける準備中。AI×副業で試したことを、失敗も含めて書きます
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
コードを読まないAIエンジニア
- 4
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
 コバ
- 3
- 0
-
 むみま
- 7
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 4
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます