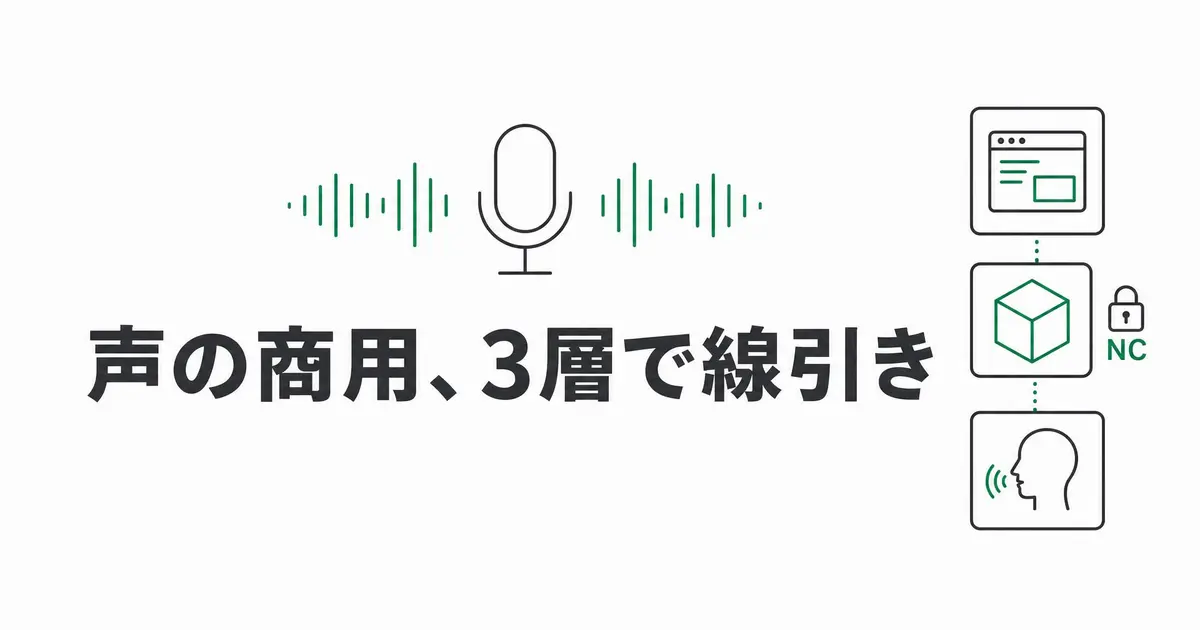
ElevenLabsの請求を見るたびに、GitHubで約5.1万スターを集めたVoiceStudioへ移れないか考えていませんか? 先に結論を書くと、VoiceStudioのアプリ自体は商用利用できますが、既定の声モデルOmniVoiceの重みは非商用ライセンスなので、収益化したブログや動画のナレーションにはそのまま使えません。どのエンジンなら商用に回せるのか、ライセンスを3層に分けて線を引きます。
VoiceStudioはElevenLabsの代わりになるのか?
VoiceStudioは、音声クローン、読み上げ、文字起こし、動画の吹き替えを自分のPCで回すデスクトップアプリです。スターは2026年10月1日時点で約5.1万。リポジトリのトピックにも elevenlabs-alternative が付いていて、開発者自身がElevenLabsの代替を名乗っています。
並べてみると、差が大きいのは費用より商用の扱いです。金額は1ドル150円で換算しています。
「完全ローカル」と紹介されがちですが、通信ゼロではありません。初回に既定モデルの重みを数GB単位でダウンロードしますし、利用状況の送信は同意制です。
あなたが今ElevenLabsで作っている音声は、どこに出していますか? 広告の付いた動画や仕事の納品物なら、ここから先の線引きがそのまま効いてきます。
商用利用の可否は、アプリとモデルと声の3層で決まる
1層目はアプリです。VoiceStudioのコードはAGPL-3.0で、LICENSE-NOTICE.md は商用利用も社内利用も認めています。義務が生じるのは、改変したVoiceStudioをネットワーク越しに他人へ使わせる場合で、そのときは改変版のソースを公開します。生成した音声ファイルにAGPLが及ぶかどうかは、公式のドキュメントに記述がありません。
2層目は、声を作るモデルです。READMEの末尾には「Models have their own licenses; review them before commercial use.」とあり、重みはアプリと別のライセンスで配られています。TTSエンジンの一覧は同じモデルの別の動かし方を含めて17行あり、どれを選ぶかで商用の可否が変わります。
最後が声の持ち主です。READMEは「Clone voices only with permission.」と書き、公式サイトもなりすましや詐欺への利用を認めていません。自分の声か、本人から許可をもらった声だけをクローンする。ここはライセンスを読む前に決まる話です。
既定のOmniVoiceは、収益化した動画に使えるのか?
VoiceStudioを入れて最初に動くのは、k2-fsaのOmniVoiceです。Hugging Faceのモデルカード(2026年7月3日更新)には、こう書かれています。
Our code is released under the Apache 2.0 License. The pre-trained model is licensed under the CC-BY-NC due to constraints from its training data (e.g., Emilia).
コードはApache 2.0、学習済みの重みはCC-BY-NCで、NCは非商用の意味です。LICENSE-NOTICE.md も同じ内容を載せていて、音声トークナイザにはHiggs Audio 2とLlamaのコミュニティライセンスが別にかかるとも書いています。
「OmniVoiceはApache 2.0で商用も自由」という紹介も見かけますが、それはコードの話なんですよ。声を作っているのは重みのほうです。
広告収益のあるYouTube動画、アフィリエイト付きのブログ、受託したナレーション案件。私は、このどれも非商用の範囲には入らないと判断します。既定のOmniVoiceで作った音声は、聞き比べと練習までに留めるのが安全です。
「Pro版を買えば商用で使えるのでは?」と思いますよね。ところが LICENSE-NOTICE.md は、VoiceStudio側の商用ライセンスはモデルの条件を置き換えないと明記しています。Pro版で同梱モデルが変わるかどうかは、公開情報では確認できませんでした。
商用に回せるVoiceStudioのエンジンは、重みのライセンスで選ぶ
2026年10月1日時点のモデルカードとVoiceStudioのドキュメントで仕分けました。日本語の列は対応言語に日本語が載っているかどうかで、品質の評価ではありません。
IndexTTS 2.5は、月間アクティブユーザー1億人超か、年商10億人民元(約200億円)超の組織に別契約を求めます。個人の発信なら規模の条件には届きませんが、ほかの条項もあるのでライセンス本文を読んでから使ってください。
PocketTTSやGPT-SoVITSのように、重みの条件を一次情報で確かめきれなかったエンジンは表に入れていません。モデルカードは更新されることがあるので、使う日にもう一度ライセンス欄を見ておくと事故が減ります。
日本語の音声クローンは、同じ原稿で聞き比べて決める
日本語の品質は、今のところ自分の耳で確かめるしかありません。VoiceStudioのベンチマーク表は「No verified rows yet」のままで、日本語の公式評価もありません。OmniVoiceの学習データも、日本語は約3.7万時間で、英語の約20.6万時間の5分の1以下です。
手順はこう組みます。
- 雑音のない自分の声を10秒前後録る。VoiceStudioの推奨は5〜15秒、OmniVoiceの最適帯は3〜10秒
- 参照音声と同じ日本語で、数字や英単語、固有名詞を混ぜた原稿を用意する
- OmniVoice、VoxCPM2、CosyVoice 3で同じ原稿を生成し、アクセントと読み間違いを並べて聞く
- 英語の参照音声から日本語を読ませる組み合わせは、別枠で試す
原稿は、たとえばこんな3文で足ります。
本日の配信は午後7時30分から、ゲストは田中さんです。
新しいAPIの料金は、1,000リクエストあたり150円になりました。
詳しくはGitHubのREADMEをご覧ください。
4番目を分けるのは、言語をまたぐクローンだとアクセントの質がエンジンごとにばらつくと、OmniVoiceのドキュメント自身が書いているからです。
あなたの動画で読ませたいのは、英単語の多い技術解説ですか、それとも語りですか? 技術解説なら、原稿の英単語を増やして読み方の崩れを先に見ておくと、本番での手直しが減ります。
VoiceStudioを動かすPCと、MCPで声を渡すときの注意
Macは、macOS 13.3以降のApple Siliconが対象で、Intel Macでは手元でバックエンドが動きません。Windowsは10(21H2以降)か11のx64で、GPUで速くなるのはNVIDIAだけ。AMDのGPUはCPUで動きます。
空きディスクは約10GB。既定のOmniVoiceは専用GPUならVRAM 6GBが目安で、公式サイトはRAM 8GB程度、GPUなしでも始められるとしています。
VoiceStudioは http://localhost:3900/mcp/ にMCPサーバーを立て、generate_speech や clone_voice、transcribe などのツールを出します。Claude Code、Cursor、Codex CLI向けの設定はアプリから書き出せるので、エージェントに声を持たせるのも難しくありません。
ただしMCPの通信は認証なしなので、インターネットに公開してはいけません。LANで使う場合もPINは暗号化されずに流れるため、信頼できないネットワークではTailscaleなどの暗号化した経路を通します。エージェント経由で生成しても、既定のOmniVoiceを使えば非商用の条件はそのまま付いてきます。
既定のままのVoiceStudioは、聞き比べと練習のための道具です。公開する音声を作る日は、表で商用可のエンジンに切り替え、声の持ち主の許可を確かめてから始めてください。
- 1
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 ぬまた
- 3
- 0
-
 Mako
- 3
- 0
-
 村井
- 6
- 0
-
コードを読まないAIエンジニア
- 1
- 0
-
 かなえ@脆弱性診断
- 2
- 0
-
 gen
- 3
- 0
-
- 1
- 0
-
- 3
- 0
-
gen
- 5
- 0
-
gen
- 3
- 0
-
- 3
- 0
-
gen
- 2
- 0
-
gen
- 6
- 0
-
- 2
- 0
-
gen
- 1
- 0
-
- 4
- 0
-
- 2
- 0
-
- 3
- 0
-
gen
- 4
- 0
-
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます