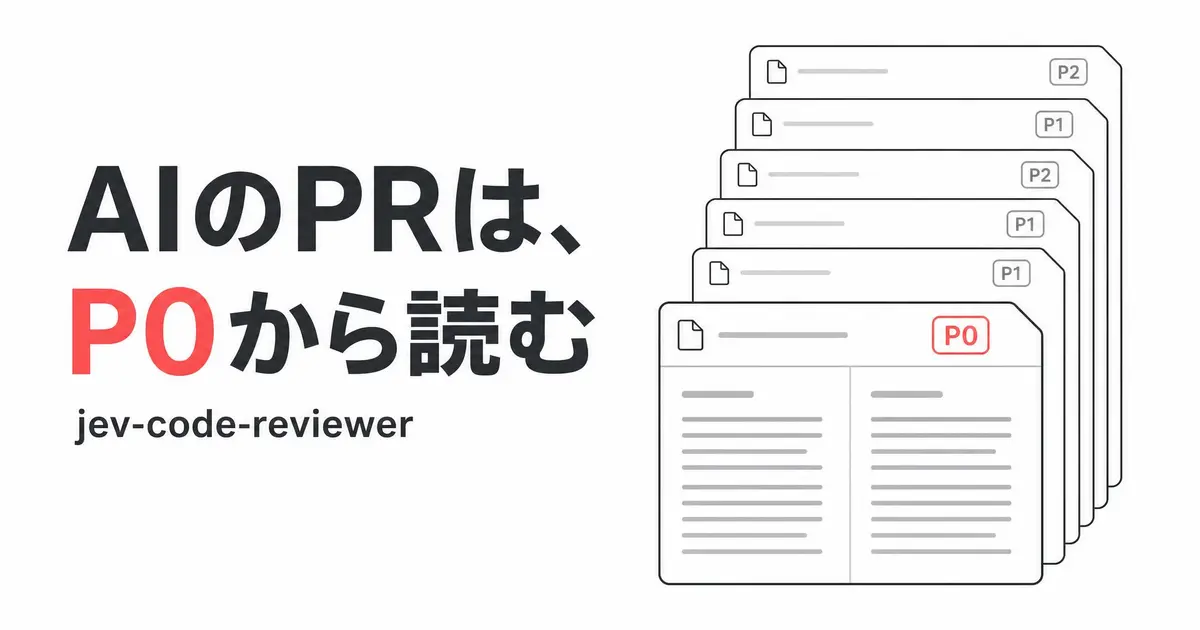
AIが書いたPRのレビューで疲れるのは、読み始める前です。Claude CodeやCodexのPRが20ファイル変わって届くと、どこから読むかを決める前にぐったりしてしまいます。最初に開くファイル、どうやって決めていますか?決め手がないまま、全部読むか、読まずにマージするかの二択になりがちです。
jev-code-reviewerは、この「読む前の疲れ」を軽くするためのOSSです。指摘を増やす道具ではなく、人が読む量と読む形、考えることを絞る道具なんですよ。デモのPRでは、最初に開く変更が4つのうち1つだけでした。
AIが書いたPRのレビューは、なぜ負担が大きいのか?
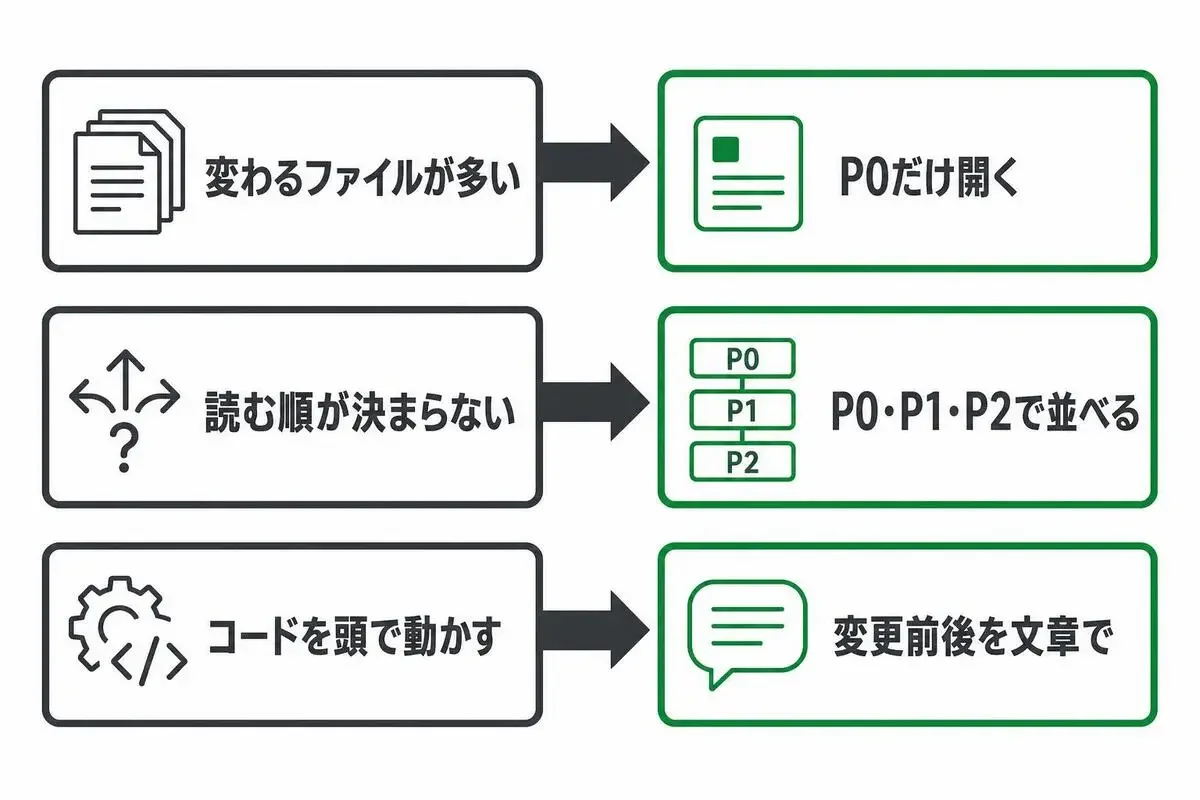
READMEも冒頭で、エージェントが作ったPRは一度に多くのファイルが変わるので人には理解しにくい、という趣旨を書いています。負担の出どころを分けると、1. 一度に多くのファイルが変わる、2. 読む順が決まらない、3. コードを頭の中で動かして意味を読み取る必要がある、の3つになります。
jev-code-reviewerは、この3つにそれぞれ仕掛けを当てています。
優先度を判定するのはTypeSafeの判定モデルJevで、説明文はOpenAIのAPIが書きます。結果は手元の画面に出るだけで、GitHubには何も投稿しません。なお、P0/P1/P2は「注意の優先度」で正しさの保証ではない、と公式が明記しています。
jev-code-reviewerは、まずキー無しのデモで試す
APIキーもGitHubの認証もなしで、どこまで見られるのか?答えは、本物の判定結果を載せたデモ画面までです。
git clone --depth 1 https://github.com/egma-ai/jev-code-reviewer.git
cd jev-code-reviewer
npm install
npm run test:core
npm run demo
Node 22の使い捨てコンテナで試したところ、cloneが2秒、npm install が約3秒でした。npm run test:core の28件も約1秒ですべて通りました。
npm run demo を実行すると、http://127.0.0.1:4731/demo にGitHubのPR「Files changed」画面を模したページが開きます。起動時のメッセージには、説明文はOpenAIの出力ではなく用意された文だと出ます。一方で優先度の判定は、Jevの実APIで判定した結果を記録したものです。
P0だけを開いて、変更前後の説明から読む
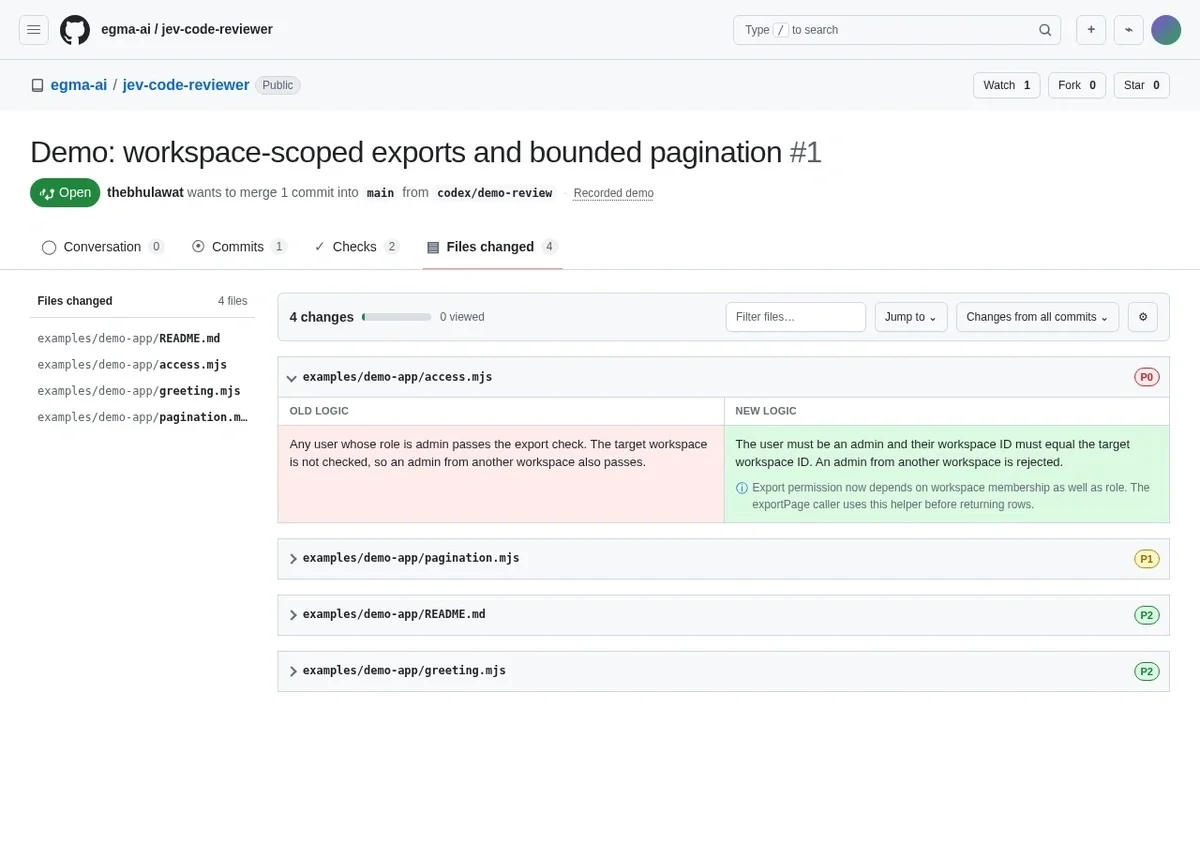
デモの画面を開くと、展開されているのは access.mjs の1件だけで、残り3件は折りたたまれていました。どこから読むかを、自分で決めなくていいんです。
4つの変更のうち、最初に開くのは1つ
判定データ(demo/report.json)の中身はこうです。
access.mjsエクスポート権限に「同じワークスペースか」の条件を追加。P0(確率0.99)pagination.mjsページサイズを1〜100に正規化。P1README.md誤字の修正。P2greeting.mjs文字列の連結をテンプレート文字列に書き換え。P2
権限の変更が最優先で、誤字は後回しという、人の感覚と同じ並びです。最初に読むのは1つで済みます。P1はP0のあとに読む「人の確認を勧める」変更、P2は機械的な変更として後回しにできます。ただしP2も正しさの保証ではないので、注記があれば目を通します。
コードの代わりに、変更前後の動きが並ぶ
開いたファイルには、コードの代わりに「OLD LOGIC」と「NEW LOGIC」の2列で、変更前と変更後の動きが英文で並びます。その下には変更点の注記が出ます。デモの用意された文では、P2の greeting.mjs にも「独自の型変換を持つオブジェクトが渡されると結果が変わりうる」と添えられていました。
つまり、コードを頭で動かす作業が、文章を読む作業に変わります。
P0の説明は「意図はどちらか」を聞いてくる
デモでは、ここが一番よくできています。P0の説明は「サポート担当や組織横断の管理者は、ワークスペースをまたいでエクスポートできるべきか?」という問いで終わります。答えるのは「意図はどちらか」だけなので、読む側は自分の仕様と照らせば足ります。ただし説明文は用意されたもので、実際にOpenAIが書く文でも同じ形になるかは試せていません。
P1の説明も「上限100は意図どおりか、不正値は20に戻すのか、エラーにするのか」と聞く形でした。これなら、コードを追う作業が減り、人が決めるべき仕様の判断だけが残ります。
手元の大きなPRなら、人が決めるべき変更は何か所ありそうですか?その数が少ないほど、P0だけを開く画面の効果は大きくなります。
負担を減らしすぎないための、必ず人が見るパス
読む量を絞れるほど、見るべき変更まで折りたたまれる心配が出てきます。そのための網が2段あります。
迷ったらP0に寄せる仕組み
ソースを読むと、1位と2位の確率の差が0.15以下なら、優先度を uncertainPriority(既定はP0)に引き上げます。この設定にP2は指定できず、指定するとエラーになります。つまり、既定の設定では、判定モデルが迷った変更は折りたたまれずに開く側へ倒れます。
既定で網に掛かるのは3つのパスだけ
もう1段が「必ず人が見るパス」で、既定は **/auth/**、**/migrations/**、**/.github/workflows/** の3つです。引き上げの処理(applyPolicy)に、Jevが全部P2と判定した想定でパスだけ変えて流してみました。
prisma/migrations/x/migration.sqlapp/auth/session.js.github/workflows/ci.ymldb/migrate/20261006_add_col.rbapp/controllers/sessions_controller.rbapp/payments/charge.jsRailsのマイグレーション、セッション周り、決済はパスの網では拾われません。Jev本体の判定でP0になる可能性はありますが、そこは試せていません。
この穴は自分で塞げます。ただ、塞ぎ方に落とし穴が一つありました。
.jev-reviewer.jsonには、既定の3つも書き写す
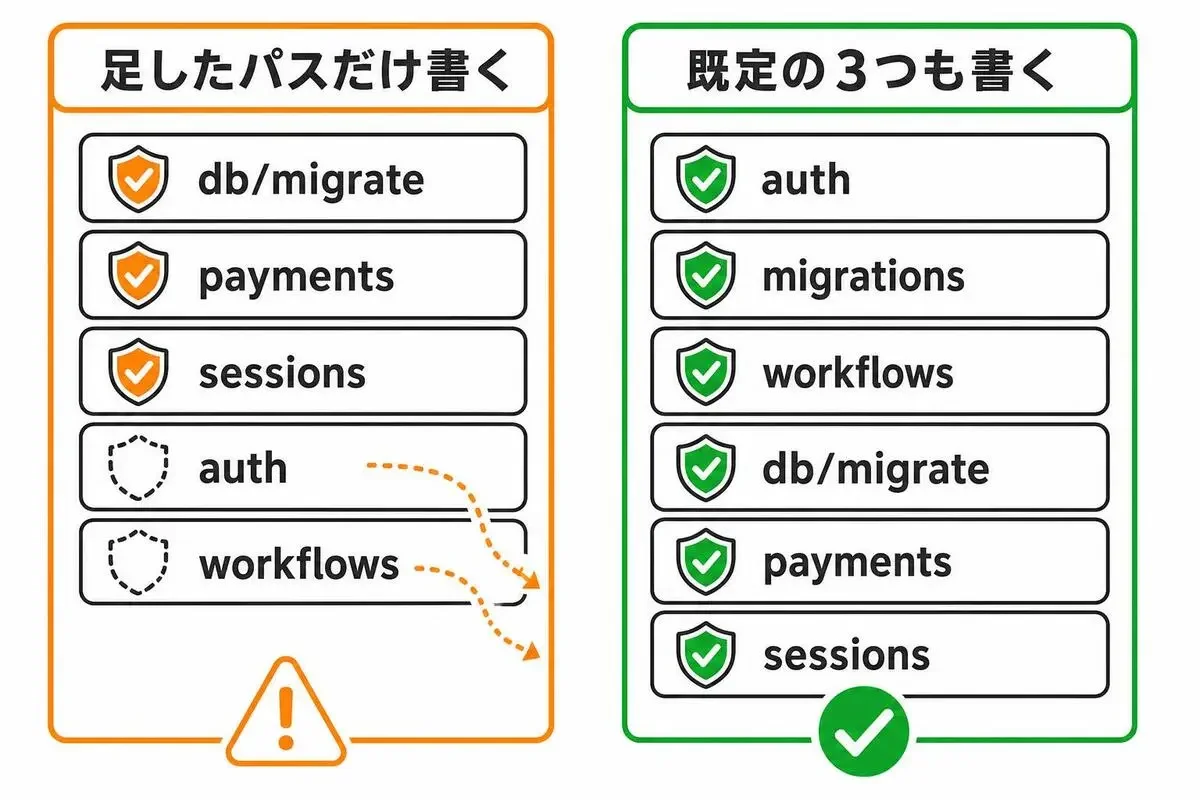
網を足すには、リポジトリ直下に .jev-reviewer.json を置きます。
足したいパスだけ書くと、db/migrate や決済のパスは狙いどおりP0になりました。ところが、Jevが全部P2と判定した想定で流すと、もともと守られていたはずの app/auth/session.js と .github/workflows/ci.yml がP2に戻ったんです。足したつもりが、既定を消していたわけです。src/config.mjs を読むと、設定は最上位の項目ごとに上書きされ、alwaysReviewPaths は配列ごと置き換わります。同じ理由で既定の **/migrations/** も外れます(こちらは追試していません)。
READMEの案内は、config/policy.json を .jev-reviewer.json に丸ごとコピーして調整する方法です。足したいパスだけを書くと既定が消えることは、書かれていません。なので、既定の3つも書き写すのが正解です。
{
  "alwaysReviewPaths": [
    "**/auth/**",
    "**/migrations/**",
    "**/.github/workflows/**",
    "db/migrate/**",
    "**/*sessions_controller.rb",
    "**/payments/**"
  ]
}この設定で同じ想定を流すと、6つのパターンに当たるパスはすべてP0になり、docs/readme.md だけがP2に残りました。
人が必ず見る場所は、リポジトリごとに違います。権限、課金、DBの構造、CIの4つは、あなたのリポジトリだとどのフォルダにあるでしょう?その4つのパスを書き出してから設定すると、漏れにくいですよ。
jev-code-reviewerを自分のPRで使う手順
jev-code-reviewerの使い方は、デモで試す段階と、自分のPRで使う段階に分かれます。後者に必要なのは、Node 22以上、gh auth login 済みのGitHub CLI、PRのリポジトリのローカルクローン、TypeSafeとOpenAIのAPIキーです。
npm link
jev-reviewer setup
jev-reviewer doctor
jev-reviewer serve
jev-reviewer analyze --pr <PRのURL> --repo <クローンのパス>
公式の手順では、Chrome拡張を chrome://extensions から読み込み、jev-reviewer token のトークンを拡張に貼ってペアリングします。あとはPRのFiles changedで「Show logic in place of code」をオンにすると、説明が重なって表示されます。
私の環境で試せたのは doctor までです。Nodeとgitは✓、ghの未ログインと2つのキーは✗でした。自分のPRでの analyze、本物のGitHub画面への重ね表示、OpenAIが書く説明文の質は確かめていません。
使う前に知っておきたい点はこちらです。
analyzeは変更したコードと周辺の文脈をTypeSafeとOpenAIに送る- 既定の解析は先頭12の変更単位まで。
--max-unitsで最大100 - 対応はGitHubの旧Files changedページ(
/pull/<番号>/files)だけで、新しい/changesページは未対応 - キーは
~/.config/jev-reviewer/credentials.jsonに保存され、暗号化はされない - エージェント用のスキルを入れると、エージェントがPRを作った流れの最後に
analyzeを走らせる。ただし確実に動く保証はなく、常駐の監視でもない
CodeRabbitやCopilotのAIコードレビューと併用するなら
既存のAIコードレビューとは、結果の置き場所と役割が違います。
併用は試せていませんが、先にjev-code-reviewerでP0を決めてから指摘を読む順番が進めやすいと考えています。決めるべき変更が分かっていれば、どの指摘から片付けるかで迷いにくくなります。
向いているのは、AIが書いた大きめのPRを前に、読む順を決めるところで手が止まる人です。社外のAPIにコードを出せないリポジトリや、新しい /changes ページで読んでいる人には向きません。
最初の一歩は、キーもログインも要らないデモだけです。npm run demo まで進めば、P0だけが開く画面が出ます。気に入ったら、自分のリポジトリの「必ず見る場所」を既定の3つごと .jev-reviewer.json に書いてから、自分のPRへ進んでください。
- 5
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 ノック
- 1
- 0
-
コードを読まないAIエンジニア
- 3
- 0
-
 gen
- 2
- 0
-
- 1
- 0
-
 ぬまた
- 3
- 0
-
 Mako
- 3
- 0
-
 三枝
- 4
- 0
-
 Tonbo
- 4
- 0
-
 かやの
- 5
- 0
-
 Brio
- 3
- 0
-
 にくたま
- 6
- 0
-
 村井
- 6
- 0
-
 みどり
- 6
- 0
-
 ケケス
- 3
- 0
-
 しげ
- 4
- 0
-
 トトキ
- 5
- 0
-
 Nina
- 4
- 0
-
 Nopecrumb
- 3
- 0
-
 にふだ
- 3
- 0
-
 フルイ
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます