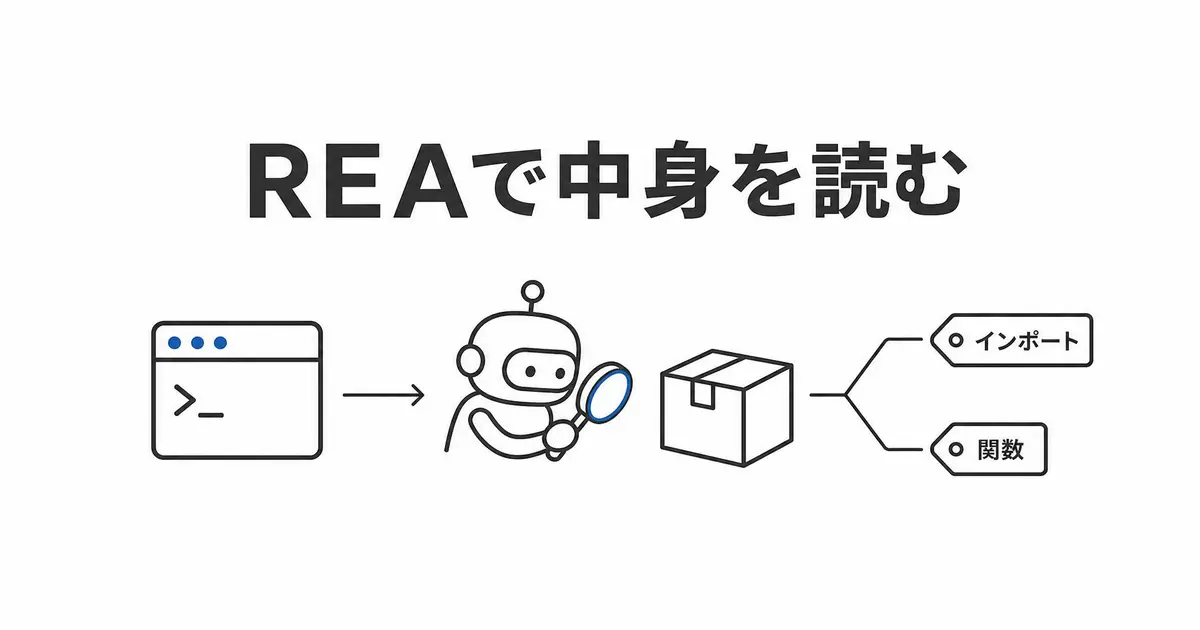
REA(Reverse Engineer Anything)は、ソースコードが手元にないアプリの中身を、Claude CodeやCodexなどのAIエージェントに調べさせるためのMCPサーバーです。MITライセンスのOSSで、npx rea-agents setup の1行で入ります。
バイナリしか残っていない社内ツールや、引き継いだElectronアプリの処理の流れを、エージェントに読ませたいと思ったことはありませんか? REAの仕組みと導入でつまずく所、REA自身が引く「やってよい解析」の線を整理します。
Node.js 22の使い捨てコンテナに入れて、自分で書いたメモアプリを解析させています。
REAは、AIエージェントにアプリを解析する道具を持たせるMCPサーバー
REAを入れると、エージェントが逆コンパイルや構造の解析、実行時の挙動の記録といった道具を使えるようになります。READMEの使い方の例は「Notesアプリの検索の仕組みを、根拠を示しながら調べて、似た機能を作って」という頼み方です。
対応するエージェントはClaude Code、Codex、Cursor、Gemini CLI、Grok Buildなど。GitHubのスターは2026年10月22日時点で約35万7千あります。
嬉しいのは、結論ごとに根拠と限界を付けて返す点です。どの行を見たのかが分かれば、エージェントの説明を裏取りしやすくなります。
なお、解析は手元で行われますが、結果はエージェントに渡り、モデル提供元のデータ方針に従います。社外に出せないアプリなら先に確認しておきます。
REAにGhidraは要るのか、答えは解析する対象で変わる
READMEの表を整理するとこうなります。
ネイティブのバイナリを深く読むには、GhidraかIDA Proを自分で用意するか、setupでHopperを入れます(IDA ProとHopperは商用で、REAは利用権を与えません)。私の環境の rea doctor では、Hopper、Ghidra、IDA、JADXがそろって missing_analysis_engine、判定は healthy: false でした。それでもJavaScriptの解析は動きました。
rea-agentsの入れ方と、Claude Codeでつまずく1文字
対話形式なら npx rea-agents setup を実行してエージェントを選びます。変更案を承認すると、既存の設定をバックアップしてMCPの登録とスキルの追加が行われ、最後に自分でエージェントを再起動します。Node.jsは22系なら22.19以上が必要です。
私はグローバルに入れ、対象を指定して設定しました。インストールからヘルプ表示まで、コンテナの起動とnpmの取得込みで約87秒です。
npm install --global rea-agents
rea doctor
rea setup --client claude_code --dry-run
rea setup --client claude_code --yesここで1回止まりました。--client claude-code とハイフンで書くと、Unsupported agent integration というエラーで弾かれます。正しくはアンダースコアの claude_code で、エラーに候補は出ません。Codexなら codex で通ります。
--dry-run を付けると、~/.claude.json へのMCP登録と、~/.claude/skills/reverse-engineer-anything へのスキルの追加という2件の計画が表示されます。--yes で実行したあと、~/.claude.json には次の登録が書かれていました。
{
  "mcpServers": {
    "rea": {
      "command": "/usr/local/bin/rea",
      "args": ["mcp"]
    }
  }
}
自作のメモアプリをREAで解析すると、何が返ってくるのか?
見本として、Electron風の小さなメモアプリを書きました。7ファイル、ソースは1.9KBです。main.js でIPCのチャンネル notes:search を受け、search.js にはひらがなとカタカナを同一視してタイトル一致を上に並べる検索関数を置いています。
rea analyze-javascript-application /path/to/memo-app --json解析は1.495秒で終わり、返ってきたJSONは557,236バイトでした。notes:search について、メイン側の受け口とレンダラーからの送信を1件ずつ見つけて対応づけ、受け口の位置も main.js の14行目の桁の範囲まで出ています。memo.search や contextIsolation: true、関数名の searchNotes も拾えていました。
一方で、検索の中身の説明は、CLIの結果には出てきません。仕組みを言葉にするのは、MCPでREAを呼んだエージェント側の仕事です(今回はエージェントを通さずCLIで実行)。1.9KBのソースに557KBのJSONですから、人が読む量ではありません。
REAの答えは、どこまで信じてよいのか
結果には「分からなかったこと」が101件、「限界」が7件、REA自身の手で書かれていました。例えば search.js 3〜4行目の .replace の呼び出し先は特定できない、と返しています。限界の欄には、JavaScriptとHTMLは実行せず文字として解析したこと、見つからなかったことは存在しない証明にならないことなどが並びます。
エージェントが「該当する処理は見つかりませんでした」と返しても、言えているのは「静的に読んだ範囲では見つからなかった」までです。結論を使う前に、限界の欄を読んでおくと安全です。
REAでやってよい解析と、やってはいけない解析
REAの DISCLAIMER.md は、想定する使い方と手を貸さない使い方を具体的に並べています。
あなたが解析したいアプリは、表の上の2行に入りますか? 入らないなら、REAを使う場面ではありません。
公開されているアプリでも、解析してよいとは限らない
DISCLAIMERで一番効くのは、ソフトが公開されている、ファイルを持っている、デバッグ用の接続口に入れる、というだけではあらゆる操作の許可にならない、という一文だと私は考えています。中身を調べる許可があっても、実行や通信の傍受まで許されたとは限らず、法律やライセンスを守る責任は利用者にある、という立場です。
「似た機能を作って」とREAに頼む前に
DISCLAIMERには、ソースに近い出力や解析レポートを得ても、元のプログラムや出力物への権利は生まれないと書かれています。仕組みを理解して作り直すことと、保護されたコードの再現との境目は、READMEの例だけでは判断できません。
日本の法律への当てはめはこの記事では判断しないので、業務で使うなら対象ソフトの利用規約を読み、必要に応じて法務に確認してください。
解析ではプログラムの実行や通信の記録も起こりうるため、DISCLAIMERは信頼できない対象には適切な環境を使うよう求めています。
REAを入れるなら、最初の解析は自分のアプリから
自分のアプリなら、REAの根拠をソースと見比べられます。
- 上の手順で入れて、Claude Codeを再起動する
- 自分のプロジェクトに
rea analyze-javascript-applicationをかけ、ソースと見比べる - エージェントに自分のアプリの機能を調べさせる
REAのドキュメントによると、Claude CodeをAnthropic以外の接続先で使うと172個のツール定義が毎回送られ、6.7.0の既定では約496KBです。reaの環境変数 REA_MCP_INPUT_SCHEMA_PROFILE を compact にすると約290KBに減ります。mainではcompactが既定に変わったので、更新後は要らなくなるかもしれません。
執筆時点の最新は6.7.0です。更新が速いので、ときどき rea update を実行してください。
ソースのないアプリから、根拠つきで構造を拾うところまではREAが引き受けてくれます。何を読ませてよいかを決めるのは、今も使う人の側です。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 rock80sbot
- 2
- 0
-
 むみま
- 1
- 0
-
むみま
- 2
- 0
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
コードを読まないAIエンジニア
- 4
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
- 3
- 0
-
むみま
- 7
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます