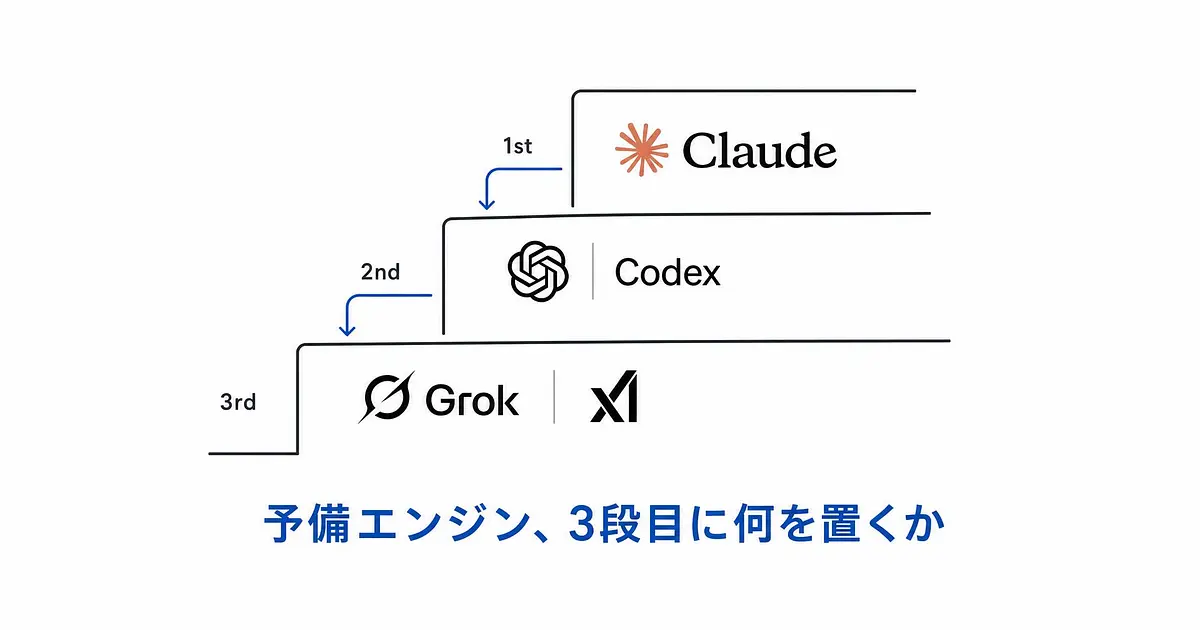
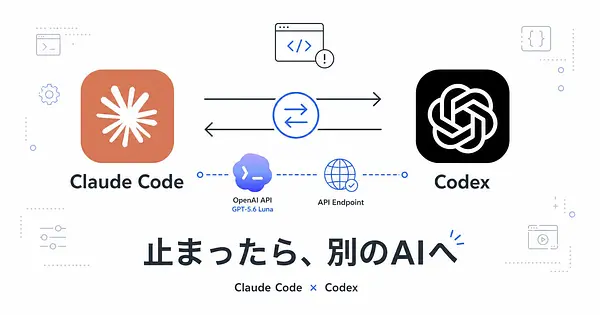
Claude Codeがレート制限に引っかかって手が止まる、あの数十分。その退避先として、私はCodex CLIとGPT-5.6 Lunaを置いています。構成を整理したばかりなのに、候補がもう1つ早々に出てきました。
出力単価が1桁ドル、コーディング系ベンチは倍近い伸び。この数字だけ見れば、予備の列に並べたくなりますよね。
予備エンジンの候補が、2つから3つに増えた
2026年9月21日、xAIがGrok 4.7を公開しました。価格は据え置きのまま、前世代のGrok 4.6から性能を引き上げたという触れ込みです。

APIとしての基本仕様は予備エンジン向きです。コンテキストウィンドウは500,000トークン、エンドポイントはOpenAI互換で、base_url は https://api.x.ai/v1。レート制限は累計課金額で決まるTier制(Tier 0から4)で、RPSとTPMの2軸を超えると429が返ります。
主力がClaude Code、止まったときの退避先がCodex CLIとLuna。この2段構えに、xAIが3段目として入ってくるのか。宣伝文に並んだ数字を1つずつ分解して、最後に判断軸だけ残します。
出力単価6ドルと50ドルを並べた表に、Lunaは入っていない
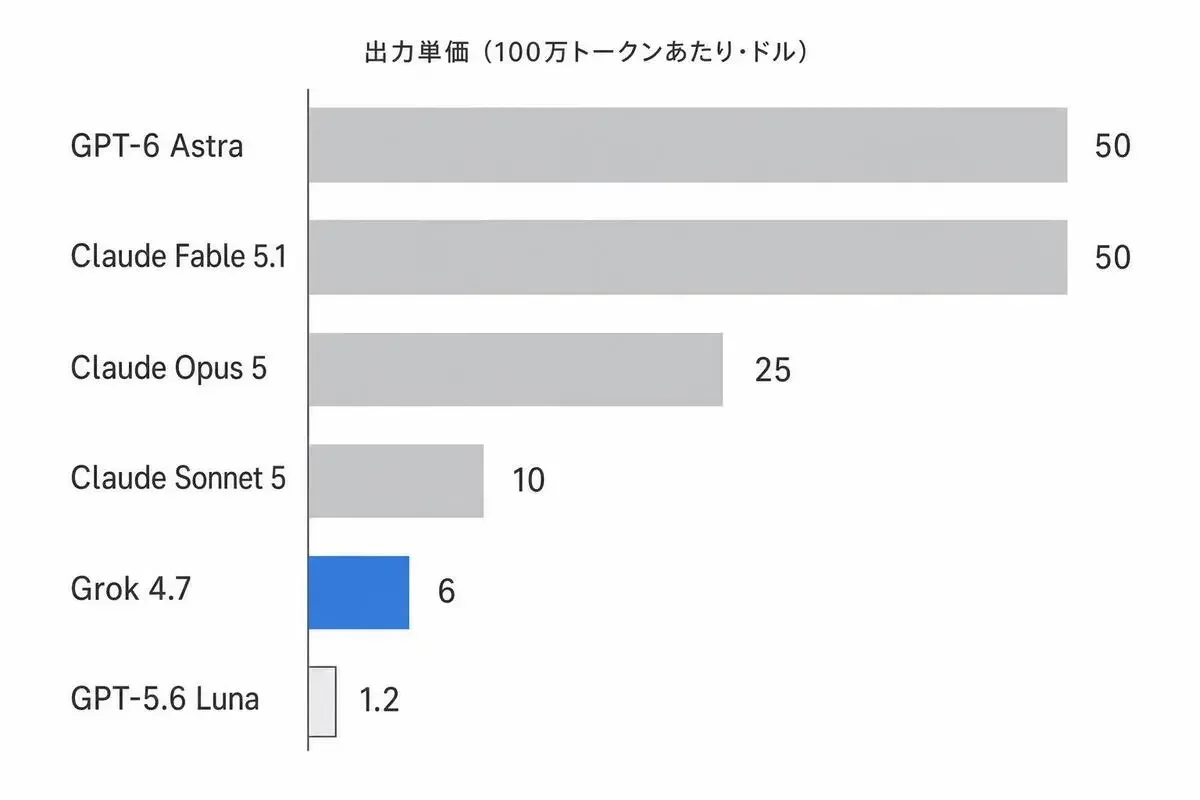
まず公式の単価から。Grok 4.7は200kトークン未満のリクエストで入力$2.00、キャッシュ入力$0.50、出力$6.00(いずれも100万トークンあたり)。200k以上になると入力$4.00、キャッシュ$1.00、出力$12.00と倍になります。低レイテンシのFast版はさらに2倍レートです。
ここに、予備エンジン候補として名前の挙がるモデルを並べてみます。
単価はいずれも100万トークンあたりで、各社の公式ページで確認できます(xAI / OpenAI / Anthropic)。
「$50に対して$6」は事実です。1ドル150円で換算すると、出力100万トークンあたり約7,500円と約900円。8分の1以下ですから、インパクトは十分あります。
ただ、比べている相手がGPT-6 AstraとClaude Fable 5.1、つまり各社の最上位モデルなんですよね。予備エンジンの席に座っているのはそこではありません。現職のLunaは出力$1.20、円にして約180円で、Grok 4.7の5分の1です。
安さを理由にGrokへ動くなら、いま自分が何と比べているのかを一度確認してください。最上位モデルと比べれば安く、予備エンジンと比べれば高い。同じ$6が、どちらにも読めます。
Terminal-Bench 4.0が20.3から38.0へ、これは誰が測った数字か
xAIが公開しているベンチマーク表を見ると、Terminal-Bench 4.0のスコアはGrok 4.6の20.3%からGrok 4.7で38.0%へ上がっています。倍近い伸びです。
伸びは確かに大きい。ただし同じ表の中で、Terminal-Bench 4.0のFable 5.1は57.9%です。Grok 4.7はGPT-5.6 Solを0.7ポイント上回った位置にいて、最上位には届いていません。そもそもGPT-6 Astraはこの表に入っていません。
もう1つ引っかかるのが計測主体です。この数字はxAIの自社計測で、第三者であるArtificial Analysisは同じTerminal-Bench 4.0について「+4.5ポイントの改善」とだけ書いています。20.3から38.0という17.7ポイントの伸びとは一致しません。
ベンチのスコアは、ハーネスや試行回数、エージェントの設定で普通に動きます。自社計測と第三者計測を同じ重みで扱わない。Grokに限らず、どのモデルの発表でも同じです。
Artificial Analysis指数では、Grokは首位ではない
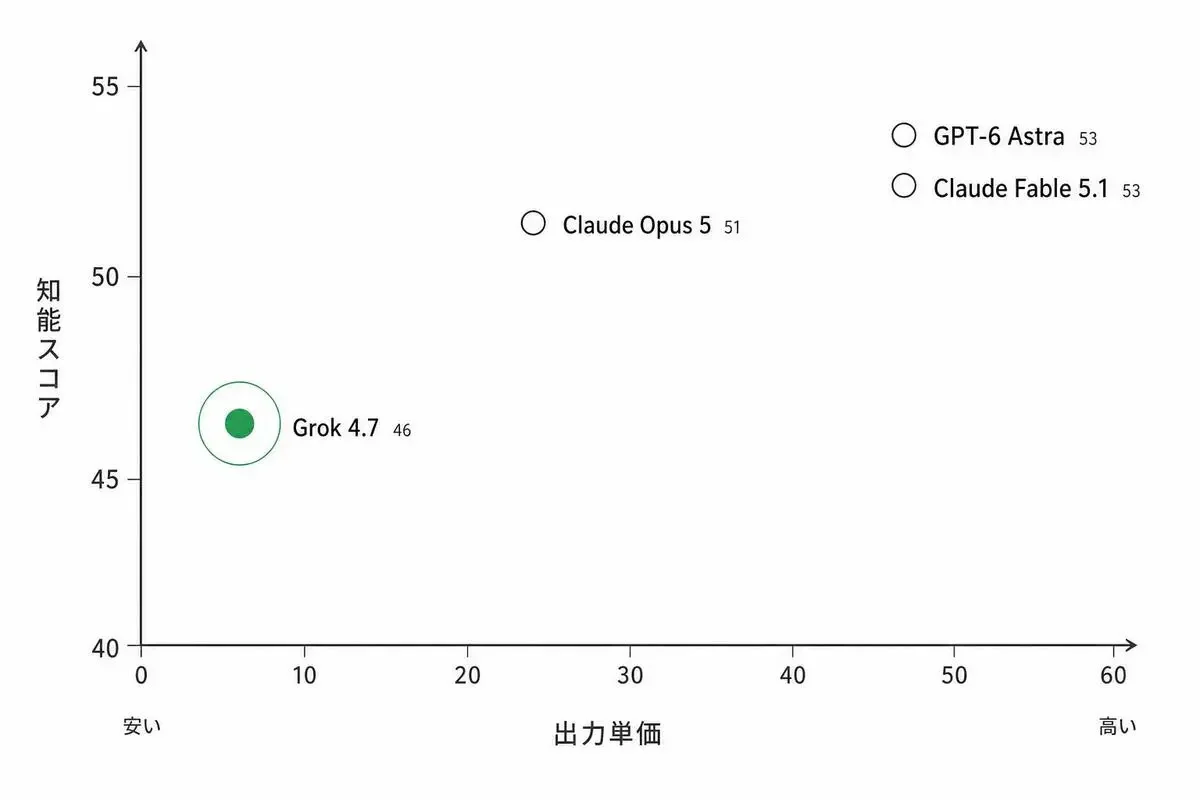
第三者の総合指標も見ておきます。
AA Intelligence IndexでGrok 4.7は46。前世代から2ポイント上がっていますが、GPT-6 AstraとClaude Fable 5.1が53で同点首位、Claude Opus 5が51なので、そこには7ポイント差があります。コーディングエージェントの実力を測るAA Coding Agent Indexでは56で4位、上にFable 5.1、GPT-6 Astra、Opus 5が並びます。
これを「じゃあダメか」と読むのは早いと思っています。
予備エンジンに求めているのは首位性能ではありません。主力が止まっている間、手を止めずに進められることです。難しい設計判断は制限が明けたClaude Codeに戻して任せればいい。「総合4位だが単価は8分の1以下」という位置は、退避先としてはむしろ噛み合っています。
主力を外す話ではなく、主力が止まったときの席を1つ増やす話。ここを混ぜないほうが判断は楽です。
Claude CodeにGrokは挿せない。経路は2つある
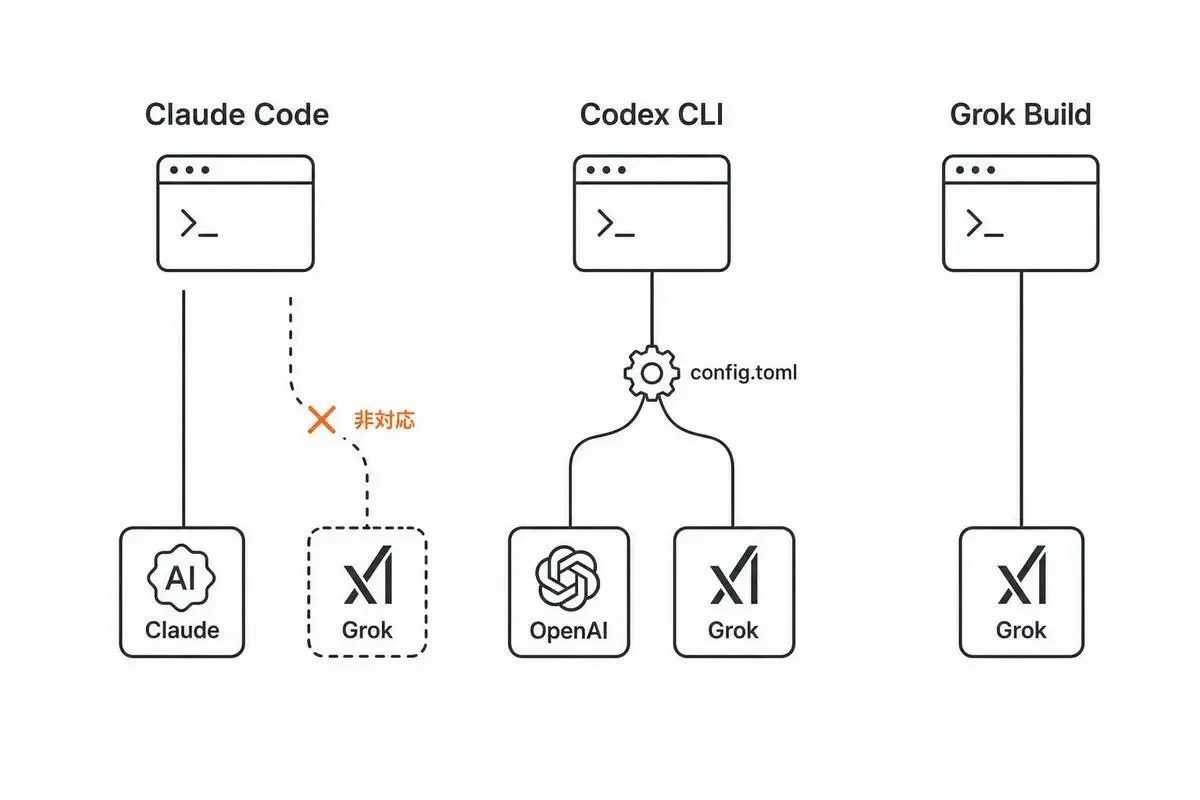
先に前提を潰しておきます。Claude Codeに他社モデルは差し込めません。Anthropicの公式ドキュメントに、いかなるゲートウェイ経由であってもClaude Codeを非Claudeモデルへルーティングすることはサポートしない、と明記されているからです。ANTHROPIC_BASE_URL が向いているのはAnthropic Messages API形式を話すゲートウェイであって、xAIのエンドポイントを入れる場所ではありません。
では、どこからGrokを動かすのか。現実的な経路は2つです。
経路1はCodex CLIです。~/.codex/config.toml に [model_providers.] を足してプロバイダを増やせます。最小構成で効いてくるキーは name / base_url / env_key / wire_api で、ほかにヘッダーやリトライ、認証まわりのキーも定義されています。openai / ollama / lmstudio はID予約済みです。公式に載っている例はMistralのものです。
[model_providers.mistral]
name = "Mistral"
base_url = "https://api.mistral.ai/v1"
env_key = "MISTRAL_API_KEY"
公式に載っているのはこのスキーマと他社の例までで、xAI向けの具体的な記述はありません。GrokのAPIはOpenAI互換なので、構造上は同じ形(base_url に https://api.x.ai/v1、env_key に XAI_API_KEY)に収まるはずです。ただしそれは公式が保証している話ではないので、自分の環境で疎通を確認してから常用に入れてください。
経路2はxAI公式のコーディングCLI、Grok Buildです。
インタラクティブなTUI、headless、ACPの3モードを持ち、サブエージェント、MCP、skills、hooksに対応しています。ライセンスはApache 2.0で、リポジトリも公開されています。コーディング特化だった grok-code-fast-1 は2026年8月15日で提供終了し、後継は grok-build-0.1(コンテキスト256k、200k未満で入力$1.00 / キャッシュ$0.20 / 出力$2.00)です。
どちらを選ぶか
既存の資産を使い回したいならCodex CLIです。AGENTS.md を入口にプロジェクトのルールを読ませる構成をすでに作ってあるなら、プロバイダを1つ足すだけで済みます。
xAIが想定している使い方でGrokの挙動そのものを見たいならGrok Buildが素直ですが、新しいCLIの作法を覚える分、退避先としての立ち上がりは遅くなります。
予備エンジンを増やす前に、公式の従量課金枠を見る
予備エンジンを増やす前に、Anthropic公式の逃げ道を使い切っているでしょうか。
Claude Codeのレート制限は、ローリング5時間ウィンドウと週次ウィンドウの2本立てで、しかもClaude本体のチャットと同じ枠を共有します。モデル別の上限(Opus limitなど)はモデルを切り替えれば回避できますが、セッション上限と週次上限は全モデル共通なので切替では逃げられません。
その上で、有料プランには公式の従量課金フォールバックとしてUsage credits(extra usage)があります。CLIで /usage-credits を実行すると残高と当月の支出が見られて、月次の上限も設定できます。APIキーでログインしている場合は使えません。
代償が1つあって、usage credits利用中はプロンプトキャッシュのTTLが1時間から5分に落ちます。同じコンテキストを繰り返し読ませる使い方だと、キャッシュヒットが外れて入力コストが上振れしやすい。知らずに使っていると、請求額を見て初めて気づくやつです。
それでも、予備エンジンを1つ増やせば、APIキーも課金アカウントも疎通確認もCLI固有の設定ファイルも増えます。月に数回の制限のために、この一式を3セット抱える価値があるのか。公式枠で足りるなら、そちらのほうが運用は軽い。
まとめ
Grok 4.7で変わったのは、予備エンジンの候補が実際に1つ増えたことです。出力$6で500kコンテキスト、OpenAI互換API、公式CLIつき。退避先として検討に値する条件は揃っています。
変わっていないのは、単価の最安が依然としてLunaで、総合力の首位がGrokではないことです。「$50に対して$6」という比較は、予備エンジンを選ぶ文脈では相手が違います。
私の結論はこうです。主力はClaude Codeのまま、1段目の逃げ道は公式のusage credits、2段目がCodex CLIとLuna。Grokは3段目に置いて、量をさばく定型作業を外に出したいときに使う。
そして、いざ止まってから設定を始めないこと。平常時に疎通だけ通してAPIキーと最小の設定を置いておく方針は、予備が3つになっても変わりません。
参考リンク
- 4
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 nikutama
- 3
- 0
-
 ハル
- 1
- 0
-
AI脱社畜
- 5
- 0
-
 タツヤ
- 4
- 1
-
 もえ@丁寧な生活
- 3
- 0
-
 黒板とAI@直人
- 4
- 0
-
 ゆず
- 6
- 0
-
黒板とAI@直人
- 5
- 0
-
- 5
- 0
-
 gen
- 6
- 0
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
- 3
- 0
-
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
黒板とAI@直人
- 6
- 0
-
- 5
- 1
-
- 5
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます