コーディングエージェントに「セキュリティ的に危ないところを洗って」と投げると、それっぽい指摘が大量に返ってきます。読むと半分以上は実害のない話で、結局どれが本物かを人間が選別する時間が発生する。Cloudflareが公開した監査Skillは、この選別コストを検出精度ではなく役割分担の設計で潰しにきています。
MITライセンス、2026年6月18日公開。3か月で19,700スターを超えていて、Cloudflare社内の脆弱性探索ハーネスの種になったスキルがそのまま出てきた格好です。
6段階に分かれているのは、分業のためです
やることは6つのフェーズに分かれています。
- Reconnaissance。信頼境界と入力表面を
architecture.mdとcoverage-ledger.jsonに書き出す - Coverage-led hunting waves。台帳の探索ユニットを隔離された hunter に割り当てる
- Candidate validation。候補を fingerprint で束ね直し、新しく立てた検証者に渡す
- Structured output。
findings.jsonに書き、report-schema.jsonで機械検証する - Independent record verification。別のフレッシュなエージェントが主張とソースの対応を検証する
- Target-neutral report。
REPORT.mdなどのレポートを生成する
フェーズ名だけ並べると、よくある多段パイプラインに見えます。効いているのは段数ではなく、2と3と5でエージェントの人格が切り替わっていることです。
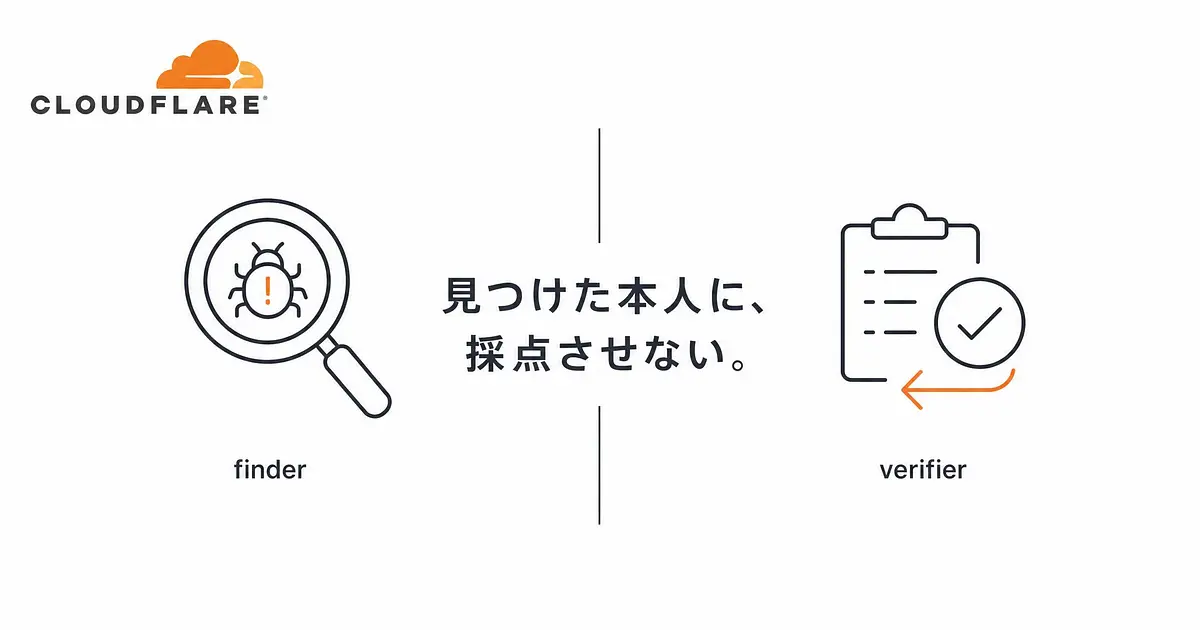
見つけたエージェントに、severityを付けさせない
Phase 2 の hunter は候補を見つけることだけが仕事で、深刻度を確定させる権限を持ちません。採点するのは Phase 3 の fresh verifier、発見に一切関与していない別のエージェントです。しかも役割は「確認する」ではなく「反証を試みる」。
なぜここまで人格を分けるのか。4,000トークン使って「このコードは危険だ」と論証したモデルは、続けて「本当に危険か確認して」と言われても自分の結論に同意しやすい状態になっているからです。同じ文脈を持ったまま検算させても、検算になりません。
SKILL.md のアンチパターン一覧にも、この設計を守る禁止事項が並びます。needs_validation のレコードに severity を付けること。独立検証の前にレポートを書くこと。ソースに存在しないプロキシやデプロイ環境の挙動を推測すること。AIが空欄を推測で埋めたがる前提に立って、埋めさせない場所を先に決めているわけです。
Cloudflareは社内版でこれをモデル単位までやっていて、発見側と検証側で完全に別のモデルを使っています。まったく異なる論理的重みと学習データによって評価される状態を作るため、というのが公式ブログの説明です。
confirmed、needs_validation、rejected。必須フィールドが揃っていない
3つの判定は同じ形のレコードなのか。違います。report-schema.json を読むと、必須フィールドが判定ごとに変わります。
verdict、fingerprint、title、description、trace、evidence は3判定とも共通で必須です。
confirmed だけが root_cause を名乗れて、それ以外は claimed_root_cause になる。主張と確認済みの事実が、フィールド名のレベルで区別されています。
そして confirmed だけが execution を持ちます。中身は attacker_perspective、payloads、instructions、observed_result の4つが必須。攻撃者視点でこう動かしたらこう観測された、まで書けないレコードは仕様上 confirmed になれません。
逆に needs_validation には blockers と validation_plan が必須です。何が確認を止めているのか、ローカルとデプロイ環境でそれぞれどう確かめるのか。判断を保留するために、保留の理由を構造化して要求しています。
全判定で必須の trace は、各要素が kind に entrypoint、propagation、sink のいずれかを取ります。入口から伝播、着弾点まで、ファイルと行番号で追えない指摘は最初から書けない構造です。severity も単一スコアではなく、likelihood と impact をそれぞれ score と reason のペアで持ってから overall_severity を出す。分かれ目として明記されているのは、セキュリティ制御を完全に突破したのか、弱めただけなのかです。
fingerprint は ^[A-Za-z0-9][A-Za-z0-9._:/@+-]*$ に従う安定識別子で、判定が confirmed から rejected に変わっても値を変えません。別の hunter から同じ脆弱性が二重に上がったときの名寄せキーであり、再実行をまたいだ追跡キーでもあります。
再実行するたびに、前回どこを見ていないかを覚えている
複数回の実行は加算的、と明記されています。前回の coverage-ledger.json と findings.json を読んで、見ていない場所から再開する。
では前回 confirmed だったレコードはどう扱われるのか。ソースと条件が変わっておらず、証拠が現在の契約を満たす場合に限って引き継がれます。ソースが動いていれば confirmed だった事実は効力を失い、再検証ユニットとして現在の仕事に戻ってくる。前回OKだったから今回もOK、という横着ができない設計です。
実行プロファイルは quick、standard、deep の3段階。budget を設定したときの挙動が正直で良いと思いました。偵察と検証用の予備を確保できない予算しか渡されなかったとき、このSkillは hunter を起動せず、run_status を incomplete にして止まります。半端な予算で走らせて、検証されていない候補を並べるほうが有害だという判断です。
そもそも1回で全部見つかる前提に立っていません。READMEには、テスト実行では1回の run で見つかったのは繰り返し実行で最終的に見つかった脆弱性のおよそ半分だった、と書かれています。
却下率40%から11%へ。社内では何が起きたか
この設計がどこまで伸びるのかは、Cloudflareの公式ブログの数字を見ると分かります。
社内のハーネスは128リポジトリを走査し、検証システム側には145リポジトリ分、13,841件の知見が集まっています。発見側が出した候補は20,799件、検証を通過したのが12,057件。そこから重複や対象リポジトリ違いを落として、エンジニアリングチームに届いた実行可能な知見が7,245件です。
検証プロセスを改善する過程で、初期に40%あった却下率は11%まで下がり、質の高い知見の割合は35%から58%に上がりました。ここまで約6週間。
ただし公開されているOSS版は、単一リポジトリを1セッションで回す基礎版です。クロスリポジトリの永続化もフリート規模の重複排除も入っていません。この数字はOSS版の性能ではなく、この設計を伸ばすとここまで行った、という到達点として読むのが正しいと思います。
「監査して」と言わない限り、6段階は回らない
誤解されやすい点が1つあります。このSkillを入れたら毎回6フェーズが走るわけではありません。
既定は guidance mode で、セキュリティの質問、部分的なレビュー、手法の相談、個別の指摘のトリアージに使われます。ファイルも作らず、ワークフローも完走しない。full audit mode に入るのは、監査やペネトレーションテストを明示的に依頼したとき、包括的なレビューやレポート成果物を求めたときだけです。
この区別は実務で効くのか。効きます。Hacker Newsのスレッド(211ポイント、コメント32件)には、費用対効果への不満が並んでいます。小規模な FastAPI プロジェクトで150kトークン使ったという報告、中規模のコードベースに1Mトークン投げて何も出なかったという報告。150kトークンはモデルが鈍り始めるゾーンだ、というコメントもありました。日常のレビューは guidance mode で済ませて、リリース前にフル監査を回す。この使い分けが現実的です。
もう1つ、サンドボックスの前提も無視できません。外部ネットワーク遮断、許可リストのみの空の環境変数、読み取り専用の対象コード、書き込みは scratch/ だけ。これを満たす環境がないと動かして観測する工程が成立せず、指摘は confirmed に到達せず needs_validation で止まります。
自分のレビューSkillに移せるのは、この3つ
セキュリティ監査をしない人にも、この設計から持ち帰れるものはあります。私が自分のレビュー用Skillに移すなら、この3つです。
- 発見者と検証者を別セッションに分ける。同じ文脈を持ったエージェントに自己採点させない。検証側への指示は「確認して」ではなく「反証して」にする
- 未確定の指摘に重要度を付けさせない。代わりに「何が確認を止めているか」と「どうすれば確認できるか」を必須項目にする。これだけで、それっぽいだけの指摘がレポートから消えます
- 見た場所と見ていない場所を台帳に残して、次の実行はそこから再開する。レビューを1回で終わらせようとしないほうが、拾える量は増えます
AIに何かを評価させる場面は、セキュリティ監査に限らず増えています。そこで精度を上げようとすると、より賢いモデルやより長いプロンプトに手が伸びがちです。
このSkillが示しているのは別のレバーです。誰に採点権を渡すかを設計で決めてしまえば、モデルを変えなくても出力は変わります。まず report-schema.json を開いて、confirmed と needs_validation の必須フィールドの差だけ見てみてください。自分のレビュー用プロンプトに足りないものが、たぶんそこに書いてあります。
- 4
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 AI経営者の参謀@ひで
- 4
- 0
-
コードを読まないAIエンジニア
- 4
- 0
-
 ハル
- 1
- 0
-
- 3
- 0
-
 gen
- 2
- 0
-
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
- 5
- 1
-
- 5
- 0
-
AI脱社畜
- 5
- 0
-
gen
- 1
- 0
-
- 2
- 0
-
- 3
- 0
-
 キャリア迷子@そら
- 2
- 0
-
クロージング師匠
- 1
- 0
-
gen
- 4
- 0
-
 カイ@プロダクトマネージャー
- 5
- 0
-
- 4
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます