Claude Codeでサブエージェントを役割ごとに作っていくと、気づけば .claude/agents/ がファイルだらけになっています。Anthropicの答えは「全部やめろ」ではなく、多くをメインの1つのループにまとめ、3つの条件に当てはまるものだけ残す、です。1つのループとは、メインのエージェント1本がツールを呼び、結果を読み、次の手を決める、を繰り返す形のことです。
Pythonライブラリのコードを読んで表を作る同じ調査を、3つのサブエージェントに分けた場合と1つのループで比べると、分けたほうが約30秒遅く、時間は1.24倍、トークンは2.9倍かかりました。分けた側には3つの報告を表にするまとめ役を置きましたが、担当が見つけた細部が1行、そこで消えました。後半では、Anthropicの3つの条件を自分のサブエージェントに当てはめる表と、メインに戻す手順まで扱います。
あなたの .claude/agents/ には、いまいくつのエージェントが入っていますか? 増やしすぎたかもと思い当たるなら、まず数を控えておいてください。後半の仕分け表で使えます。
サブエージェントを増やすと、何が起きるのか?
受け渡しのたびに、情報が落ちる
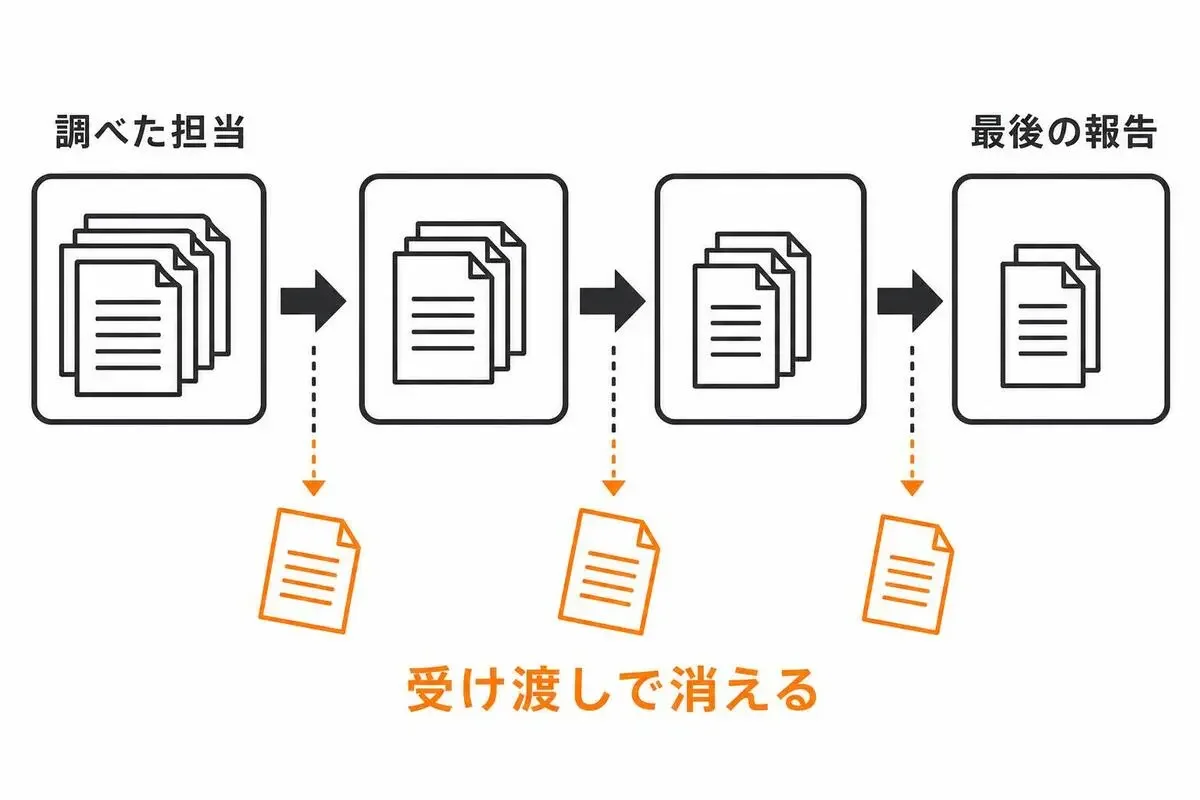
Anthropicのダイアン・サーキスさん(Diane Sarkis)が2026年10月22日に公開した元記事は、企業のエージェントで見えた失敗の型を5つ挙げています。いちばん身近なのが受け渡しです。エージェント同士で何を渡すかを決めなければならず、やり取りの途中で細部が落ちます。受け取る側は元の資料を見ていないので、落としたことに気づけないことが多いんですよね。
遅さも型の1つで、ある企業の例では、1つのループのほうが自社のマルチエージェント構成より約2倍速く動いたそうです。
乱立と、各チームが継ぎ足したシステムプロンプト
残りの3つは組織の中で起きます。チームごとにサブエージェントを出すと、役割の重なるものが何百もでき、共通の基準も持ち主もなくなります。
システムプロンプトは、各チームが1文ずつ足した結果、ルールが食い違い口調もそろわなくなります。Anthropicはこれをつぎはぎのプロンプト(Frankenprompt)と呼んでいます。評価も各チームが自分の担当だけに合わせるので、全体を見る人がいません。
代わりに勧められているのは、1つのモデルが1つのコンテキストでツールを呼び、結果を読み、計画を直す、を繰り返すループです。Skillsを持たせた1つのエージェントのほうが、品質でもコストでも上回ることが多かったそうです。本当にそうなるのか、手元で比べてみました。
同じ調査を、サブエージェントに分けた場合と1つのループで比べた
課題と条件
題材は、.env ファイルを読み込むPythonのライブラリ、python-dotenvです。ソースが約1,200行、テストが約2,700行です。
頼んだのは、公開関数 load_dotenv と dotenv_values の引数、既定値、内部で効く場所、その引数を渡しているテストを表にし、テストされていない引数と2つの関数の違いを書く調査です。コードは読むだけにしました。
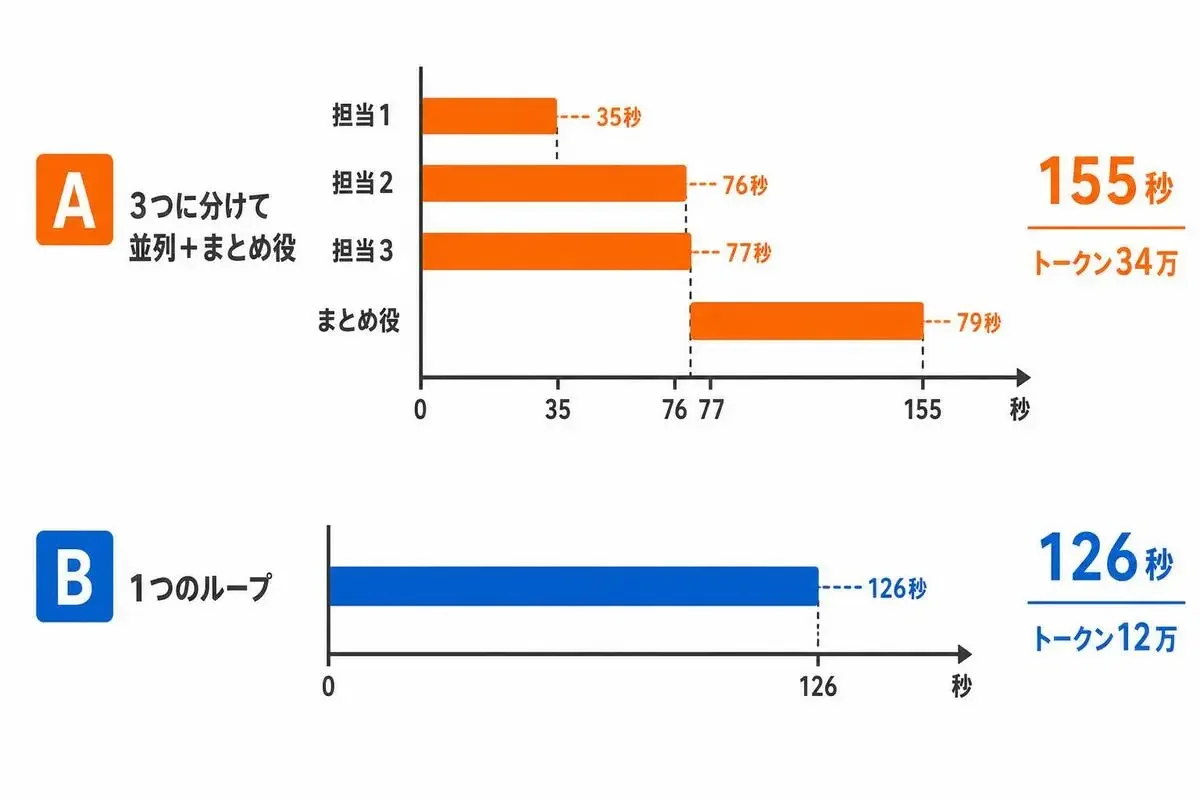
条件Aは3つに分けて並列に走らせ、担当1が引数と既定値、担当2が効く場所、担当3がテストを調べます。終わったら、報告だけを読んでソースは読まないまとめ役に統合させました。まとめ役への指示は、3つの報告から同じ表を作る、というものだけで、残す項目は指定していません。条件Bは、同じ依頼を1つのエージェントにそのまま渡しています。
どちらもClaude Codeのサブエージェントで、モデルは親と同じです。採点用に、先にコードを読んで正解を7項目作っておきました。
時間は1.24倍、トークンは2.9倍
「並列に走らせたほうが速いのでは?」って思いますよね。結果は逆で、1つのループのほうが30秒早く終わりました。担当1は35.4秒で終わったのに、いちばん遅い担当3の76.9秒を待たないと統合が始まらず、その統合にさらに78.6秒かかっています。
トークンの内訳は、担当3つで約26万4,000、まとめ役で約7万8,000です。担当がそれぞれ同じ main.py を読み直していたことが、増えた主な理由だと見ています。
まとめ役の段階で消えた1行
中心の結論は、AもBも正しく書けていました。dotenv_values は内部で override=True に固定され、それが ${VAR} の展開の優先順にも効くこと、テストで渡されていない引数が4つあることです。
Aで落ちたのは、内部の DotEnv クラスでは encoding の既定がNoneで、公開関数の2つが "utf-8" を渡している、という1行です。担当1の報告には書いてあったのに、まとめ役の表からは消えていました。
Bは2つの関数の違いを、確かめているテストの行まで挙げて裏付けていました。
load_dotenv(既定): os.environ が優先。環境にa=c、ファイルがa=b/d=${a}ならd=c(test_main.py:797-803 で確認済み)。
dotenv_values: ファイル内の値が優先。環境にb=c、ファイルがb=d/a=${b}ならa=d(test_main.py:910 で確認済み)。
今回の設計では、まとめ役はテストを読めないので、この裏付けは書きようがありません。Bは引数もテストも同じコンテキストで見ていたので、振る舞いとテストを結びつけて書けました。
7項目中6と7の1問差は、誤差にも見えます。ただ、落ちたのは担当がちゃんと見つけていた事実で、調べる段階ではなく渡す段階で落ちています。まとめ役への指示しだいで防げた可能性もありますが、受け渡しの失敗と同じ形のことが、1,200行の小さな課題でも1回は起きました。
それでもサブエージェントを残す3つの条件
残してよい場面として挙げられているのは、次の3つです。
- 1つのループのままだと、コンテキストが膨らんで性能が落ち、その低下が測れる
- 複数の作業を、終わったら捨てられる新しいコンテキストで並列に進める必要がある
- 1つのエージェントが適切なツールを選べない、またはシステムプロンプトの指示が食い違う
今回の調査も条件2に近い作業でしたが、分けた得は時間にも正しさにも出ませんでした。並列にできるだけでは残す理由として弱く、担当の結果どうしをつなぐ必要がない作業かまで見たほうがいい、と私は考えています(つなぐ必要のない作業では、まだ比べていません)。
3つの条件を、自分のサブエージェントに当てはめる表
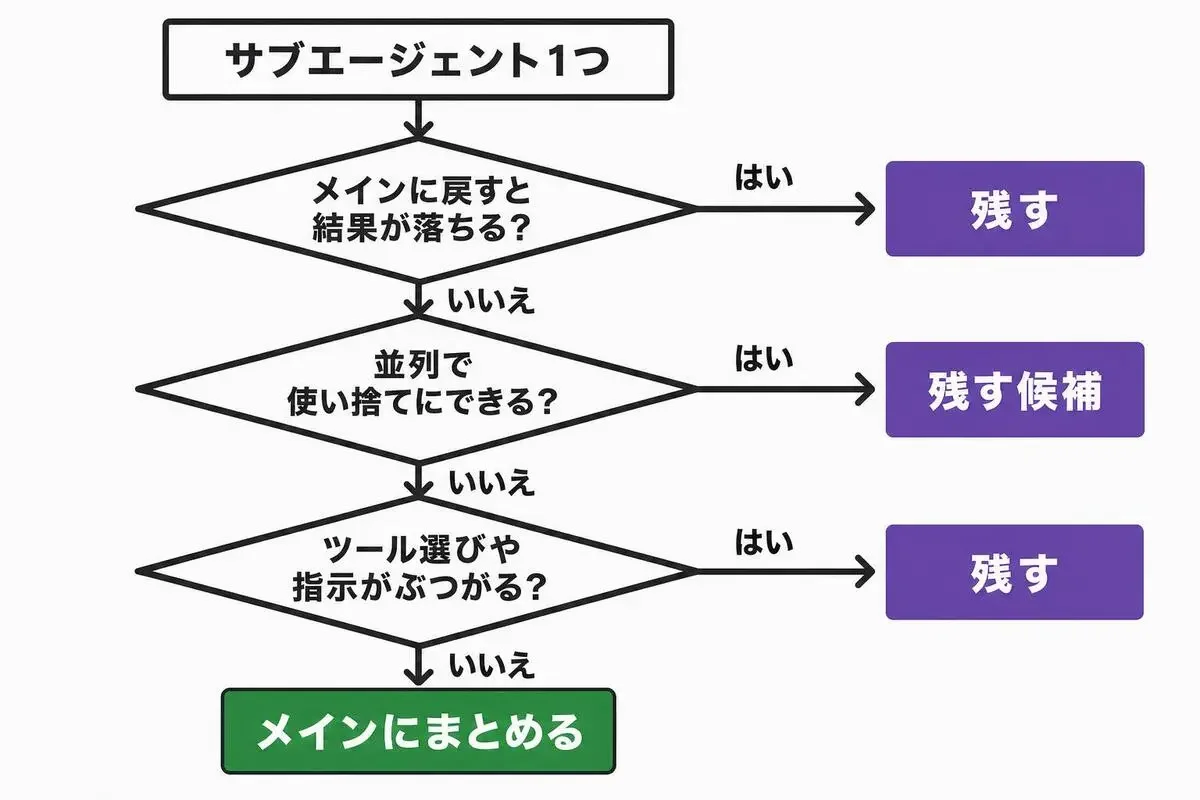
.claude/agents/ のファイルを1つずつ開き、指示文を読みながら次の3つに答えてください。
問い2を「残す候補」にしたのは私の判断です。Anthropicは条件を満たせば残すとしていますが、今回の比較では、並列にできるかだけでは決めきれないと思いました。3つとも「いいえ」なら、まとめる候補です。
その「はい」は、数字で確かめた答えでしょうか? 問い1に数字がないものは、迷ったらまとめる候補に入れ、次の評価で確かめます。迷うものが1つでも見つかれば、それが最初の1件です。
サブエージェントをまとめる前に、答えの分かっている依頼を用意する
いつもの依頼10件で、まとめる前後の答えを比べる
まとめる前に、最初から最後までを通して採点する共有の評価セットを用意し、中央の1チームが持つよう勧められています。正解が10例あれば始めるには十分だそうです。
個人なら、いつも頼む依頼を10件選び、期待する答えを書いておけば足ります。今回も正解の7項目を先に作っていたから、Aが落とした1行に気づけました。
1つずつ戻して、同じ評価で比べる
サブエージェントの指示文はSkillに、APIの呼び出しはMCPのツールに変えて、1つずつメインに取り込む形が示されています。Claude Codeなら、.claude/agents/ の指示文を .claude/skills/ のSkillへ移すイメージです。ただし、agentsの tools や model による制限は、Skillにそのまま効くわけではありません。
1つ戻すたびに同じ評価セットを流し、合計点だけでなく、どの項目が増えてどれが減ったかを見ます。
メインのツールが増えたら、必要なときだけ読み込ませる
まとめていくと、メインに載るツールが増えます。システムプロンプトのツール定義が30〜50を超えると、ツール選びの精度が落ちやすくなるそうです。
対策は、要るときに読み込むことです。手順はSkillに置いて使う場面で読み、MCPのツールはツール検索で後から読み込みます。Anthropicはこのやり方で、より高性能なモデル向けのClaude Codeのシステムプロンプトを80%以上減らしたそうです。
移行用には、評価しながら1つのループへ移す手順をまとめたMigration Kitが公開されています。参考実装という位置づけで、保守や貢献の受け付けはしていません。
Claude APIで作るアプリ向けには、次のSkillも紹介されています。
/claude-api build-eval共有の評価セットを作る/claude-api prompt-audit古くなった指示を洗い出す/claude-api hillclimb評価セットに対して繰り返し改善する/claude-api cost-optimize呼び出しを計測し、コストを下げる案を出す
このサブエージェント比較を、自分の環境に当てはめる前の注意
今回の比較は各条件1回ずつで、平均ではありません。1.24倍と2.9倍は目安として読んでください。
試したのはClaude Codeのサブエージェントで、Agent SDKや本番のエージェントではありません。Anthropicの記事にある約2倍は企業の本番環境での事例で、今回とは条件が違います。また、この環境ではBと担当3がGlob/Grepを使えず、テストのファイル名を推測して1つずつ開いていました。ツール呼び出しが増えた一因ですが、正しさには影響していません。
今回の比較からは、分けて得をするのは結果どうしをつなぐ必要のない作業ではないか、と考えています(そちらは今回試していません)。.claude/agents/ の中から、ほかのエージェントの結果と組み合わせて使っているものを1つ選び、いつもの依頼を1件、今の版とメインに戻した版で流してみてください。担当が見つけたことが最後の報告に残っているか、それだけでも確かめられます。
- 6
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ
-
 rock80sbot
- 2
- 0
-
 むみま
- 1
- 0
-
むみま
- 2
- 0
-
 bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
コードを読まないAIエンジニア
- 4
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
- 3
- 0
-
 コバ
- 3
- 0
-
むみま
- 7
- 0
-
bokuwalily
- 2
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 0
- 0
-
bokuwalily
- 1
- 0
-
bokuwalily
- 0
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます