
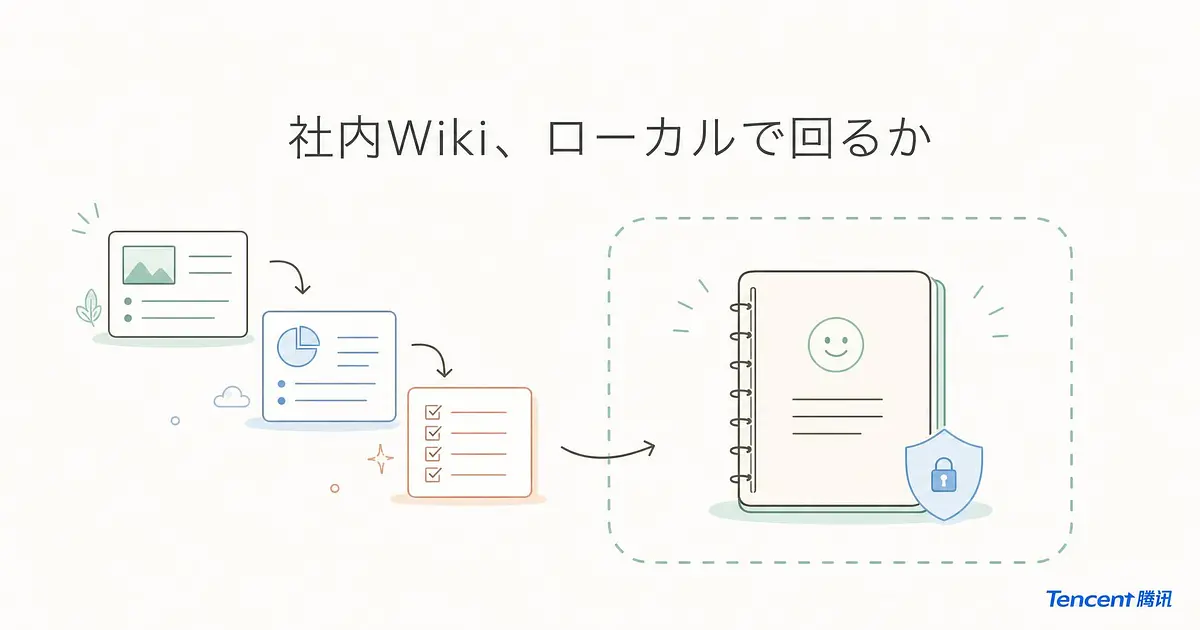
社内ドキュメントをAIに書かせる系のツール、最後はだいたい「設計書とコードを外部APIに投げます」で終わりますよね。
TencentのOSSが1週間で5千近くスターを積んでいて、今見たら累計27,793。
WeKnoraという知識基盤で、RAGのQ&Aと自律エージェントに加えて、エージェントがMarkdownのWikiを自分で書いて更新し続ける「Wikiモード」を積んでいます。
外に出さずに回せる構成になっているのか、公式の docker-compose.yml と .env.example まで降りて読みました。
「RAGじゃなくてWikiを吐く」とはどういうことか
普通のRAGは聞かれたときだけ動きます。
質問が来る、近いチャンクを引っ張る、答える。
それで終わりなので、社内には人間が読める形のドキュメントが1行も残りません。
Wikiモードはここが逆です。
READMEの表現だと、生のドキュメント群から構造化された相互リンク付きのMarkdown Wikiページをエージェントが自動生成する。
しかも成果物はブラウザ上で手で直せて、ページの改訂履歴、行単位のdiff、ワンクリックのロールバックまで付いています。
生成物がGitのリポジトリみたいに扱われる、と言えば伝わるでしょうか。
AIが書いた文を人が直して、次にAIが更新をかけたときに差分で確認できる。
「AIが勝手に社内Wikiを書き換えていた」が怖くて自動化に踏み切れなかった部分を、ここで潰しにきています。
ローカルに閉じられるかは、どこを見れば分かるのか
READMEの「Ollama対応」という一行を信じるのが一番危ないです。
推論だけローカルで、埋め込みは外部APIに投げる構成もそう書けてしまうからです。
じゃあ何を見るか。LLMプロバイダの一覧と、埋め込みプロバイダの一覧が、両方ともローカル経路を持っているかどうかです。
WeKnoraはLLM側に17のプロバイダが並んでいて、手元で完結できるのはOllamaとLiteLLM経由の2本。
埋め込み側はOllama / BGE / GTE / Zhipu / OpenAI互換APIの5つで、前の3つはローカルで動かせます。
.env.example を開くと LLM_PROVIDER LLM_BASE_URL と EMBEDDING_PROVIDER EMBEDDING_BASE_URL が完全に独立して用意されています。
別々に向き先を指定できる、つまり両方をOllamaに寄せる構成が最初から想定されている。
ここまで確認できて初めて「閉じられる」と言っていいです。
ただし LLM_PROVIDER と EMBEDDING_PROVIDER の既定値はどちらも openai です。
何も書き換えずに起動したら普通に外へ出ていくので、ここは必ず両方いじってください。
Ollamaはコンテナの中にいません
ここが罠になります。docker-compose.yml にOllamaのサービス定義はありません。
代わりに extra_hosts で host.docker.internal が張られていて、コンテナから 11434 番ポートに外向きで繋ぎにいく作りになっています。
つまりOllamaはホスト側で自分で立てておく必要があります。docker compose up -d だけ叩いて「Ollamaが起動しない」と首をかしげるのは丸ごと無駄な時間なので、先に Ollama を入れて、使うモデルをpullしてから上げてください。
接続先の OLLAMA_BASE_URL は最初から http://host.docker.internal:11434 が入っているので、そこは触らなくて大丈夫です。
ベクタDBも何も考えなくていいです。
RETRIEVE_DRIVER の既定値が postgres で、compose定義では paradedb/paradedb:v0.22.6-pg17 のイメージが指定されています。
READMEの表記は「PostgreSQL (pgvector)」なので、pgvector系の検索がそのまま乗る構成です。
Milvusなど全部で8種類から選べますが、最初に触る段階で差し替える理由はないです。
外に出る経路が1本だけ残る
compose定義を上から読んでいて引っかかったのが SearXNG です。
Web検索プロバイダとしてサービス定義に入っています。
SearXNG自体は自分で立てるメタ検索エンジンなので、名前だけ見るとローカル側に見えます。
でも役割は外部の検索エンジンに問い合わせて結果を束ねること。
Web検索機能を有効にした瞬間、クエリは外に出ます。
完全に閉じたいなら、ここを使わない判断が要ります。
ナレッジグラフ用のNeo4jも、トレース用のLangfuseも自己ホストなので外には出ません。
「ローカルLLMだから安全」ではなく「どの機能がネットワークを叩くか」で見る。
これは自己ホスト型のAIツール全般に効く読み方です。
実際に組んだら、まずここを切った状態で通信を眺めてみてください。
Obsidianの断片メモを渡すとどうなるか
一番気になるのがここだと思います。
対応ドキュメント形式は13種類あって、PDFやWordはもちろんMarkdownも当然入っています。
手元のVaultをそのまま流し込みたくなりますよね。
ただ注意があって、対応形式に書いてあるのは「Markdown」であって「Obsidian Vault」ではありません。
[[wikilink]] 記法やYAML frontmatterをどう解釈するかはドキュメントに明記がない。
Wikiモードはページ間の相互リンクをエージェントが自分で張り直す設計なので、元のリンク構造は引き継がれる前提で考えない方が安全です。
試すなら、いきなり全量ではなく同じ話題のノートを10枚くらい選んで、リンクがどう張り直されるかを先に見るのが安全側です。
逆に言うと、リンクが綺麗に整った資産より、断片メモの束みたいな状態の方が向いています。
日付ごとのデイリーノートが100枚あって、同じ話題が5箇所に散らばっていて、人間が読み返しても再構成する気が起きないやつ。
それを主題ごとのページに束ね直すのがWikiモードの仕事なので、散らかっているほど差分が出るはずです。
ローカル完結で捨てることになるもの
正直に書きます。Ollamaで現実的に回る7Bから14Bクラスのモデルと、クラウドの大型モデルでは、長い文書を横断して構造を起こす力に差があります。
Wikiモードは複数の文書をまたいで見出し構成そのものを決める作業なので、この差がページの質に直撃するはずです。
もう1点が時間です。埋め込みの生成量は文書数にそのまま比例するので、数百枚のVaultを一気に流すと手元のGPU次第では寝て待つ作業になります。
ここは環境差が大きいので、最初は10枚単位で流して所要時間を測ってから全量に進んでください。
なので現実的な落としどころは、まず全部ローカルで組んで、質が足りないと感じたら埋め込みだけローカルに残して推論側をLiteLLM経由に切り替える形です。LLM_PROVIDER と EMBEDDING_PROVIDER が別キーで分かれているのは、この段階的な妥協ができるようにするためだと思っています。
文書の中身をまるごと投げるのは埋め込み側なので、そこをローカルに残せる意味は大きいです。
触りはじめの最短ルート
DockerとOllamaが入っていれば、READMEに載っている起動手順は4行です。
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
cp .env.example .env
docker compose pull && docker compose up -d
http://localhost を開くと管理画面が出ます。
その前にホスト側でOllamaを起動して使うモデルをpullしておき、.env の LLM_PROVIDER と EMBEDDING_PROVIDER を両方ともOllamaに向ける。
ここが唯一の山で、あとはドキュメントを放り込むだけです。
ライセンスはMITです。LICENSEファイルの冒頭に「Copyright (C) 2025 Tencent」とMITの条文が入っています。
GitHubのAPI上は NOASSERTION と出るので身構えますが、これは同梱依存ライブラリのライセンス表記がまとめて同じファイルに入っているせいで、本体はMITで問題ありません。
社内で稟議を通すときはここが一番効く材料になります。
最初の問いに戻ると、公式の設定ファイルを読む限り、Web検索を切って2つのプロバイダをOllamaに向ければ外に出る経路は残りません。
あとは自分の環境で通信を眺めながら確かめる話です。
手元のVaultを試しに10枚食わせるところからやってみてください。
- 2
- 0
Claude Code / Cursor / Codex を毎日触る若手Webエンジニア。新ツールの実況・比較・アンチパターンを深夜テンションで書きます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 gen
- 6
- 0
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
- 2
- 0
-
AI脱社畜
- 3
- 0
-
 キャリア迷子@そら
- 2
- 0
-
クロージング師匠
- 1
- 0
-
 カイ@プロダクトマネージャー
- 5
- 0
-
- 4
- 0
-
- 3
- 0
-
gen
- 1
- 0
-
 たく
- 2
- 0
-
- 3
- 0
-
- 4
- 0
-
 タツヤ
- 2
- 0
-
- 2
- 0
-
- 3
- 0
-
- 3
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます