
OpenAIが自社の新モデルGPT-6 Astraに、初めて「Critical」というサイバー脅威の区分を付けました。
性能自慢ではなく、危険度の宣言として出てきた発表です。
同じ日に「AGIの到来」という言葉も並び、英語圏の見出しはほぼそちらで揃っていますが、発表の中身を1つずつ確かめると、本当に変わった部分と言葉だけが強い部分ははっきり分かれます。
「Critical」は、人間の指示なしにゼロデイを見つけられる水準を指します
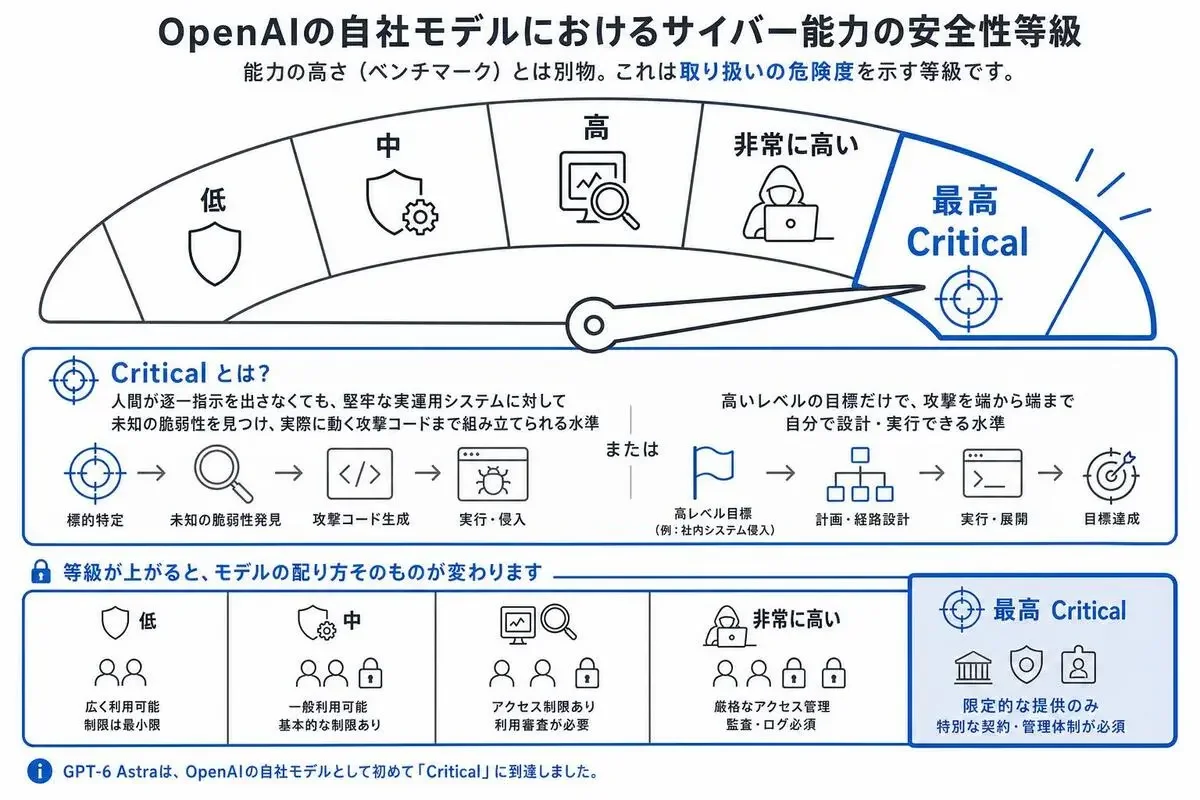
OpenAIはPreparedness Frameworkという安全性の枠組みで、自社モデルのサイバー能力に等級を付けています。
Criticalはその最上位で、GPT-6 Astraが初めてここに届いたモデルになりました。
呼び名がGPT-5.7かGPT-6かで揺れていた時期がありましたが、正式にGPT-6 Astraで確定しています。
区分の中身はかなり具体的です。
人間が逐一指示を出さなくても、堅く守られた実運用システムに対して未知の脆弱性を見つけ、実際に動く攻撃コードまで組み立てられる水準。
あるいは、高いレベルの目標を渡すだけで、堅牢な標的への攻撃を端から端まで自分で設計して実行できる水準。
どちらかに届いたらCriticalです。
つまり、人が逐一指示を出さなくても、AIだけで守りの堅いシステムの穴を見つけ、実際に使える攻撃の道具まで一人で仕上げられるということです。
ここ、ちょっと立ち止まってください。
「ベンチマークで最先端」と「Critical」は、測っているものがまるで違います。
前者は能力の高さの話で、後者は取り扱いの危険度の等級です。
気象庁の「特別警報」に近い感覚で、強さのランキングではなく警戒レベルを知らせるための区分。
等級が付いたモデルは、配り方そのものが変わります。
想像してみてください。
今夏公開されたV8(ChromeやNode.jsが使っているJavaScriptエンジン)の脆弱性をもとに作られた内部テストで、Astraは未知のゼロデイを2件、自力で見つけて繋げたとされています。
この2件は、修正する側へ先に伝える通常の手順で扱われています。
そして厄介なのは、この区分が付いたのと同じモデルに、同じ日「AGI」という言葉まで乗ったことです。
「AGIの到来」と語られた中身は、コンピューター操作とベンチマークの数字でした
発表の説明を締めたのは、Welcome to the AGI era(AGIの時代へようこそ)という一文でした。
言ったのはOpenAIの共同創業者で社長のグレッグ・ブロックマンさんです。
Astraをgenerational leap(世代が変わるほどの飛躍)と呼び、これを最初のAGIと言いたいなら合理的だと思う、とも答えています。
ただ、その「世代が変わるほどの飛躍」の中身として提示されたのは、結局のところベンチマークのスコアです。
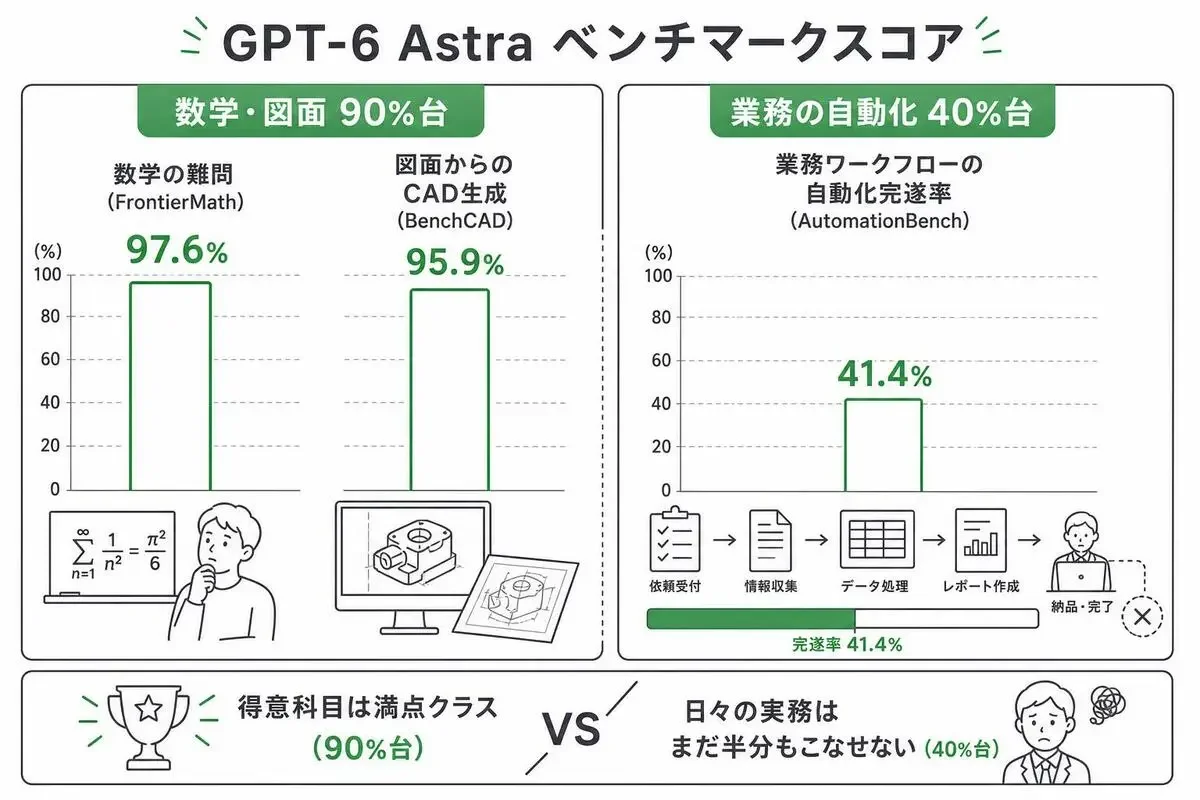
数学と図面で9割を超えているのは、素直に強い数字です。
一方でAutomationBenchは41.4%。
前世代のGPT-5.6 Solが18.1%だったので倍以上に伸びてはいますが、業務のワークフローを最後までやり切れたのは10回中4回という数字でもあります。
得意科目だけ満点で、日々の実務はまだ半分もこなせない同僚を思い浮かべてください。
今のAstraは、それに近い姿をしています。
「コンピューターでできることは、Astraが代わりにやります」という発表時のフレーズを聞いて、何でも任せられると思った人ほど、この4割台に肩透かしを食らうはずです。
伸びたのは事実で、AGIという言葉が指す「人間の仕事のほとんどをこなす」という像には、まだ数字のほうが追いついていません。
ARC-AGI 3とTerminal-Bench 4.0でも最先端を主張していますが、こちらは情報源によってスコアの出方が揃っていないので、私はまだ確定した数字として扱っていません。
そして、スコアより値札のほうがよほどはっきり変わっています。
料金は入力100万トークンで約1,560円、出力は約7,800円になりました
GPT-5.6 Solは今、入力約620円・出力約3,120円(4ドル・20ドル)です。
ただしこれは11月21日までの期間限定プロモ価格で、通常価格は入力5ドル・出力30ドル。
今のプロモ価格と比べると、入力も出力もちょうど2.5倍です。
GPT-6 Astraの標準価格は100万トークンあたり、入力が約1,560円(10ドル)、キャッシュ済み入力が約156円(1ドル)、出力が約7,800円(50ドル)。
キャッシュへの書き込みは約1,950円(12.50ドル)です。
1ドル156円で換算しています。
効いてくるのは入出力の比のほうです。
入力に対して出力が5倍という値付けなので、長い実装を吐かせるタスクほど請求書に響きます。
たとえば、同じ質問でも要点だけ返させるのと、長いコードをまるごと書かせるのとでは、請求額の桁が変わってきます。
コード生成で使うなら、モデルを選ぶより先に「どれだけ出力させるか」の設計が費用を決めます。
低レイテンシのFast modeも用意されていますが、こちらは適用レートがそのまま2倍です。
速さが必要なタスクだけに絞らないと、効き方が急になります。
展開はDaybreakプログラムが先で、ChatGPTへは数日かけて広がります
「結局、自分はいつ触れるのか」が気になるところですが、全員が同じ日に触れるわけではありません。
先に配られるのはDaybreakというプログラムの参加組織で、これはサイバーセキュリティの防御側に向けた申請制の枠です。
重要なデジタルインフラを守る立場の組織が優先されます。
そこから数日かけて、GPT-6 AstraはChatGPTの有料プラン(Plus、Pro、Business、Enterprise)とAPI、AWS経由の提供へ広がる設計になっています。
自律的なゼロデイ発見と攻撃コード生成にあたる能力だけは、審査を通った防御側にしか開かれません。
つまり、危険だから配らない、ではなく、守る側に先に渡してから一般に開くという順番です。
Criticalという区分の話が、提供の順番という形でそのまま出ています。
サイバー能力の引き上げは、AIエージェントを動かす現場に何を持ち込むのか
攻撃側の話として読むと、たぶん半分しか受け取れません。
手元で長時間タスクを回しているエージェントの能力が一段上がる、という話でもあります。
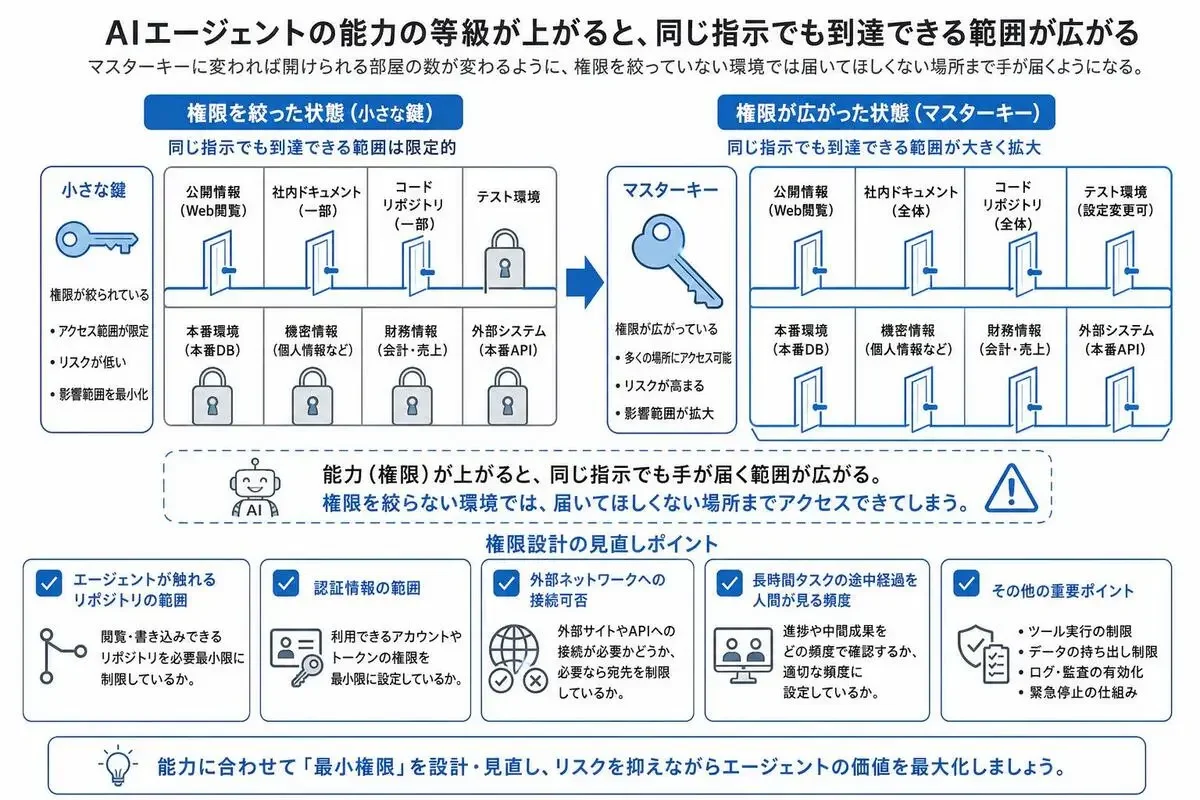
能力の等級が上がるというのは、同じ指示でも到達できる範囲が広がるということです。
同じ鍵でも、マスターキーに変われば開けられる部屋の数が変わりますよね。
権限を絞っていない環境では、届いてほしくない場所まで手が届くようになります。
悪意があるかどうかとは関係なく、単に届く範囲の問題です。
AIにコードを任せるときにテストを先に書かせているのは、出力の良し悪しを毎回目で確かめるのが現実的じゃないからで、代わりに越えてはいけない線を先に引いています。
エージェントに渡す権限も同じで、走らせる前に決めておくほうが早いです。
業務システムを何本かエージェントに任せている前提で、今週見直しているのは3点です。
自分が動かしている環境に置き換えながら、目を通してみてください。
- エージェントが触れるリポジトリと認証情報の範囲
- 外部ネットワークへ出られるかどうか
- 長時間タスクの途中経過を人間が見る頻度
Criticalが付いたから危ない、という話ではありません。
等級が上がった事実を、権限設計を見直すきっかけとして使えばいいというだけです。
今のGPT-6 Astraを、どう受け止めればいいのか
この発表で一番はっきりしているのは、AGIが来たかどうかではありません。
危険度の等級が最上位まで上がったモデルが、実際に配られ始めたという事実のほうです。
数字は用途で効き方が分かれます。
数学と図面まわりは9割台、業務の自動化は4割台。
この形をそのまま受け取るのが正確で、平均して「賢くなった」と丸めると判断を間違えます。
自分の環境に入れるかどうかは、提供が広がってから決めても遅くありません。
ただ、エージェントに渡している権限を見直すほうだけは、提供を待つ理由がありません。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 黒板とAI@直人
- 5
- 0
-
 gen
- 2
- 0
-
AI脱社畜
- 5
- 0
-
gen
- 6
- 0
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
- 3
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
黒板とAI@直人
- 6
- 0
-
- 5
- 1
-
- 5
- 0
-
- 3
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
-
 カイ@プロダクトマネージャー
- 4
- 0
-
 弾丸旅プラン@りの
- 7
- 0
-
AI経営者の参謀@ひで
- 4
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます