
AIエージェントの新機能は毎週のように流れてくるのに、手元の環境では社内のコードを1行も貼れない、そんな現場は少なくありません。
PKSHA Technologyが2026年9月9日に提供を開始した「PKSHA Private AI Agents」は、その前提のほうに手を出してきた製品です。
面白いのは「オンプレミスだから安全です」で止まらず、速度の話まで踏み込んでいるところです。
なぜ社内のコードを1行も貼れないのか。
リポジトリを読ませれば設計の相談ができるし、エディタに入れておけば手が速くなる。
ツールとしての便利さは、使えない現場ほどよく分かっています。
それでも社内規程で「クラウドの生成AIにソースコードを入力しない」と決まっていれば、そこで話は終わります。
情シスが意地悪をしているわけではありません。
入力されたものがどこに保存され、誰がどういう条件で扱うのかを説明できない状態では、止める以外の選択肢がありません。
対象は業務コードにとどまりません。
設計情報も社内文書も同じ扱いです。
結果として、AIエージェントの話題だけが先に進んで、手元の環境は何も変わりません。
ただ、これを運用ルールの問題ではなく、動かす場所の問題として捉え直した会社があります。
動く場所を社内に持つ、プライベートAIエージェントという発想です。
PKSHAはどんな会社か。
オンプレミスでLLMを回して運用まで見ます、という提案は、誰が言っているかで読み方が変わります。
PKSHA Technologyは2012年10月創業、東京大学の松尾豊研究室出身のメンバーが立ち上げたAI専業の会社です。
2017年に上場して、2024年に東証プライム市場へ上がっています。
直近の2026年9月期第3四半期累計の売上収益は283億円、前年同期比84.1%増と出ています。
ただ、この84.1%をそのまま成長率として読むのは正確ではありません。
伸びの大半はプロ人材のマッチングを手がけるサーキュレーションを子会社にした連結の影響で、AIの受託開発にあたる事業は約100億円で31.4%増、SaaSの事業は約86億円で31.7%増。
実態に近いのは3割強のほうです。
そのうえで、私はPKSHAを国内トップクラスのAI企業だと見ています。
研究室発のAI専業で14年続いていること、上場市場を下げずに上げてきたこと、受託とSaaSの両方が3割前後で伸び続けていること。
この3つが揃う会社は国内にそう多くありません。
PKSHA Private AI Agents が社内で完結させる範囲
提供開始は2026年9月9日。
導入企業のプライベートネットワークの内側ですべての処理が完結する設計で、ソースコードも設計情報も社内文書も外部のクラウドへ送らずにAIエージェントを動かせます。
そこで動くのは、国産LLMを含むオープンモデルです。
処理が社外に出ないなら、情シスが説明しなければならない対象そのものが減ります。
リリースの見出しは「低コストのオンプレミスサーバで高速応答可能な」です。
高価なGPUを大量に積んでください、という提案ではないと自分から宣言しているわけです。
すでに7000体が動く PKSHA AI Agents と、Private は動かす場所が違います
PKSHAは2025年4月にPKSHA AI Agentsを発表しています。
既存の「PKSHA AI SaaS」プロダクト群を土台にした展開で、個別製品も順次AI Agentsブランドへ改称が進みました。
発表時点で、すでに7,000体を超えるAIエージェントが全47都道府県で稼働していると書かれています。
今回のPrivateについて、リリースは「PKSHA AI Agents」の新ラインナップと位置づけています。
単独の新製品ではなく、すでに実績のあるエージェント基盤の延長線上として発表された形です。
違いは動かす場所です。
Privateは、オンプレミス型のAIエージェント群の基盤となるシリーズだとされています。
ゼロからオンプレミス専用に作ったものとは前提が違います。
オンプレミスは遅いという前提を、投機的デコーディングと量子化でどう崩すか。
手元のGPUの枚数だけが原因ではありません。
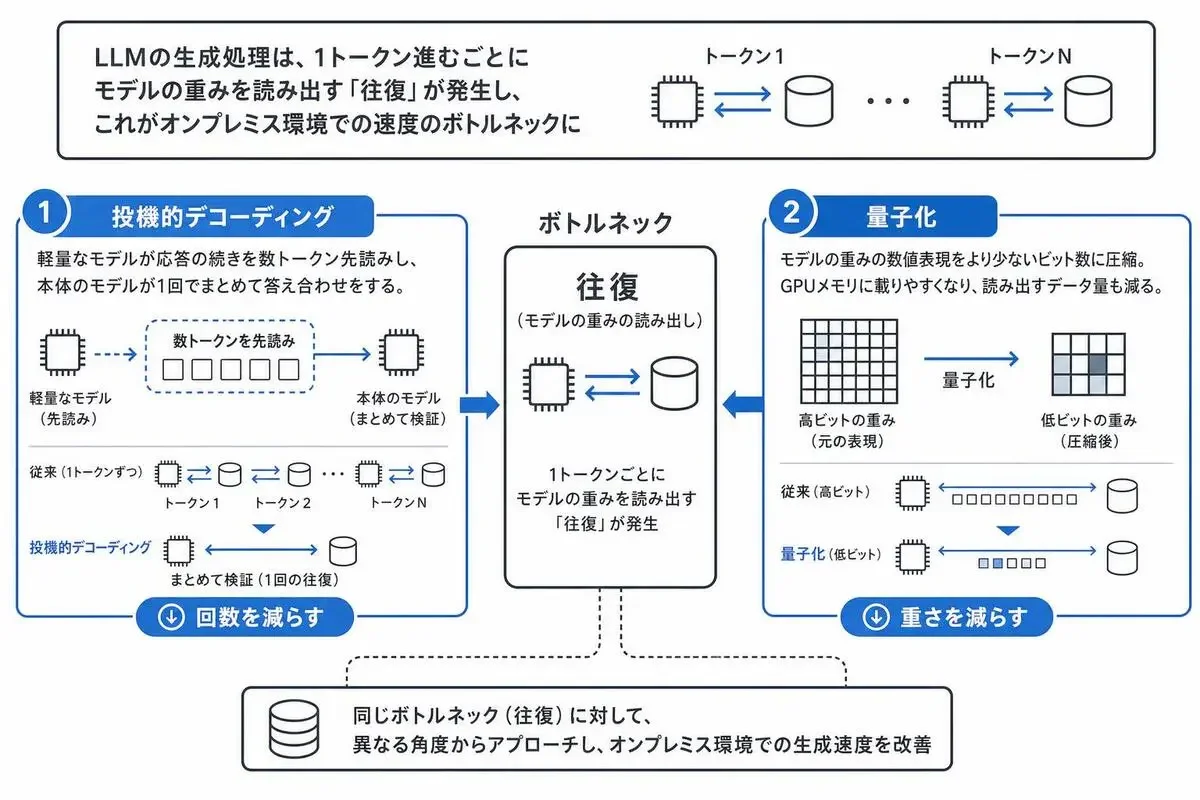
LLMの生成は1トークンずつ順に出す処理で、1トークン進むたびにモデルの重みを読み出す往復が発生します。
枚数が限られた環境では、この往復が全体の足を引っ張ります。
PKSHAが柱に挙げている2つの技術は、どちらもこの往復を削るものです。
軽いモデルが先を読んで、本体のモデルがまとめて答え合わせをします
投機的デコーディング(Speculative Decoding)は、軽量なモデルに応答の続きを数トークン走り書きさせて、本体のモデルが1回でまとめて答え合わせをする仕組みです。
合っていれば採用して、違っていればその地点から本体が書き直します。
速くなる理由は往復にあります。
本体のモデルからすると、1トークンずつ回すのも数トークンをまとめて検証するのも、重みを読み出す回数は同じです。
1往復で複数トークンぶん進めます。
CPUの投機的実行と同じ発想です。
先に走らせておいて、外したときだけ捨てる。
採否を決めるのは本体のモデルなので、軽いモデルに引きずられて品質が落ちる作りではありません。
数値表現を圧縮して、少ないGPUメモリでも回るようにします
量子化は、モデルの重みの数値をより少ないビット数で表現し直す技術です。
効き方は2段あって、まずGPUメモリに載る。
載らなければ動きません。
そのうえで読み出すデータ量が減るので、往復1回そのものが軽くなります。
投機的デコーディングが往復の回数を減らし、量子化が往復1回あたりの重さを減らす。
同じボトルネックを両側から削って、低コストのサーバでという話に持っていっています。
ただ、量子化は圧縮なので精度は多少落ちます。
どこまで落としても業務で使えるかの見極めは、導入する側に残ります。
応答速度がボトルネックでなくなると、次に効いてくるのは別の話です。
どのモデルを載せて、いつまで載せ続けられるか。
モデルを選んだあと、終わりを決めるのは誰か。
外部APIのモデルは、提供する側の都合でバージョンが終わります。
プロンプトを作り込んで、評価を回して、ようやく業務に組み込んだあとに終了を告げられる。
モデルの寿命を誰が握っているかは、それだけで無視できない条件になります。
Private AI Agents は特定ベンダーに依存せず、国産モデルを含む複数のオープンモデルから選べるとされています。
選定の軸は性能要件とセキュリティ要件とコストの3つ。
一度業務に組み込んだモデルは、企業ごとの判断とペースで継続利用も更新もできるとしています。
終わりを決めるのが提供側から自社側へ移る。
それがここでの変化です。
モデルを選べることと基盤ごと乗り換えられることは別ですが、寿命の主導権が動くのは大きいです。
企業のコーディング規約やレビュー観点、開発プロセスを取り込むことで、生成結果を直す工数を減らせるともしています。
ただしこれは、規約やレビュー観点が文書になっている現場でしか効きません。
暗黙知のまま口伝で回っていると、取り込ませる先そのものがありません。
金融、製造、医療で、外に出せないものは違います
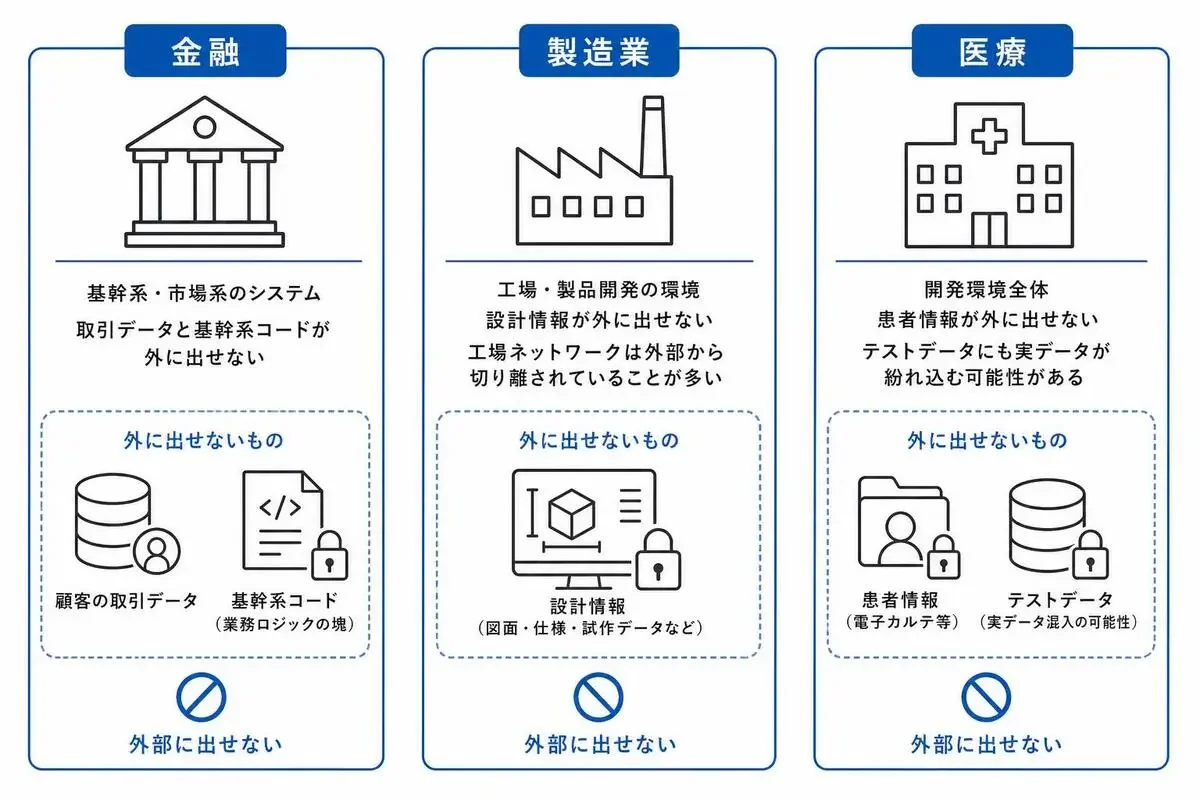
生成AIのセキュリティ要件は業種によって前提が変わり、オンプレミスのAIエージェントが効くかどうかもここで分かれます。
金融機関の基幹系や市場系で外に出せないのは、顧客の取引データにとどまりません。
基幹系のコードそのものが業務ロジックの塊で、読ませないと保守の相談が始まらない。
機密データは入力しない、という運用ルールでは回避できない構造です。
製造業だと、守る対象は製品の設計情報です。
加えて工場側のネットワークは外部から切り離された構成になっていることが多く、クラウドを使うかどうかを判断する以前に、そもそも届かない環境も珍しくありません。
医療とヘルスケアで出せないのは患者情報ですが、これは本番環境だけの話ではありません。
開発環境のテストデータに実データが紛れ込む可能性がある以上、開発環境ごと外に出せない扱いになります。
価格を聞く前に、手元で確認しておきたい3点
価格はプレスリリースに書かれていません。
代わりに書かれているのは伴走支援の中身で、モデル選定から推論基盤の構築、AIエージェント設計、導入後の運用改善までを支援するとされています。
パッケージを買って終わりではなく、環境に合わせて組み上げる形に近い。
一律の価格が出しにくいのもそのためだと読めます。
見積もりを取る前に、手元で確認しておきたいことが3つあります。
- 自社にGPUが何枚あるか。低コストのサーバでと言っていても、ゼロでは動きません。枚数とメモリを数字で言える状態にしておく。
- 性能とセキュリティとコストのうち何を優先するか。モデルを選べるということは、選ぶ基準を自分たちで決めるということでもあります。
- コーディング規約とレビュー観点が文書になっているか。取り込ませる先がなければ、規約への適応という特徴は効きません。
この3つは問い合わせなくても今日わかります。
価格を聞くのは、そのあとで間に合います。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
AI脱社畜
- 3
- 0
-
 キャリア迷子@そら
- 2
- 0
-
クロージング師匠
- 1
- 0
-
 カイ@プロダクトマネージャー
- 5
- 0
-
- 4
- 0
-
 たく
- 2
- 0
-
- 3
- 0
-
- 4
- 0
-
 タツヤ
- 2
- 0
-
- 3
- 0
-
 ここな
- 3
- 0
-
- 4
- 0
-
 gen
- 2
- 0
-
- 5
- 0
-
- 2
- 0
-
 棚島(たなしま)|フォロバ100
- 3
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます