
MLX比でおよそ2倍、llama.cpp比で3倍超。
ローカルLLM界隈にこの数字が回ってきたとき、正直「またベンチ盛ってるやつが来たな」と思いました。
ところが出どころを追いかけたら、盛るどころか条件を細かく開示していて、結論はだいぶ違うところに落ち着きました。
uzuとは何か、Apple Siliconだけを狙い撃ちしたRust製エンジン
uzuはMirai Labsが公開しているオンデバイス推論エンジンです。
コアはRustで書かれていて、ライセンスはMIT、バックエンドはMetalとCPUの2本立て。
ビルドターゲットは aarch64-apple-darwin、aarch64-apple-ios、x86_64-apple-darwin などApple系で固めてあり、WindowsとLinuxは今のところ「in progress」の札が下がったままです。
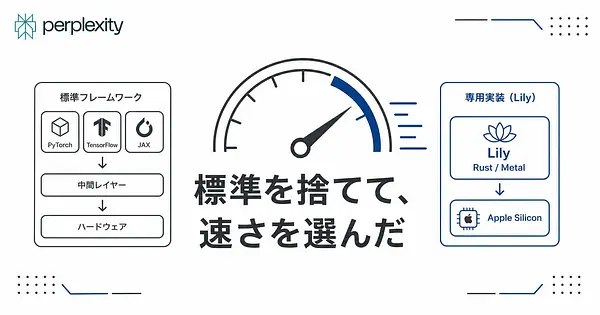
面白いのは、汎用性を最初から捨てているところ。
llama.cppが「どこでも動く」を取りにいったのに対して、uzuは「Appleの上で速い」だけに全部賭けています。
Swift、Python、TypeScriptのバインディングが揃っているので、iOSアプリにそのまま埋め込めます。
「Ollamaの置き換え」というより「アプリに組み込むランタイム」として設計されているのが分かる部分で、この割り切りが例の2倍・3倍という数字にも直結しています。
2倍と3倍の数字、条件を全部並べると見え方が変わります
この高速化、条件が4つ揃ったときの数字です。
- 対象モデルはQwen3.6 27Bのみ。Qwen3.8 27BとMuse Glimmer 30Bは今後対応の予定
- チップはApple M5系。M5のint8精度とGPU Neural Acceleratorsに合わせて設計されている
- 投機的デコードを有効にした状態
- llama.cpp比3倍のほうは「同等の量子化レベルで」という但し書き付き
とくに見落としやすいのが比較相手です。
MLX比2倍と言うときの相手はMTPLX、つまり「MLX + 投機的デコード」であってMLX単体ではありません。
投機的デコード同士で殴り合って2倍、と読むのが正確です。
測定条件も公式ブログに出ています。
1,355トークンの固定プロンプトを3回走らせた平均で、MT-Bench 80サンプル、MATH-500 128サンプル、HumanEval 128サンプルのマクロ平均。
伸びが最大なのは数学的推論とコーディングタスクだそうです。
速くなる仕掛けはDFlash-Weaverという独自のドラフトモデルで、小さな自己回帰トランスフォーマーと並列予測を組み合わせたハイブリッド構成。
ここがマジで攻めていて、一般的なMTP方式が一度に3〜4トークンしか先読みしないのに対して、uzuは16〜32トークンという投機バジェットを取ります。
しかもチェーン型ではなくツリー型。
外したときに捨てる量が増えるのを承知で、当たったときのリターンに振り切った設計です。
公開ベンチはM5 Max 128GBだけ、M1からM4の数字は出ていません
ここが、調べていていちばん引っかかったところでした。
公式のベンチマークページに載っているハードウェアは、Apple M5 Max 128GBの1機種だけです。
uzu 0.5.22でMLX、llama.cpp、MTPLXと比較していて、モデルはLFM2.5系とQwen3.5系、4bitと8bitの両方。
出力速度は最大599 tok/s(LFM2.5 1.2B Instructの4bit)、入力速度は最大18,083 tok/s、メモリ使用量は0.74〜9.12 GiBという数字が並びます。
数字自体は立派なんですが、M1からM4のデータが1件もない。
手元のM2 Airで同じ伸びが出るのかどうか、公式は何も約束していない状態です。
しかも開発チーム自身が、公開の場で「フォワードパスの実質的なボトルネックはたいていメモリ帯域で、それが推論速度の理論上限を決める」と認めています。
かなり誠実な発言だと思うんですが、裏を返すと帯域の細い旧世代チップではカーネルをいくら磨いても天井にぶつかるということ。
M5世代の伸び幅がそのままM1に降りてくると期待するのは、たぶん危険です。
Mirai Labsが掲げている目標値は「1,000 t/sを超えるとモデルはインターフェースになる」。
読み込み中の表示に200ms以上待たされるのを人は嫌う、だからそこまで速くする、という発想です。
この設計思想はM5前提で組まれていると考えたほうが、辻褄が合います。
入れて動かすまでの手順と、詰まりやすいところ
ただ試したいだけなら一般ユーザー向けのMacアプリが別途配布されているので、そっちが早いです。
エンジンとしてCLIやサーバーで回すなら、それなりのツールチェーンが要ります。
初期セットアップは cargo tools setup 一発で、Rustup、uv、pnpm、Rustのターゲット、Metal toolchainまでまとめて入ります。
あとは起動するだけ。
# 対話モードで起動
cargo run --release -p cli

# モデルを指定して起動
cargo run --release -p cli -- --model trymirai/Qwen3.5-4B-M

# OpenAI互換サーバーとして立てる
cargo run --release -p cli -- server --model trymirai/Qwen3.5-4B-M --host 0.0.0.0 --port 8080
最後のサーバーモードが死ぬほど重要で、OpenAI互換なので既存アプリの向き先を差し替えるだけで試せます。
乗り換えコストを一番下げているのは間違いなくここ。
で、罠が3つあります。
--releaseビルドなので初回は普通に待たされます。ollama runの感覚で叩くと固まったかと疑います- モデル識別子が
alibaba:qwen3.5:0.8b:mirai:mirai-m:4のようなコロン区切りの独自形式。手元のGGUFをそのまま食わせることはできず、Mirai側が変換済みのモデルを使うか、lalamo で自分で変換する必要があります - これが一番効くんですが、モデルのラインナップが狭い。Qwen3.5(0.8B / 2B / 4B / 9B)、Qwen3.6と3.8の27B、LFM2.5(230M / 350M / 1.2B / 2.6B)、Muse Glimmer 30B。GemmaやLlama系は現状ありません
3番は速い遅い以前の話で、使いたいモデルが載っていなければそこで終わりです。
逆に、すでにQwen系で組んでいる人にはほぼ関係ありません。
乗り換える価値がある人と、まだ様子見でいい人
結論から言うと、今のuzuが刺さるのは次のどれかに当てはまる人です。
- M5系のMacを持っている。公式ベンチが唯一裏付けている領域がここ
- Appleプラットフォーム向けアプリにローカル推論を組み込みたい。uzu-swift 経由でiOSに載せられる強みは、Ollamaにもllama.cppにもありません
- 使うモデルがQwen系かLFM2.5系で足りている
逆に、まだ急がなくていいのはこのあたり。
- M1からM4を使っている。恩恵の量を示すデータが公開されていないので、判断材料そのものがない
- GemmaやLlama、あるいは手元のGGUF資産を使い回したい
- Ollamaのモデル管理やエコシステムに日々の作業が乗っている
個人的な評価としては、数字が条件付きなのはマイナスじゃないです。
プロンプト長からデータセットのサンプル数まで開示していて、ボトルネックがメモリ帯域だと自分から言っているプロジェクトは、少なくとも盛る側の振る舞いをしていません。
M5を持っているなら今日入れて損はないし、それ以外の世代なら第三者のベンチが出るまで待つ。
今はその温度感が妥当だと思います。

- 1
- 0
Claude Code / Cursor / Codex を毎日触る若手Webエンジニア。新ツールの実況・比較・アンチパターンを深夜テンションで書きます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 2
- 0
-
- 4
- 0
-
- 2
- 0
-
- 3
- 0
-
 gen
- 4
- 0
-
- 3
- 0
-
gen
- 2
- 0
-
- 5
- 0
-
プロンプト画伯
- 6
- 0
-
- 2
- 0
-
gen
- 6
- 0
-
- 6
- 0
-
gen
- 9
- 0
-
gen
- 8
- 0
-
- 5
- 0
-
gen
- 10
- 0
-
- 6
- 0
-
gen
- 9
- 0
-
- 8
- 0
-
gen
- 9
- 0
- もっとみる


コメント
ログイン か 会員登録 するとコメントできます