
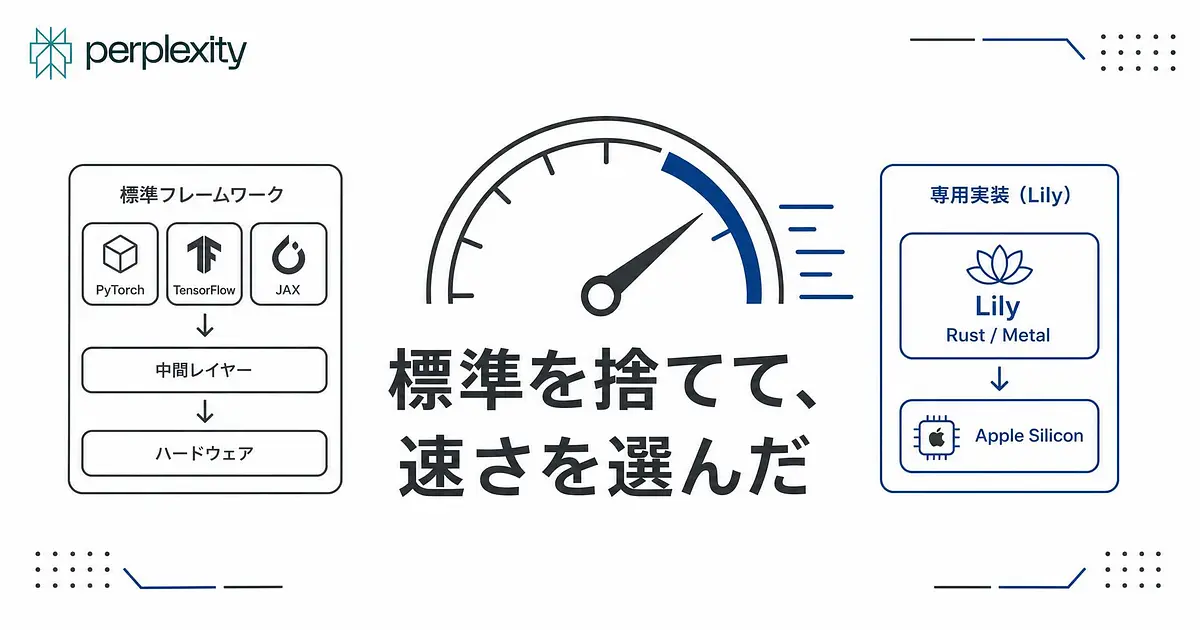
Apple SiliconでローカルLLMを動かすなら、まずMLXかllama.cppを見る。
ところがPerplexityが9月2日に公開した推論エンジンのLilyは、そのどちらも実行パスに置いていません。
MLX-LMと比べてプリフィルは1.23倍、デコードは1.35倍、それでいて出力の一致率は96%台を保っています。
Lilyは、Qwen3.6-35B-A3B専用に作られた推論エンジンです
Lilyは単独のリポジトリとして出てきたわけではなく、perplexityai/pplx-garden という推論技術のOSS群に置かれた1サブプロジェクトです。
同じ場所にRDMA転送エンジンの fabric-lib やMoE向けの p2p-all-to-all が並んでいて、Lilyはその中のApple Silicon担当にあたります。
リポジトリ全体はMIT、LilyのディレクトリだけApache-2.0と、ライセンスの粒度も分かれています。
中身はRustのランタイムと手書きのMetalカーネルだけ。
チェックポイントの読み込みと生成ループをRustが回し、計算そのものはMetalカーネルが担い、外にはOpenAI互換のchat completions APIが1本生えています。
単一プロセスで完結する、驚くほど素っ気ない構成です。
動くのは指定リビジョンの4bitチェックポイント1つだけです
READMEが求めているのは、group size 64のMLX affine 4bitに量子化されたQwen3.6-35B-A3B。
GGUF、AWQ、GPTQ、int8、fp8、BF16のオリジナル、denseなチェックポイント、小型バリアント。
このあたりはすべて非対応と明記されていて、起動時にアーキテクチャと量子化レイアウトを検証して弾きます。
Hugging Face上のオリジナルが71.9GB、4bit変換後が20.4GB。
重みだけで20GB強を占めるので、動かすなら統合メモリ32GB以上のMacが実質的なラインになります。

MLXもPyTorchも、Lilyの実行パスには入っていません
MLXはApple純正の機械学習フレームワークで、Mac上でLLMを動かすときの事実上の標準です。
ローカルLLM系のツールはたいていMLXかllama.cppの上に乗っていて、そこから降りる理由は普通ありません。
面白いのは、Lilyが降りたのが実行パスだけだという点です。
読み込む重みは mlx-community が公開している4bit変換をそのまま使っていて、エコシステムには乗り続けている。
作り直したのは推論を回す層であって、資産まで捨てたわけではないんですね。
とはいえフレームワークを使わない以上、カーネルの融合もメモリ配置もスケジューリングも全部自分の責任になります。
その代わり、汎用フレームワークが「どのモデルでも動くように」抱えている余白は持たなくて済む。
このトレードオフを引き受けられるかどうかが、今回の分かれ目でした。
M5 Maxの実測で、MLX比プリフィル1.23倍、デコード1.35倍が出ています
計測環境は40コアGPUと128GB統合メモリのM5 Max。
10種類のプロンプト長と10種類のデコード文脈長で測って、すべての条件でLilyがMLX-LMを上回っています。
平均するとプリフィルが4,156対3,388 tok/sで1.23倍、デコードが170.0対126.4 tok/sで1.35倍。
レンジで見るとプリフィルが1.12〜1.42倍、デコードが1.31〜1.37倍で、条件によって差の出方は動きます。
4Kプロンプトかつ4Kコンテキストの条件だと、プリフィルは5,749.9対4,737.5 tok/sまで開きます。
出力の一致率は96.35%で、速度と精度を交換していません
teacher forcingで測ったperplexityの差は0.04%、192箇所で見たトップトークンの一致率は96.35%。
量子化や近似で精度を削って速くした、という類の数字ではありません。
「速いけど出力が変わるなら怖くて使えない」という警戒に、先回りして数字を置いてあります。
プリフィルとデコードを同じ仕事として扱わない、というLilyの割り切り
プロンプトをまとめて読み込むプリフィルは、大量のトークンを一度に流せるぶん計算そのものが詰まります。
1トークンずつ吐き出すデコードは、計算量が小さいのに毎ステップ重みとKVキャッシュを読みに行くので、詰まる場所がメモリ帯域に移ります。
同じ推論でもボトルネックが別物なので、効く手当ても変わります。
Lilyはこの2つを最初から別々に最適化しています。
プリフィル側は4bitの重みをgrouped GEMMの中で復元して融合させ、512トークンのプロンプトで77.4%改善。
MoEのルーティングをGPUに閉じてレイヤーごとのCPU同期をなくし、そこからさらに89%。
デコード側は、1ステップあたり795個のカーネルが作る555段の逐次処理を、依存関係の解析で重ね合わせています。
GQAでKVの各行を1回だけ読むようパッキングして32Kコンテキストで23.8%、固定ブロックのアテンション配置は128Kコンテキストで40.2%効いています。
数字の細かさより、入力処理と出力処理を別のワークロードとして切ったという判断のほうが持ち帰りどころだと思っています。
Qwen3.6の256エキスパートと2種類の層が、MLXとLilyの差を作っています
Qwen3.6-35B-A3Bは総パラメータ35Bのうち、1トークンあたり実際に動くのは約3Bです。
256個のエキスパートを毎回スコアリングして8個を選び、共有エキスパート1個を足す。
40層のうち30層がGated DeltaNet、10層がGQA付きのフルアテンションという混在構成で、クエリヘッド16に対してKVヘッドは2しかありません。
汎用フレームワークは、この構成も数ある設定値の組み合わせの1つとして受け取ります。
Lilyは同じ構成を、絶対に動かない前提として最初から埋め込める。
256中8個という疎なルーティングも、8対1のKV圧縮も、決め打ちできるならスケジューリングごと設計できます。
対応モデルを1つに絞ったことと速いことは、同じ判断の表と裏です。
LilyはPerplexity Computerのために作られ、OSS公開はその後についてきました
見落とされやすいのが、公開の順序です。
Perplexityは9月1日、Mac向けアプリのPerplexity ComputerにHybrid Computeを載せています。
クラウドの大きいモデルがWeb検索や計画を担当し、機密ファイルや端末操作にあたる工程だけを、文脈を保ったままMac上のローカルモデルに引き渡す仕組みです。
端末を出る手前ではPII-Tracerと呼ぶオンデバイスの分類器が働き、認証情報や決済カード番号、政府発行IDを含む37種類のラベルを見て、ローカル保持・マスク・拒否・ユーザー確認の4択を返します。
この設計は、ローカル側が遅い時点で成立しません。
Lilyはその制約への答えとして先に作られ、できあがったものが速かったから公開された。
OSSで話題を作りにいったのではなく順序が逆で、そう読むと「1モデル専用」という割り切りも自然に見えてきます。
MLXで足りるのか、Lilyのような専用実装に踏み込むのか
Lilyが取ったのは、対象を固定できるなら汎用性を捨てた分が速度で戻ってくる、という賭けです。
裏返せば、Qwen3.6-35B-A3Bが1年で入れ替われば、このエンジンの価値も一緒に落ちます。
Perplexityはそれを承知のうえで、自社製品の寿命と釣り合うと判断した。
私たちが同じ形の判断をする場面は、推論エンジンよりずっと手前にあります。
汎用のライブラリに乗せるか、自分たちのデータ構造に合わせて書くか。
見るべきは「速くなるかどうか」ではなく、固定できる前提がどれだけ長く保つかのほうです。
なおLily自体をいま動かせる人は、かなり限られます。
READMEが要求しているのはApple GPU family 10以降、つまりM5以降のチップとmacOS 26以降で、手元のM2やM3ではそもそも起動しません。
それでも、Metalカーネルを手書きしたらどこまで出るのかという実測値が公開された意味は、条件が揃わない側にとっても小さくないはずです。
- 2
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
AI脱社畜
- 3
- 0
-
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
 黒板とAI@直人
- 6
- 0
-
- 3
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
-
 カイ@プロダクトマネージャー
- 4
- 0
-
 弾丸旅プラン@りの
- 7
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
 NONOKA
- 5
- 0
-
ワンオペ育児×AI@まな
- 2
- 0
-
- 2
- 0
-
 キャリア迷子@そら
- 2
- 0
-
 タツヤ
- 2
- 0
-
 さくら
- 4
- 0
-
 ゆず
- 5
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます