
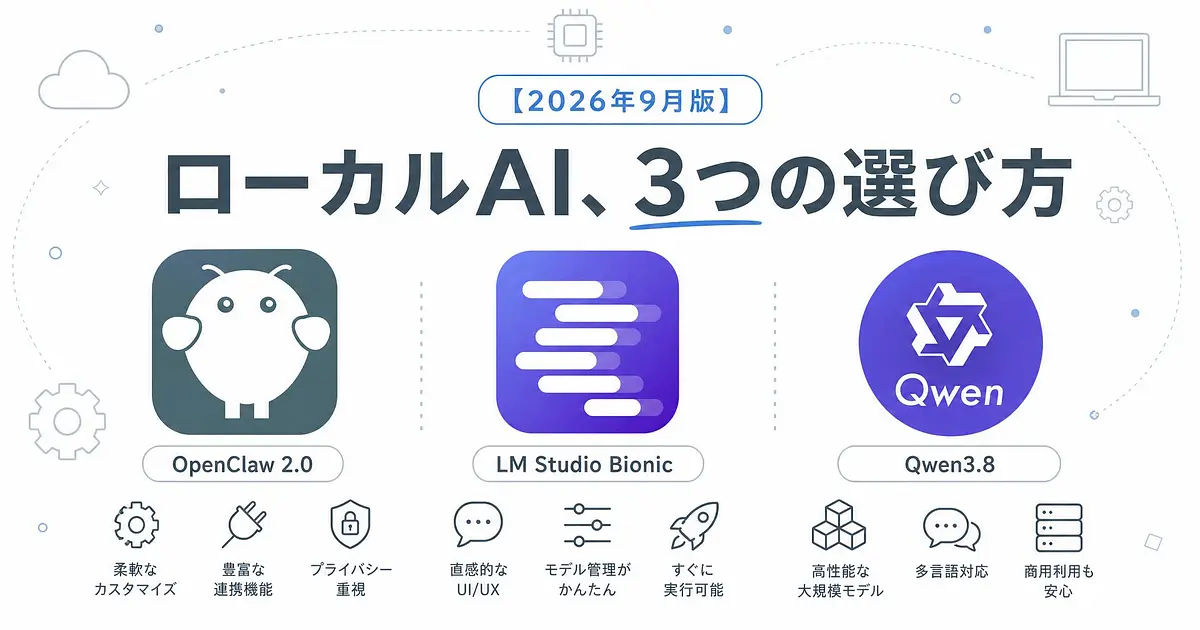
社内のコードをクラウドのAIエージェントに読ませていいのか。
ここで手が止まった経験があるなら、7月16日から8月末までの1か月半は追いかける価値があります。
ローカルで完結する選択肢が3つ出そろって、しかもその3つは競合していないんですよ。
この1か月半で、クラウドを使わない選択肢が3つ出そろいました
並べるとこうなります。
- 7月16日 LM Studio Bionicが初期プレビューとして公開
- 8月12日 Qwen3.8-Maxのオープンウェイトが公開
- 8月14日 Qwen3.8-27BがApache 2.0で公開
- 8月30日 OpenClaw 2.0(バージョン2026.8.1)がリリース
個別のニュースとしては、それぞれ大手メディアが報じています。
ただ1本ずつ読んでいると気づきにくいことがあって、この3つは「クラウドに送らずに済ませる」という同じ問いに、まったく違う層から答えを出しています。
エージェントの基盤、専用アプリ、モデルそのもの。
立っている場所が違います。
だから「どれが一番いいか」を比べても、あまり意味がありません。
比べるべきは、自分がどの層で困っているかのほうです。
OpenClaw 2.0は、任せることに振り切った大型更新でした
まず数字が普通じゃないです。
933人のコントリビューターが参加して、16,000件を超えるプルリクエストがマージされました。
うち569人が初参加です。
プロジェクトにこれまでマージされた全PRの、およそ半分がこの1リリースに入っている計算になります。
約7週間の沈黙のあいだに何が積まれていたのか、これでようやく分かりました。
OllamaとLM Studioのローカルモデルを、オンボーディングが自動で見つけます
セットアップの時点で、Gatewayホストから到達できるOllamaやLM Studioのサーバーを走査して、すでに入っているツール対応モデルを検出してくれます。
読み取りだけのパスなので、勝手にモデルをダウンロードすることはありません。
ローカルでモデルを動かしている人がOpenClawを入れると、接続先の候補として自分のマシンが最初から出てくる、ということです。
「ローカルLLMをエージェントに繋ぐ」作業が設定ファイル書きから選択式に変わったのは、体感としてかなり大きいです。
資格情報をチャット履歴にもモデルにも残さない仕組みが入りました
個人的にはここが一番アツいポイントです。
エージェントが秘密情報を必要としたとき、マスク付きのプロンプトで値を要求できるようになりました。
入力した値はチャット履歴にも、モデルのコンテキストにも入りません。
さらに、保護対象の秘密を承認済みの宛先にだけ置換するプロキシがオプションで用意されていて、共有クレデンシャルストアの値は書き込み専用です。
これ、何が嬉しいかというと「任せる」の前提そのものが変わるんですよ。
今までAIエージェントに実務を任せようとすると、APIキーを平文で渡すしかなくて、そのキーは会話ログにもモデルの入力にも残っていました。
渡し方を制御できるようになったぶん、任せられる範囲が一段広がります。
ちなみにサンドボックスや承認フローは、既定では無効のままです。
厳しめに運用したいなら自分で有効化する必要があります。
LM Studio Bionicは、オープンモデルで仕事とコードに振っています
Element Labsが7月16日に初期プレビューを公開しました。
オープンモデル専用のエージェントアプリで、コードベースを読んで説明して変更するところまでやりますし、PDF・スライド・スプレッドシートを横断した資料作成もこなします。
音声の文字起こしもローカルで走ります。
ローカルとクラウドを、タスクごとに置き換えられます
実行先が3つあります。
アプリ内で落としたローカルモデル、LM Link経由でつないだ別マシン、そしてLM Studio Secure Cloudです。
面白いのはクラウド側の扱いで、Bionicの利用者全員に対してゼロデータ保持を公式にコミットしています。
リクエストは一時的に処理されるだけで完了後には残らず、学習にも使わないと明記されています。
「ローカルか、クラウドか」の二択で悩むのではなく、タスクごとに置き場所を選ぶ。
この設計思想は、3つの中で一番はっきりしています。
Qwen3.8は、モデル単体を自分のランタイムに載せる道です
残りの2つがアプリだったのに対して、こちらはモデルです。
動かす箱は自分で用意します。
8月3日に発表されたQwen3.8-Maxは2.4兆パラメータのスパースMoEで、推論時に動くのは約950億パラメータ。
8月12日に重みが公開されました。
ただ正直に書くと、Maxを個人で回すのは現実的ではありません。
ローカル推論にはH100やA100クラスのGPUを複数並べる想定になっていて、1bit量子化で400GB近くまで圧縮しても事情はあまり変わりません。
現場で効くのは、8月14日に出た27Bのほうです。
Apache 2.0で、ネイティブのコンテキストは262,144トークン。
4bit量子化なら17GB前後まで落ちるので、24GBのGPUや余裕のあるMacに載ります。
ベンチマークはLiveCodeBench v6で90.3、Terminal-Bench 2.1で73.0、SWE-bench Proで61.7。
ただしこれらはAlibabaが自社のハーネスで測った数字で、第三者による独立再現はまだ揃っていません。
Terminal-Bench 2.1に限れば、Claude Opus 4.6 Maxの78.2に5ポイント届いていません。

3つは競合ではなく、選ぶ基準が違うだけです
整理するとこうなります。
しかもこの3つは排他ではありません。
OpenClawのオンボーディングはLM Studioを検出しますし、Bionicのローカル実行でQwen3.8-27Bを動かすこともできます。
勢力図とは書きましたが、実態はかなり重なり合っています。
私がこの3つをどう見ているか
共通しているのは「データをどこに置くかを、使う側が決められる」という一点です。
誤解のないように書いておくと、クラウドのAIエージェントをやめるべきという話ではありません。
速度も精度も、今のところクラウド側に分があります。
私が実務で使っている判断の順番は「外に出せないデータが混じっているか」が先で、混じっているタスクだけをローカルに寄せる形にしています。
もし1つだけ試すなら、Bionicを入れて27Bを落とすのが一番ハードルが低いです。
4bit量子化なら24GBのGPUで足りますし、Apache 2.0なので使い道で悩む必要もありません。
クラウドを経由せずにコードを読ませるのがどういう体験なのか、30分もあれば分かります。
そこで手応えがあったら、次に考えるのはOpenClawに何を任せるかです。
この1か月半で増えたのは選択肢ではなく、判断材料のほうかもしれません。
- 4
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
- 2
- 0
-
AI脱社畜
- 3
- 0
-
 キャリア迷子@そら
- 2
- 0
-
クロージング師匠
- 1
- 0
-
 カイ@プロダクトマネージャー
- 5
- 0
-
- 4
- 0
-
- 3
- 0
-
 gen
- 1
- 0
-
 たく
- 2
- 0
-
- 3
- 0
-
 タツヤ
- 2
- 0
-
- 2
- 0
-
- 3
- 0
-
- 3
- 0
-
gen
- 4
- 0
-
 ここな
- 3
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます