
エージェントに30分ほど作業させたあと、何をどの順で触ったのか正確に説明できますか。
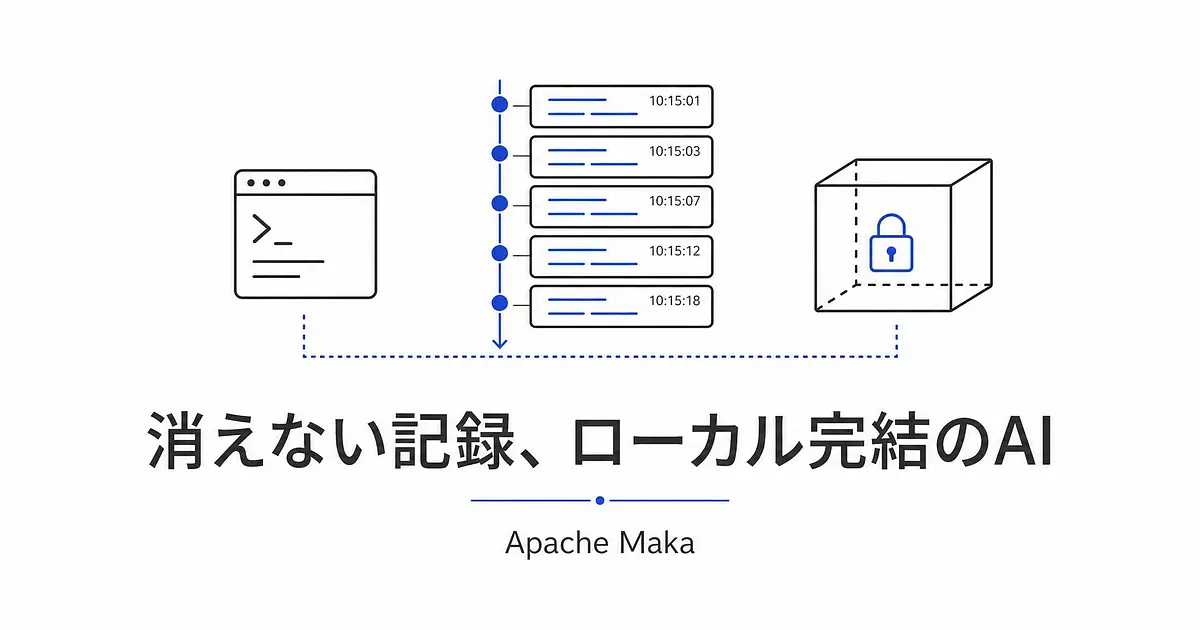
Apache Makaは、この問いに機能ではなく構造で答えようとしているプロジェクトです。
Apache Software Foundationのインキュベーターに入ってから1週間ほどで約2,000スターを集め、2026年8月23日にはGitHub Trendingの週間1位に立ちました。
画面に映っているものは、記録のコピーでしかありません
Apache Makaの設計で最初に押さえるべきは、UIとログの主従関係が普通のツールと逆になっていることです。
デスクトップのチャット画面に流れているやり取りは記録のビューであって、正本ではありません。
正本はRuntime Event Logという追記型のログのほうです。
ここに書き込まれるのは5種類。
モデルのメッセージ、ツール呼び出し、ツール実行結果、権限判断、そして終了イベントです。
私が効くと思ったのは最後の終了イベントでした。
そのターンが完了したのか、途中で中断されたのか、失敗で落ちたのかが、あとから推測ではなく事実として引ける。
ログを目で追って「たぶんここで止まった」と読む作業が要らなくなります。
Apache Software Foundationが引き取ったのは、2026年8月13日です
Apache配下という字面から「もう枯れているプロジェクトなんだろう」と読む人がいますが、順序が逆です。
インキュベーター入りは2026年8月13日で、まだ2週間ちょっとしか経っていません。
体制はチャンピオン1名、メンター4名、コミッター7名です。
そしてASFの「Incubating」は、コードの完成度や安定性を評価した結果ではありません。
インフラ、コミュニケーション、意思決定プロセスがASFの求める水準で安定していると認められるまでの段階、つまり財団としてまだ正式に承認しきっていないという意味です。
ここが実務的に効いてきます。
リポジトリに同梱されている DISCLAIMER-WIP には、このリポジトリやパッケージレジストリから配布されているものは正式なApacheリリースではなく、Incubator PMCのレビューも投票も経ていないと書かれています。
GitHubのReleasesに並ぶv0.1.11も同じ扱いです。
さらに同じファイルには、ソフトウェアグラントとコミッターのICLAがまだ完了していないという既知の課題が挙がっていて、他の製品に組み込む前にライセンスレビューをすることが推奨されています。
「Apache製だから安心」で本番に入れると、あとで法務から差し戻しが来る類の話です。
Runtime Hostという1つの実行権限に、全部のUIがぶら下がっています
Apache Makaにはデスクトップアプリ、TUI、CLI、bot、評価用クライアントと入り口が複数あります。
ただし実行するのは常にRuntime Hostという1つの権限で、どの入り口から来てもそこに実行を依頼する形になります。
責務の分け方も明確です。
SessionManagerとAgentRunが実行のライフサイクルを持ち、Runtime Hostは受付、クライアントの能力、やり取り、公開プロトコルを持つ。
依存関係のある作業はAgent Graphが子セッションとしてスケジュールし、その起動も必ず同じRuntimeを通ります。
つまり「CLIから動かしたときだけ記録が薄い」という穴が構造的に生まれない。
入り口ごとにログの実装が分かれているツールを触ったことがあると、この一本化のありがたみは分かると思います。
中断したセッションの再開は、既定でオフになっています
中断したターンを再開する機能はありますが、既定では無効です。
MAKA_RUNTIME_SAFE_BOUNDARY_RESUME=1 を明示的に立てないと動きません。
「再開できます」を売りにせず「勝手に再開しません」を既定に置いたのは、実務目線だと正しい判断だと思います。
中断は事故で起きることが多くて、その状態から自動で走り出されるのが一番怖い。
セッションの分岐、リトライ、再生成はデスクトップ側で普通に扱えるので、必要なら手で選べば済みます。
サンドボックスの内側は自動で動き、外に出るときだけ承認が要ります
組み込みツールはRead、Write、Edit、Bash、Glob、Grepの6つです。
このうちファイルを書き込むものとシェルを走らせるものは、まずサンドボックス境界を通してから実行されます。
そして境界の外に出るツール実行だけが、人間の承認を要求します。
重要なのは、その承認判断そのものもログに残ることです。
誰が何を許可したかが実行記録と同じ場所に並ぶので、あとから経緯を再構成するときに別のソースを突き合わせなくて済みます。
走っている最中の中断もできて、失敗は分類されて返ってきます。
汎用のエラー文字列を投げて終わり、ではありません。
v0.1.11ではWindows側にAppContainerを使った仲介型のサンドボックスが入り、ローカルIPCの所有権とACL強制も締められました。
境界の実装をまだ後追いで足している段階、という見方もできます。
文脈を削っても、履歴のほうは消えません
個人的にはここが一番アツいポイントです。
コーディングエージェントを長時間走らせると、必ずコンテキスト圧縮が挟まります。
で、圧縮したあとに「さっきのツール出力をもう一回見たい」となって、もう手元にない。
この経験、ありませんか。
Apache Makaはこれを構造で外しています。
context pruningやcompactionが変えるのはモデルへ渡す入力の射影だけで、ログ本体は変わらない。
公式の言い方だと「短い文脈は、削除された履歴ではない」です。
次のプロンプトから古いツール出力を省くことはあっても、保管された証跡のほうは捨てません。
デバッグや監査の観点だと、この差はかなり大きい。
エージェントの挙動をあとから検証するとき、モデルが何を見ていたかと、実際に何が起きたかは別々に必要になるからです。
触れる環境がまだ狭いことは、先に知っておいた方がいいです
ここは正直に書いておきます。
今の公開バイナリはこれだけです。
ソースから触る場合はNode.js 22.19以上、npm 11、Git、ripgrepが要り、Peer/Peer Mesh周りを触るならRust 1.98以上も必要です。
さらに公式が「データ形式もCLIコマンドも実験的な機能も、まだ変わる可能性がある」と明記しています。
形式が安定している前提で本番の自動化を書くのは、今はやめておいた方がいいです。
開発速度そのものは速くて、v0.1.11は2026年8月18日リリース、24人のコントリビューターによる375件のマージ済みPRが入っています。
動きが速いことと安定していることは別の話ですが、勢いは本物です。
今のApache Makaは、誰が触ると得をするのか
触る価値があるのは、エージェントの実行記録そのものが成果物になるチームです。
何をどの順で実行して、どこで人間が許可を出して、どう終わったのか。
これを説明する必要がある評価やコンプライアンスの文脈だと、ログを後付けで整備するより最初からこの構造に乗る方が早いです。
逆に待った方がいいのは、Linux前提の開発環境と、CLIやデータ形式の安定を前提にした自動化を組みたいケース。
前者は物理的に動かないし、後者は変更に追随し続けるコストの方が高くつきます。
もう1点触れておくと、Apache Makaはモデルを自分で用意する設計です。
クラウドAPIでも、ローカルで動かしているものでも、互換ゲートウェイでもいい。
セッションも設定も実行記録も既定で手元に残るというローカル完結の主張は、ここまで揃って初めて成立しています。
私は監査ログが要る案件を今抱えていないので当面は様子見にしますが、Linuxビルドが出たタイミングでもう一度触ります。
エージェントの実行を「あとから説明できる」状態にしておくことの価値は、必要になってから整備しようとすると一番高くつく種類のものなので。
- 2
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
- 5
- 1
-
- 5
- 0
-
AI脱社畜
- 5
- 0
-
 gen
- 1
- 0
-
- 2
- 0
-
- 3
- 0
-
 キャリア迷子@そら
- 2
- 0
-
クロージング師匠
- 1
- 0
-
gen
- 4
- 0
-
 カイ@プロダクトマネージャー
- 5
- 0
-
- 4
- 0
-
- 3
- 0
-
 たく
- 6
- 0
-
gen
- 1
- 0
-
- 4
- 0
-
たく
- 2
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます