
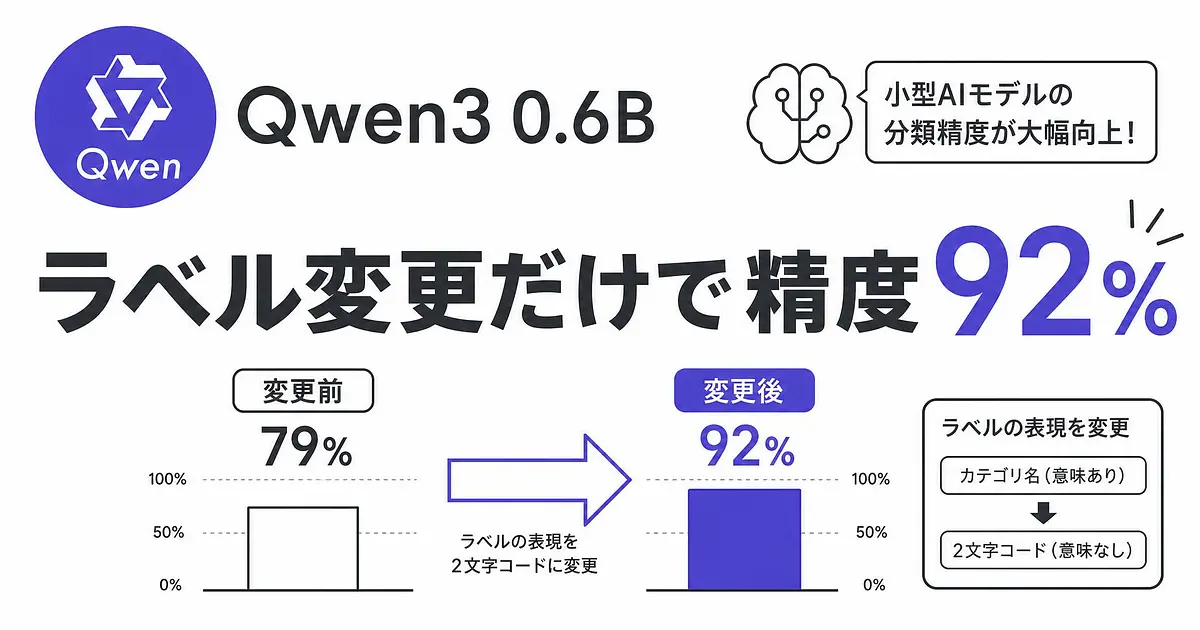
6億パラメータのモデルに18種類のカテゴリ分類をやらせて、正答率92%。
増やしたのはデータでもモデルサイズでもありません。
カテゴリ名をそのまま答えさせると79%、意味を持たない2文字コードに置き換えると92%、変えたのは出力させるラベルの書き方だけです。
6億パラメータのQwen3 0.6Bが、18カテゴリの分類で92%を出しました
タスクは家庭まわりの質問を18種類に振り分けることで、appliances(家電)から hvac(空調)、pool、water heater(給湯器)まで、住宅の設備と作業がひととおり並んでいます。
「うちの給湯器、最後に点検したのいつだっけ」のような質問が飛んできて、モデルはどのカテゴリの話かを1語で返す。
分類器そのものです。
使ったモデルは Qwen3:0.6B。
総パラメータ0.6B、埋め込みを除くと0.44B、28層でコンテキスト長は32,768トークン。
GPUなしのノートPCでも動く側のサイズです。
この規模で18択を9割当てられるなら、分類まわりを外部APIに投げ続ける理由はかなり減ります。

850件のデータをUnslothとQLoRAで学習させ、131件でテストしています
約850件を70対15対15で train / eval / test に分割しています。
分類タスクの学習データとしては、手作業で集めきれる程度の量です。
ファインチューニングは Unsloth に QLoRA の組み合わせ。
4bit量子化したベースモデルにLoRAアダプタを載せる、省メモリでファインチューニングするときの定番の構成です。
押さえておきたいのは、このあと出てくる2つの方式が同じ131件のテストケースで測られていること。
測る物差しは固定したまま、ラベルの表現だけを差し替えた比較になっています。
プロンプトだけで分類させたときの正解は、131件中13件でした
18択なので、当てずっぽうに選んでも5.6%は当たります。
ファインチューニングなしの13件、約10%はそれをわずかに上回っただけで、実質的には何も分類できていません。
ただ「0.6Bだから使い物にならない」という結論は、たぶん早すぎます。
18個の選択肢をプロンプトで提示して1つ選ばせるのは、指示追従の負荷がそれなりに高い。
長い選択肢リストを保持したまま、そこから逸脱せずに1語だけ返す。
この制約を0.6Bクラスは持ちこたえられません。
モデルの知識ではなく、タスクの渡し方の問題です。
カテゴリ名をそのまま出力させる方式は、79%で頭打ちになりました
同じ850件で学習させると、正答率は0.7939まで跳ねます。
10%からの上がり方としては十分で、ここで手を止めてもおかしくない数字です。
引っかかるのは、残った2割の中身が2種類にはっきり割れていたことでした。
1: 正解の断片を返す。
hvac と答えるべきところで ac や air だけを出す。
惜しいというより、有効なカテゴリ名として成立していない出力です。
2: 意味の近いカテゴリと混ざる。
fountain、water heater、pool という水がらみの3つが互いに入れ替わります。
1のほうは後処理で正規化すれば潰せます。
ただしカテゴリが増えるたびに対応表が伸びる。
だったら出力の形式そのものを変えたほうが早い、という判断です。
ラベルを意味のない2文字コードに置き換えたら、92%まで伸びました
やったことは単純で、18個のカテゴリをアルファベット順に AA から RR まで振り直しただけです。
KK が hvac、QQ が water heater。
順番に振っただけですが、コードの側にカテゴリの意味は一切残っていません。
この状態で学習し直すと、正答率は0.916まで上がりました。
効いた理由は2つあると考えています。
出力が常に2文字で固定されるので、生成が途中で崩れる機会そのものが減る。
そしてどのコードも他のコードの接頭辞にならないので、ac のような「正解の一部」が出てくる余地がない。
断片を返すという失敗が、設計上できなくなっています。
92%になっても、water heaterをpoolと間違える誤りは消えませんでした
残った誤りは11件。
内訳を見ると、偏りがはっきりしています。
water heaterpoolguttersmosquitomosquitogarden lightsfountainpool11件のうち7件が水がらみです。
しかも water heater の6件は全部、質問文に「tankless」という語が入っているタイプでした。
「tankless water heater」と明示的に書いてある質問まで pool に流れています。
ラベルをコードに変えても、この誤りは1件も減りませんでした。
当然といえば当然で、変えたのは出力側の表現だけだからです。
質問文の側にある「水」「配管」「加熱」といった特徴の重なりは、何も動いていない。
ラベル設計で消せるのは、出力の形式に起因する誤りです。
入力の意味的な曖昧さに起因する誤りは、そのまま残ります。
6カテゴリならラベル名のままで100%、18カテゴリとの差はどこにあるか
gemma-3n-E2B の4bit版で、問い合わせを「請求・支払い」「技術サポート」など6カテゴリに分類したケースでは、日本語のラベル名をそのまま出力させて75%から100%に到達しています(Zennの実験記事)。
ここではコード化は必要ありませんでした。
差はカテゴリの数と、カテゴリ同士の距離です。
6個で、しかも請求と技術サポートのようにはっきり分かれているなら、ラベル名がそのまま識別子として機能します。
18個あって、うち3個が水まわりなら機能しない。
自分の分類タスクがどちらに転ぶかは、2点を見れば見当がつきます。
1: カテゴリ名が互いの部分文字列になっていないか。
water heater と heater、sales と presales のような関係があると、断片がそのまま誤答として通ってしまいます。
2: 人間が読んでも迷う組み合わせが混ざっていないか。
ここが重なっているうちは、ラベルをコードにしても数字は動きません。
分類の精度が伸びないとき、最初にやるのはデータを足すことでもモデルを大きくすることでもなく、誤答を「形式の誤り」と「意味の誤り」に分けて数え直すことだと思っています。
前者はラベルの書き方で消える。
後者はカテゴリの切り方から見直す話になります。
同じ2割でも、打つ手はまったく別物です。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 2
- 0
-
 gen
- 1
- 0
-
- 4
- 0
-
- 2
- 0
-
- 3
- 0
-
gen
- 4
- 0
-
gen
- 2
- 0
-
- 5
- 0
-
プロンプト画伯
- 6
- 0
-
- 2
- 0
-
gen
- 6
- 0
-
- 6
- 0
-
gen
- 9
- 0
-
gen
- 8
- 0
-
- 5
- 0
-
gen
- 10
- 0
-
- 6
- 0
-
gen
- 9
- 0
-
- 8
- 0
-
gen
- 9
- 0
- もっとみる



コメント
ログイン か 会員登録 するとコメントできます