
1か月半ぶりにOrca(stablyai)のリポジトリを開いたら、スターが20,759から59,240になっていました。
正直、二度見しました。
ただ、この1か月半で大きかったのは数字ではなく、複数のAIエージェントを並走させる運用に完全に移してから、自分が何を判断しているかが変わったことです。
併用に切り替えると何の力が問われるのか、この伸びに今から乗るべきなのかを書きます。
Orca(stablyai)のスターが1か月半で2.9倍に増えました
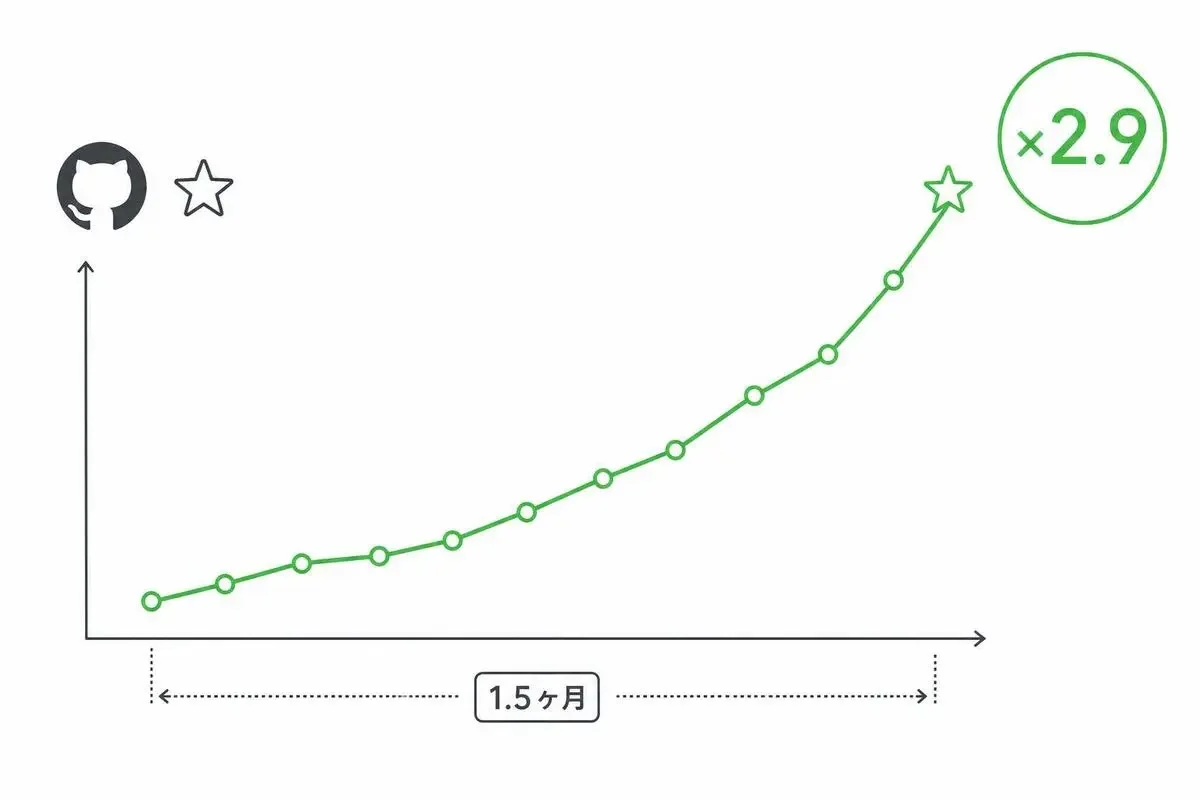
9月2日時点の実測で、スター59,240、フォーク4,007、Open Issue 5,066。
7月17日に確認したときはそれぞれ20,759、1,502、1,577だったので、47日でスターは約2.9倍、フォークは約2.7倍です。
数字だけ見ると、かなり異常なペースです。
2026年8月11日にはGitHubトレンドのTypeScript部門で1位も取っていました。
リポジトリが作られたのは3月17日です。
まだ半年経っていません。
ただ、ここまでの数字は「見に行く理由」にはなっても「乗る理由」にはなりません。
私が実際に運用を切り替えたのは、数字とは別のところが決め手でした。
ターミナル側で並列させる運用からOrcaに乗り換えて、変わったのは頭の使いどころでした
それまでは cmux を使っていました。
エージェントごとにタブを分けて走らせるタイプの構成で、これはこれで普通に回っていたんです。
乗り換えのコストが低かった理由は単純で、動かすエージェント自体はClaude CodeやCodexなど自分の契約のまま変わらず、変わるのは束ね方だけだからです。
面白かったのはその先でした。
ターミナル側で並べていたときは、どのタブでどのブランチを触っているかを常に頭に置いておく必要がありました。
複数の会議を掛け持ちして、今どの話をしていたか一瞬わからなくなる感覚に近いかもしれません。
そこに脳のリソースを持っていかれていたんです。
束ねる仕事をツール側に渡すと、空いたぶんが丸ごと「返ってきた2つ以上の実装をどう裁くか」に移ります。
複数エージェント併用の摩擦は、操作の手間にあるのではありません。
タスクの切り分け方と、レビューをどの順番でやるかにあります。
複数のAIコーディングエージェントを併用すると、どの判断力が問われるのか
併用にすると、指示を書く力の重要度は相対的に下がります。
同じ仕様を2つに投げれば、少なくとも片方はそれなりのものを返してくるからです。
プロンプトを磨いて1発で当てにいく必要が薄れる。
代わりに立ち上がってくるのが、返ってきたコードを読んで「どちらを捨てるか」を決める力です。
しかもこれ、動くかどうかでは決まりません。
だいたい両方動くので。
料理で言えば、レシピを書く技術より、2皿を食べ比べて狙い通りの方を選ぶ舌の方が問われる感覚に近いです。
見ているのはこのあたりです。
- 既存コードの書き方と揃っているか
- テストがどこに置かれ、何を守っているか
- 3か月後に別の人が直せる形になっているか
どれも派手さはありませんが、効いてくる基準です。
ここで効くのが、比較の基準をテストに寄せるやり方です。
実装より先にテストだけを両方に書かせて、そのテストを読み比べてから実装に進ませる。
すると比較の軸が「どちらのコードが好みか」ではなく「どちらのテストの立て方が仕様を正しく捉えているか」に変わります。
好みが判断から外れるだけで、決めるのがかなり楽になりました。
たとえば最近やってる案件で、既存の集計処理にキャッシュ層を挟むタスクを、Claude CodeとCodexの2つに投げたことがあります。
片方はサービス層に、もう片方はクエリの手前に置いてきて、どちらも動きました。
分かれたのはテストです。
片方は「キャッシュが効いていること」を守り、もう片方は「元データが更新されたときに古い値を返さないこと」を守っていた。
残したのは後者です。
コードを書く時間が減って、コードを読む時間が増えました。
この移動が併用の本当の変化です。
実感できるかどうかが、そのまま向き不向きの分かれ目になります。
ただ、これでどんなタスクでも並走させればいいという話にはなりません。
読み比べにはちゃんとコストがかかります。
1つのエージェントに絞るか複数を並走させるか、使い分けの分かれ目はタスクの性質です
分かれ目は2点です。
そのタスクの正解が1つに決まるかどうかと、返ってきた2案を読み比べる時間が自分にあるかどうか。
この2点で、1つに絞るか複数を並走させるかを使い分けています。
1つに絞る派の言い分はまっとうだと思っています。
ルールを書いたmdファイルを育ててプロジェクト固有の癖を覚えさせていく作り込みが効くのは、文脈が1本に積み上がる運用の方です。
並走させるとその蓄積は作業ツリーごとに薄まります。
あと、5分で終わる修正を2本に投げるのは普通に損です。
読み比べる時間の方が高くつきます。
Open Issueが5000件を超えました、伸びに運用は追いついているのか
Open Issueは1,577件から5,066件へ、約3.2倍になりました。
スターの伸び(2.9倍)を上回っています。
ただ、これをそのまま品質の問題として読むのは乱暴です。
Issue数はバグ数ではなく、機能要望も質問も重複報告も同じ数字に混ざります。
ユーザーが3倍になれば自然に増えます。
危ないのは絶対数ではなく、増える速度に対して捌ける速度が追いついているかどうかの方です。
私が見ているのは3点だけです。
- 直近のIssueにメンテナの反応が付いているか
- リリースの頻度が落ちていないか
- 破壊的変更の告知が事前に出ているか
このどれかが崩れ始めたら、成長より運用の疲弊が先に来ているサインだと考えています。
今はまだ荒削りな時期のツールで、そこは織り込んで触った方がいいです。
急成長しているOSSツールに今から乗る前に、確認しておくこと
スターの数が意味しているのは「多くの人が試した」ことだけです。
試したあとも使い続けられているかは別の数字で、そこは自分の環境で測るしかありません。
開発元は小規模なスタートアップで、スター6万に対して手を動かせる人数が釣り合っていない構図はリスクとして頭に置く必要があります。
そのうえで、次の2点を確認しておきます。
破壊的変更に、自分のワークフローが耐えられるか
公開から半年経っていないツールは仕様が動きます。
動いたときに壊れるのは、そのツールに合わせて自分が作り込んだ部分です。
設定を固めて手順書に落とし、チーム全員をそこに乗せたあとで仕様が変わると、被害が人数分に増えます。
まずは自分1人の作業で1〜2週間回してみる。
壊れても自分だけが困る範囲に留めておく。
逆に、タスクを投げて差分を見るだけの浅い使い方なら破壊的変更の影響はほとんど受けません。
乗るなら浅く乗るのが安全です。
やめるときのコストを、先に測っておく
乗るかどうかより先に、降りるときのコストを見た方が判断は速くなります。
基準は1つです。
作業の成果物が、そのツールの中にしか残らない形になっていないか。
Orcaの場合、走らせた結果はブランチとコミットとして普通のリポジトリに残ります。
使うのをやめても手元に残るものは変わらないので、撤退コストはほぼゼロです。
コンテナを1つ立てて、合わなければ壊す。
それに近い感覚です。
撤退コストがゼロに近いツールは、判断を先延ばしにする理由がそもそもありません。
試して合わなければ消せばいいだけです。
Orca(stablyai)に乗るか様子見か、判断材料は数字の伸びではありません
冒頭の59,240という数字は、リポジトリを見に行く理由にはなります。
ただ、乗る理由にはなりません。
判断材料はこの3つに絞っています。
- 設計判断が分かれるタスクが週に何本あるか。ゼロなら併用の価値はほぼない
- 返ってきた2案を読み比べる時間を取れるか。取れないなら1本に絞る方が速い
- 成果物が普通のブランチとして残るか。残るなら試すコストは実質ゼロ
このうち、成果物がブランチとして残るかどうかについては、Orcaに関してはすでに答えが出ています。
走らせた結果は普通のブランチとコミットとして残るので、試すだけなら失うものはほとんどありません。
残る2つは、自分の手元のタスクに当てはめて考えるだけです。
数字が伸びているうちに触っておく、ではありません。
この3点が揃ったときに触る。
それだけです。
- 5
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
- 5
- 1
-
- 5
- 0
-
AI脱社畜
- 5
- 0
-
 gen
- 1
- 0
-
- 2
- 0
-
gen
- 4
- 0
-
- 4
- 0
-
 たく
- 6
- 0
-
gen
- 1
- 0
-
- 4
- 0
-
たく
- 2
- 0
-
gen
- 3
- 0
-
 ゆい@海外AI副業ラボ
- 3
- 0
-
- 4
- 0
-
- 2
- 0
-
gen
- 2
- 0
-
- 3
- 0
-
gen
- 5
- 0
-
- 3
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます