
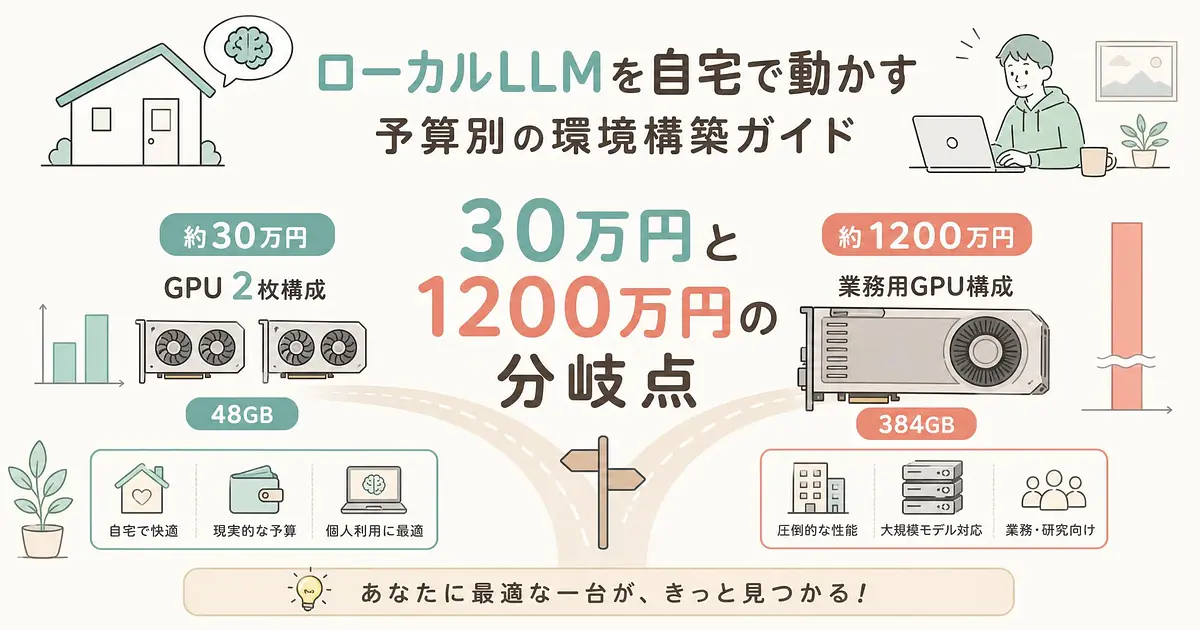
48GB VRAMのローカルLLM機は2,000ドル、つまり30万円あれば組める。
海外の構成例はだいたいこの前提で書かれています。
同じ構成を国内の実勢価格で見積もり直したら、50万円を超えました。
差はまるごとGPUで生まれています。
この開きを知らずに海外のガイドを真似ると、パーツを買い揃えた時点で予算が破綻します。
48GB構成、RTX 3090を2枚積むと日本では50万円を超えます
48GBという数字は RTX 3090 の24GBを2枚重ねて作ります。
ここはどの構成例も共通です。
崩れるのは値段のほうで、2026年9月時点の中古相場は1枚あたり14万円から20万円。
半年で2倍以上に跳ね上がっています。
メモリ価格の高騰とRTX 50系の品薄が同時に来た結果です。
GPUだけで30万円から40万円。
マザーボード、CPU、電源、ケースを足すと50万円台に着地します。
2,000ドルという前提はもう国内では成立しません。
しかも RTX 3090 はマイニングブームをまるごと通過した世代で、中古市場に出回っている個体の多くが酷使されています。
保証のある中古専門店で買うか、ファンとVRAM温度を確認できる出品だけを狙うか。
ここをケチると1枚が数万円安くなる代わりに、半年後にVRAMエラーで詰みます。
見返りははっきりしています。
48GBあれば Qwen3.6-27B が余裕を持って載ります。
FP8版で30.9GBなので、KVキャッシュに十分な余白が残る計算です。
このモデルはSWE-bench Verifiedで77.2、Terminal-Bench 2.0で59.3。
27Bの密モデルが、15倍近いパラメータを持つ Qwen3.5-397B-A17B のスコアを上回っています。
ライセンスもApache 2.0で、重みをそのままダウンロードできます。

384GB構成、RTX PRO 6000 Blackwellを4基並べると1200万円を超えます
桁がひとつ変わる構成です。
RTX PRO 6000 Blackwell は1枚96GB。
4基で384GBになります。
海外の構成表ではGPU4枚で46,000ドル、約690万円と書かれています。
ところが国内の価格比較サイトで拾える最安は1枚299万円で、取扱いは3店舗のみ。
4枚買うと約1,200万円です。
倍近い開きがあります。
土台側は意外と現実的な値段です。
マザーボードは ASRock Rack ROMED8-2T(PCIe 4.0 x16が7本)で715ドル、CPUは16コアのEPYC 7313Pで504ドル、DDR4のECC RDIMMを128GB、電源は1700Wを2台、NVMeを合計20TB。
GPUを除いた合計は5,700ドル、約85万円に収まります。
そして、これが日本で組むときの最大の罠なんですが、電気が足りません。
RTX PRO 6000 Blackwell のWorkstation Editionは1枚あたり600W。
4基で2,400Wです。
日本の家庭用コンセントは100Vの15Aが標準で、上限は1,500W。
CPUやファンを足す前の段階で、すでに1本の回路には収まりません。
回避策は2つあります。
エアコン用のような200V回路を引くか、消費電力を300Wに抑えた Max-Q 版を選ぶか。
Max-Qなら4基で1,200Wなので、100V回路でもぎりぎり戦えます。
海外のガイドは200V圏を前提に書かれているので、この計算はどこにも書いてありません。
384GB積んでもGLM 5.2はそのままでは載りません
ここがいちばん誤解されているところです。
384GBというVRAMは、フロンティア級のオープンウェイトモデルを素で動かすには全然足りません。
GLM-5.2 は総パラメータ753B、アクティブ40BのMoEで、1層あたり256エキスパート。
これをBF16で素直に載せると1.5TBのVRAMが要ります。
384GBでは4倍足りない計算です。
では4基構成で何が動いているのか。
GLM-5.2-Int8Mix-NVFP4-REAP-594B という、削るだけ削った派生版です。
削り方が2段構えになっています。
まずREAP(Router-weighted Expert Activation Pruning)でエキスパートそのものを間引いて、753Bを594Bまで落とす。
ルーターのゲート値とエキスパート出力のノルムの両方を見て、貢献の薄いエキスパートから外していく手法です。
論文の主張ではエキスパートを50%以上削っても生成品質の低下は8%未満とされています。
その上からNVFP4とInt8の混合量子化をかけます。
NVFP4はBlackwell世代がハードウェアで直接扱える4bit浮動小数点で、符号1bit、指数2bit、仮数1bitのE2M1構造。
これをFP8スケールのブロック単位でスケーリングして精度を稼ぎます。
Blackwellを選ぶ理由の半分はこのフォーマットにあります。
結果として、460kコンテキストで約80トークン毎秒。
数字だけ見ると自宅にフロンティアモデルが来たように見えます。
ただし、ここは冷静に区別してください。
ベンチマークで公開されている GLM-5.2 のスコアは、フル精度の753B版のものです。
手元で回っているのは、エキスパートを間引いて4bitまで潰した別物になります。
「4bit量子化はロスレス」という言い方をよく見ますが、長いコンテキストのコーディングタスクでは8bitや16bitとの差がはっきり出ます。
llama.cppとOllamaとvLLM、48GBと384GBで正解が変わります
ランタイム選びは、VRAM量ではなく「何人で使うか」で決まります。
llama.cpp はC++製の推論エンジンで、VRAMに載り切らない分をCPUとRAMに逃がせるのが強み。
単発リクエストのトークン毎秒はこれが一番出ます。
Ollama は llama.cpp をラップして扱いやすくしたものです。
セットアップの速さは断トツで、コマンド1本でモデルが落ちてきて動きます。
ひとりでチャットするだけなら、これ以上の選択肢を探す必要はありません。
vLLM の本体は継続バッチングです。
単発だと llama.cpp に勝てませんが、同時リクエストが増えるほどスループットが伸びていきます。
10並列も投げれば、単発の数倍まで持っていけます。
なので48GB構成をひとりで使うなら Ollama か llama.cpp。
384GB構成をチームにOpenAI互換APIとして開放するなら vLLM です。
GLM-5.2級のMoEを4基に分散させるなら、実質 vLLM 一択になります。
動かないときに疑うのはコードよりBIOSとカーネルです
マルチGPU構成で最初に踏む罠は、ほぼ全部この2箇所にあります。
推論スクリプトを書き直す前にこちらを見てください。
BIOS側で触るのは5つです。
GPUを挿したスロットのリンク幅をx16に固定する(Autoのままだとx8とx8に割れます)、リンク速度をGen4に固定する、ASPMを無効、Re-Size BARを有効、SR-IOVを無効。
カーネル側は /etc/default/grub に次を書きます。
GRUB_CMDLINE_LINUX="iommu=off amd_iommu=off nomodeset"それとNVIDIAドライバのモジュール設定に1行。
options nvidia_uvm uvm_disable_hmm=1iommu=off が入っていないと、マルチGPUのP2P通信でNCCLがハングします。
IOMMUが有効な状態だとPCIeのポイントツーポイント通信がCPUのルートコンプレックス経由に迂回させられるためで、AMD EPYC環境では昔から知られている挙動です。
速度が落ちるだけでなく、そのまま固まります。
Re-Size BARとAbove 4G Decodingは2枚構成でも効きます。
48GB機を組む人も、ここだけは先に有効化しておいてください。
予算から逆算するとどこに手をつけるか
真ん中の帯は本当に情報がありません。
GPU2枚と4基の中間、つまり RTX PRO 6000 を1枚から2枚という構成について、まとまった実測を公開している人をほとんど見かけないんです。
ここは今から入る人にとってはチャンスでもあります。
最初の一歩としては、RTX 3090 を1枚から始めるのが現実的です。
24GBでも27B級のQ4量子化は動きますし、そこでBIOSとRe-Size BARの勘所を掴んでおけば、2枚目を挿したときに詰まる場所が半分になります。
1枚15万円前後という値段は決して安くないですが、フロンティアモデルのAPI課金を毎月払い続ける金額と比べれば、回収できる範囲には収まります。
- 4
- 0
Claude Code / Cursor / Codex を毎日触る若手Webエンジニア。新ツールの実況・比較・アンチパターンを深夜テンションで書きます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 2
- 0
-
 gen
- 1
- 0
-
- 4
- 0
-
- 2
- 0
-
- 3
- 0
-
- 3
- 0
-
gen
- 2
- 0
-
- 5
- 0
-
プロンプト画伯
- 6
- 0
-
- 2
- 0
-
gen
- 6
- 0
-
- 6
- 0
-
gen
- 9
- 0
-
gen
- 8
- 0
-
- 5
- 0
-
gen
- 10
- 0
-
- 6
- 0
-
gen
- 9
- 0
-
- 8
- 0
-
gen
- 9
- 0
- もっとみる


コメント
ログイン か 会員登録 するとコメントできます