
音声AIエージェントの料金ページを開くと、たいてい単価だけが書いてあります。
知りたいのはそこではなくて、「この通話、放っておいたらどこまで行くのか」のほうですよね。
その天井がどこにもありません。
5分の通話で、トークンが燃え尽きた話
添付されているのは5分04秒の通話音声で、相手側の音声AIがひたすら喋り続けています。
投稿に添えられた中国語は「一个电话给人token烧没了」、日本語にすると「1本の電話で人のトークンが全部燃え尽きた」。
12.1万表示まで伸びていて、リプライには
- 「AIってほんと執着心が強いよね」
- 「この程度ならもうかなり本物っぽい」
- 「これからもっと似てくるよ」
といった反応が並んでいます。
相手が聞いているかどうかを1ミリも疑わないまま、5分間しゃべり切るわけです。
人間の営業電話なら「あと1分だけお時間よろしいでしょうか」という遠慮が挟まるところを、疲労も気まずさもない存在が完走してくる。
粘りの単位が人間と違いすぎてわらってしまいました。
音声AIエージェントは、黙るまで課金が止まりません
笑っていられるのは、受け手側に立っている間だけです。
同じ5分04秒を「自分が組んだエージェントの通話ログ」として眺めると、これは請求書になります。
ここで温度が一気に下がる。
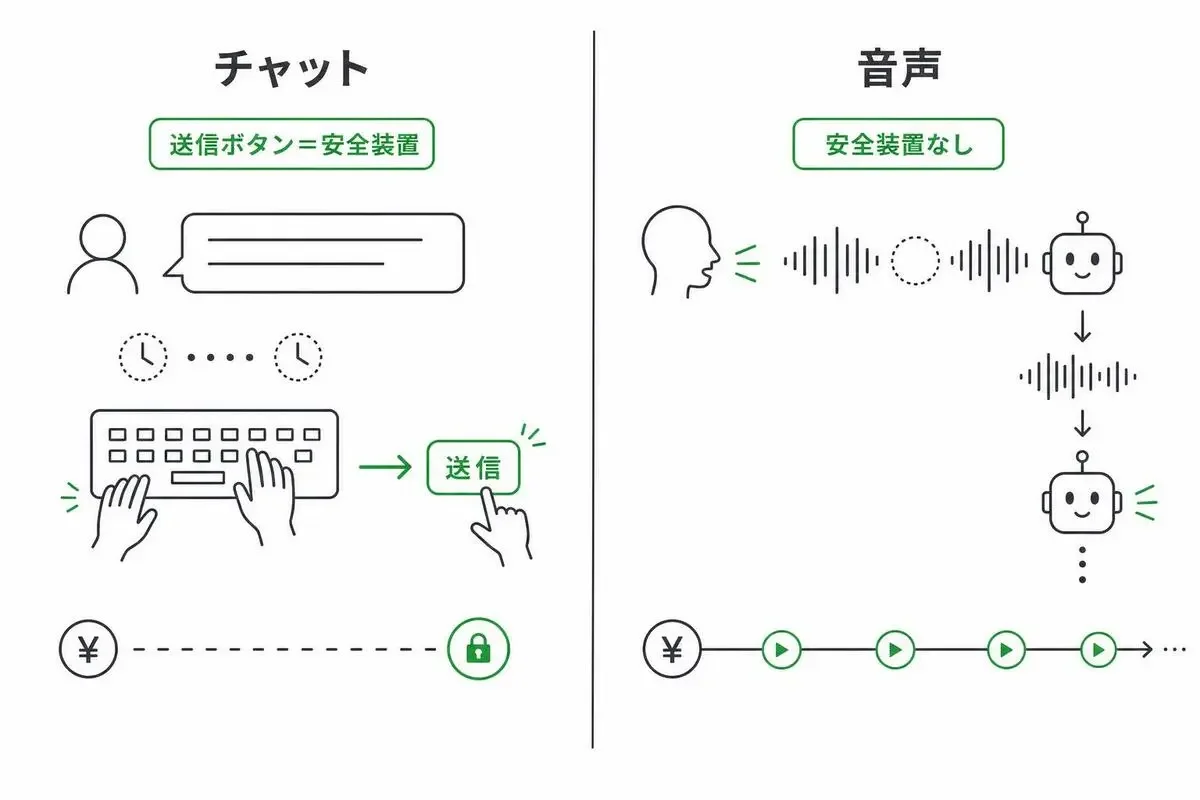
チャット型のLLMアプリには、無料の安全装置が付いています。
人間が送信ボタンを押すまで1円もかからない、という構造です。
タイピング速度と考える時間が、そのままレートリミッタとして働いている。
ところが音声エージェントにはそれがありません。
発話の切れ目を検知したら即座に次を生成しますし、相手が黙っていても設定次第では自分から喋り出します。
つまり1通話のコストを決めているのは、自分が書いたコードではなく通話相手の気まぐれです。
ここは正直きつい。
私が音声まわりで一番警戒しているのはモデルの精度ではなく、この「上限を他人が握っている」構造のほうです。
会話が長引くと、なぜ過去の発言まで毎回課金されるのか
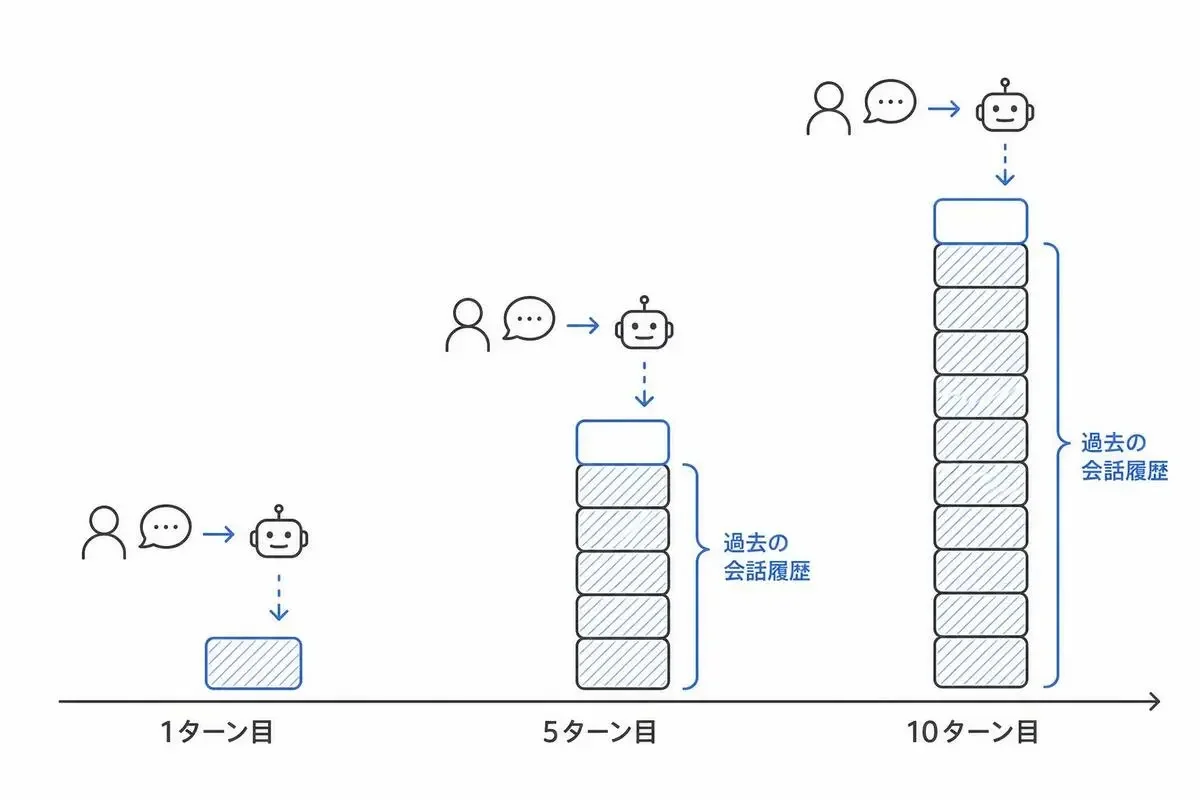
LLMはターンごとに、それまでの会話履歴をまとめて入力として受け取ります。
5ターン目の入力には1から4ターン目までの発話が全部入っていますし、10ターン目にはその倍が入っている。
入力トークンは通話時間に比例して増えるのではなく、ターンが進むほど加速して積み上がります。
だから5分の通話は、1分の通話の5倍では済みません。
感覚としては、通話が長引くほど1ターンあたりの単価が上がっていくようなものです。
ここが料金ページの単価表からは読み取れない部分で、実際に走らせてみて初めて請求額に出てきます。
救いはキャッシュ割引です。
OpenAIのRealtime APIの料金表を見ると、直前と同じ履歴部分を再送するときの単価が桁違いに安くなっています。
gpt-realtime-2.1 の場合、音声入力が100万トークンあたり約4,800円なのに対し、キャッシュ済み入力は約60円です。
ただ、これは単価の話であって累積構造そのものは消えません。
私はむしろ、キャッシュがあるから大丈夫と読むほうが危ないと思っています。
安くなった分だけ長い通話を許してしまって、結局トータルが伸びる。
割引は設計の代わりにはならないです。
OpenAI、Gemini、ElevenLabsで課金の単位が違います
各社の料金を並べると、「どこが安いか」より「どの単位で膨らむか」がバラバラなことのほうが効いてきます。
OpenAIはトークン単位です。
gpt-realtime-2.1 で音声入力が100万トークンあたり約4,800円、音声出力が約9,600円。
出力が入力の倍なので、AIが喋れば喋るほど効いてきます。
冒頭の5分04秒は、この方向に振り切った例です。
Geminiもトークン単位ですが、分あたりの換算値も併記されています。
gemini-3.1-flash-live-preview で音声入力が100万トークンあたり約450円、または1分あたり約0.75円。
音声出力が約1,800円、または1分あたり約2.7円です。
公式が音声1秒あたり25トークンという換算を示しているので、時間から見積もりを立てやすい。
ただし入力と出力で換算レートが違うという報告もあるので、正確に詰めるなら自分の構成で実測したほうが早いです。
ElevenLabsは通話分数そのもので課金します。
1分あたり約12円で、同時接続数の上限を超えた分はバースト扱いになり約24円になります。
ただしLLMと電話回線の費用は別請求なので、ここだけ見て総額を判断すると足が出ます。
全部込みで1分いくらという見せ方をしているのはRetell AIのほうで、構成により1分あたり約10.5円から約46.5円で、公式が代表例として挙げている構成は1分あたり約16.5円です。
整理すると、トークン単位は喋った量に正直な代わりに上振れの天井が読めません。
分単位は天井が読める代わりに、相手が黙り込んでいる無の時間にも律儀に課金されます。
沈黙に金を払っている感覚はなかなか新鮮で、電話口で「あー、えーっと」と悩まれるたびにメーターが回る。
予算を先に決めたいなら、それでも分単位のほうが扱いやすいです。
音声エージェントの暴走を止める設計は、3か所に置けます
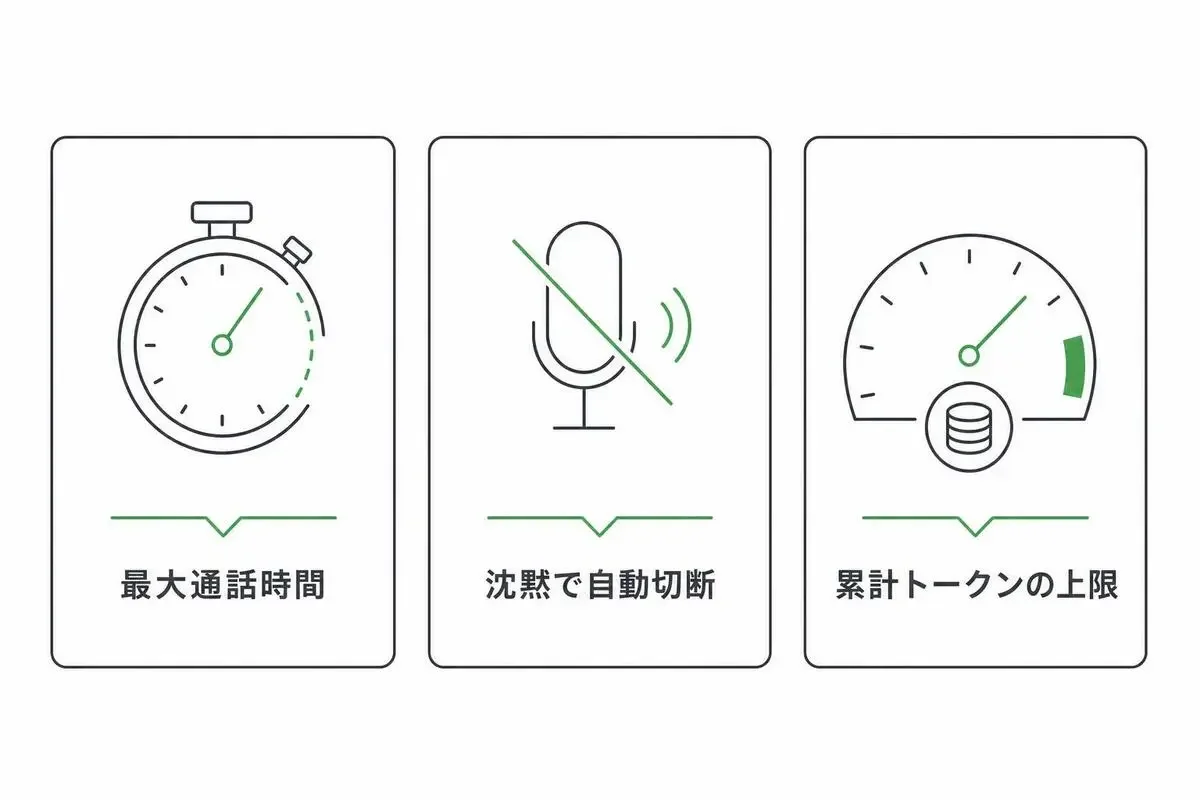
モデル側に「長くなりすぎたら自分で止まる」機能を期待しても、まず止まりません。
止めるのは呼び出し側の仕事です。
最大通話時間で、問答無用に切る
セッション開始時刻を持っておいて、上限を超えたらこちらから切断します。
MAX_CALL_SECONDS のような値を1つ持つだけで、1通話の最大コストが確定するのが大きい。
用途にもよりますが、問い合わせ対応なら3分から5分で足ります。
置かないとどうなるかは冒頭のとおりです。
相手が黙って放置しただけで通話が生き続け、その間ずっと履歴が積み上がります。
沈黙が続いたら自動で切断する
最大通話時間だけだと、無言の回線を上限いっぱいまで保持してしまいます。
そこで無音が一定秒数続いたら切る判定を別に持ちます。
人間の会話の間としては3秒から5秒あたりが自然で、10秒黙っているならもう誰もいません。
スマホをポケットに入れたまま席を立った相手に、こちらのAIが誠実に待機し続けている絵は、けっこう切ないものがあります。
ここで気をつけたいのは、沈黙を「もう一度話しかけるトリガー」にしないことです。
呼びかけを1往復足すたびに履歴が増えて、単価の高いほうの出力トークンを使います。
しかも誰もいない部屋に向かって「もしもし、聞こえていますか」を繰り返すエージェントは、冒頭の5分04秒と同じ道を歩き始めています。
再呼びかけは1回まで、次は切る。
それくらいで足ります。
予算アラートは、事後ではなく事前に置く
各社のダッシュボードにある使用量アラートは、超えてから通知が飛びます。
検証中ならそれで構いませんが、本番の電話番号に載せるなら、アプリ側で1通話ごとの累計トークンを数えて上限に達したら切る仕組みを持ったほうが確実です。
事後アラートは「昨日いくら使ったか」を教えてくれますが、走っている通話は止めてくれません。
止める権限を持っているのは自分のコードだけです。
私が音声エージェントを組むなら、最初にこれを決めます
最初に決めるのはモデルでもプロバイダーでもなく、「1通話あたりいくらまで許すか」の1つの数字です。
仮に30円と置いたなら、そこから逆算して通話時間の上限が出ますし、その時間で収まるモデルと課金単位が絞られます。
この順番でやると料金ページの比較がかなり楽になります。
逆に、モデルから選んで後からコストを心配する順番だと、単価表を何度見比べても「で、1通話いくら」の答えが出ません。
冒頭の5分04秒を他人事として笑えるかどうかは、この数字を先に決めてあるかどうかで決まります。
今日やるなら、既存の実装に最大通話時間の上限を1つ足すところからで十分です。
数字を1つ置くだけで、請求書の上限がこちら側に戻ってきます。
- 5
- 1

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
プロンプト画伯
- 5
- 0
-
コードを読まないAIエンジニア
- 5
- 0
-
- 5
- 0
-
- 3
- 0
-
 さくら
- 4
- 0
-
 nana
- 3
- 0
-
- 3
- 0
-
AI脱社畜
- 5
- 0
-
 gen
- 1
- 0
-
- 2
- 0
-
- 5
- 0
-
nana
- 3
- 0
-
クロージング師匠
- 1
- 0
-
gen
- 4
- 0
-
さくら
- 4
- 0
-
 ゆず
- 5
- 0
-
 このは
- 5
- 0
-
- 4
- 0
-
nana
- 5
- 0
-
 たく
- 6
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます