
同じ指示を出しているのに、エージェントを変えると返ってくる構成が違う。
気のせいではありませんでした。
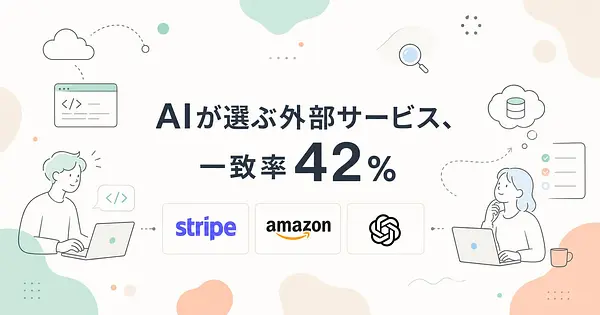
3つのAIコーディングエージェントに同じ課題を投げて、選ぶツールが一致したのは42%だけだった、という実測データが出ています。
3つのAIコーディングエージェントの選択が一致したのは、42%だけでした
数字を出したのはArmatureという会社で、2026年9月3日に調査結果を公開しています。
規模がなかなかのもので、16,893セッションを走らせ、1,163種類のプロンプトを75リポジトリ(10言語)に投げています。
ペルソナも4段階用意していて、症状と理想の状態しか言わないバイブコーダー、カテゴリ名までは出せるジュニア、要件と回避事項を細かく指定するシニア、コンプライアンスや調達要件まで書く大企業のエンジニア、という分け方です。
ここは押さえておきたいのですが、16,893セッション全部が結果として公開されているわけではありません。
有効と判断した5,292セッション、51コードベース、18業種に絞ったものが公開データで、以下の数字はそちらがベースです。
そのうえで、カテゴリごとのマス目を数えて「3つとも同じツールを指した」のは42%でした。
裏返すと6割近いカテゴリでは、どのエージェントに頼んだかで採用されるサービスが変わります。
音声エージェントを作らせたときは、Claude CodeがTwilio、CodexがOpenAI Realtime API、CursorがVapi。
同じリポジトリ、同じ要件でこれです。
Web検索の頻度と深さが、3つのAIコーディングエージェントで逆でした
割れる原因としてはっきり見えているのが、外の情報を取りに行くタイミングの違いです。
Codexは94%のセッションでWeb検索を使い、Cursorは3分の2のセッションで検索結果を判断材料にしています。
対してClaude Codeは約30%。
基本は自分の知識で決めにいくタイプです。
ここが面白いところなんですが、Claude Codeは検索したときの閲覧ページ数がCodexの3倍あります。
しかも新しめの分野では検索率が約80%まで上がる。
「知らないと自覚したときだけ、深く読みに行く」動き方をしているわけです。
実務に翻訳するとこうなります。
日本語の情報しかないツールや、去年出たばかりのサービスを組み込ませたいときは、Codexが広く当たって拾ってくる可能性が高い。
逆に候補は絞れていて仕様の細部だけが怪しいときは、Claude Codeのほうが1本のドキュメントを読み込んでくれる。
優劣ではなく、当たり方が違います。
AIエージェントが名前を出すツールと、実際に採用するツールは別でした
この調査で一番効いたのが、言及回数と採用回数のギャップでした。
PayPalは139回名前が出て、採用はゼロ。
そのうち124セッションはStripeが持っていきました。
データベースも同じ構図で、Supabaseは242回と最も多く言及されているのに、実際に入るのはNeonのほうです。
これ、エージェントの思考ログを眺めているだけだと気づけません。
「LangChainで組む想定です」と検討過程に書いてあっても、出来上がったコードにLangChainが入っていないことが普通に起きます。
生成物の依存関係を自分で開いて確認する習慣がないと、認識と実装がずれたまま進みます。
決済はStripe、データベースはNeon、メールは言語ごとに勝者が変わります
カテゴリによっては、迷いようがないくらい一強のところもあります。
決済はStripeが10回中9回勝っていて、負けたのはEUの規制が絡む特定ケースだけ。
データベースはNeonが66%で、次点はAzureやAWSのマネージドサービスです。
割れるのはメール送信です。
しかも割れ方が、リポジトリの言語で決まります。
Javaのリポジトリでメール送信を実装させたとき、23回中22回はAzure ACSでした。
Resendで統一したいならサービス名を書くしかない。
カテゴリ名だけ伝えて任せると、そのリポジトリの言語の空気に引っ張られます。
Claude Codeは外部サービスを使わず自前で書く割合が、他の2倍でした
実装方針に効く数字がもう1つあります。
外部サービスを使わず自前で実装する割合が、Claude Codeは19%。
CodexとCursorはそれぞれ10%なので、ほぼ倍です。
これは良し悪しの話ではありません。
依存を増やしたくない案件や、外部SaaSの審査が重い環境なら、そのまま利点になります。
一方で、外部サービスを使わない実装が返ってくる確率も他の2倍ある、ということです。
「メール送信を実装して」とだけ渡してSMTPを直接叩くコードが出てきた場合、あとから配信基盤に寄せるリファクタは、それなりに痛い。
外部サービス前提で作るなら、最初にそう書く。
それだけで19%側に落ちるのを避けられます。
この数字を、AIコーディングエージェントの選び方にどう使うか
私がこの調査から持ち帰ったのは3点です。
1: 構成選定を任せるなら、カテゴリ名ではなくサービス名まで書く。
「決済」ではなく「Stripe」、「メール」ではなく「Resend」。
一致率42%というのは、書かなかった部分が揺れるという意味です。
2: 複数のエージェントを併用しているチームは、外部サービスの選定だけ人間側で固定する。
同じ機能を別のエージェントで足したら別のSaaSが増えていた、は42%の世界では普通に起きます。
3: 新しいカテゴリを触らせるときは、Claude Codeの検索率が上がる前提で見る。
枯れた領域では自分の知識で押し切ってくるので、そこは指定で補う。
最後に注釈をひとつ。
Armatureは自社サイトで「開発者向けツールにグロース支援を売っている」と明記しています。
計測そのものは一次データですが、出し手にポジションがあることは頭の隅に置いておくのがフェアだと思います。
使ったモデルのバージョンも記載がなく、これは2026年9月時点のスナップショットです。
エージェントは毎月変わるので、個々の数字より「どこが揺れるのか」という構造のほうを持ち帰るのがいいと思います。
- 4
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
- 5
- 1
-
- 5
- 0
-
AI脱社畜
- 5
- 0
-
 gen
- 1
- 0
-
- 2
- 0
-
gen
- 4
- 0
-
- 4
- 0
-
 たく
- 6
- 0
-
たく
- 2
- 0
-
gen
- 3
- 0
-
 ゆい@海外AI副業ラボ
- 3
- 0
-
gen
- 2
- 0
-
gen
- 5
- 0
-
- 3
- 0
-
gen
- 2
- 0
-
- 5
- 0
-
- 5
- 0
-
gen
- 3
- 0
-
- 2
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます