

モデルの学習は金がかかるから自分では回せない、というのが普通の感覚だと思います。
その線引きが、GPU一枚で崩れました。
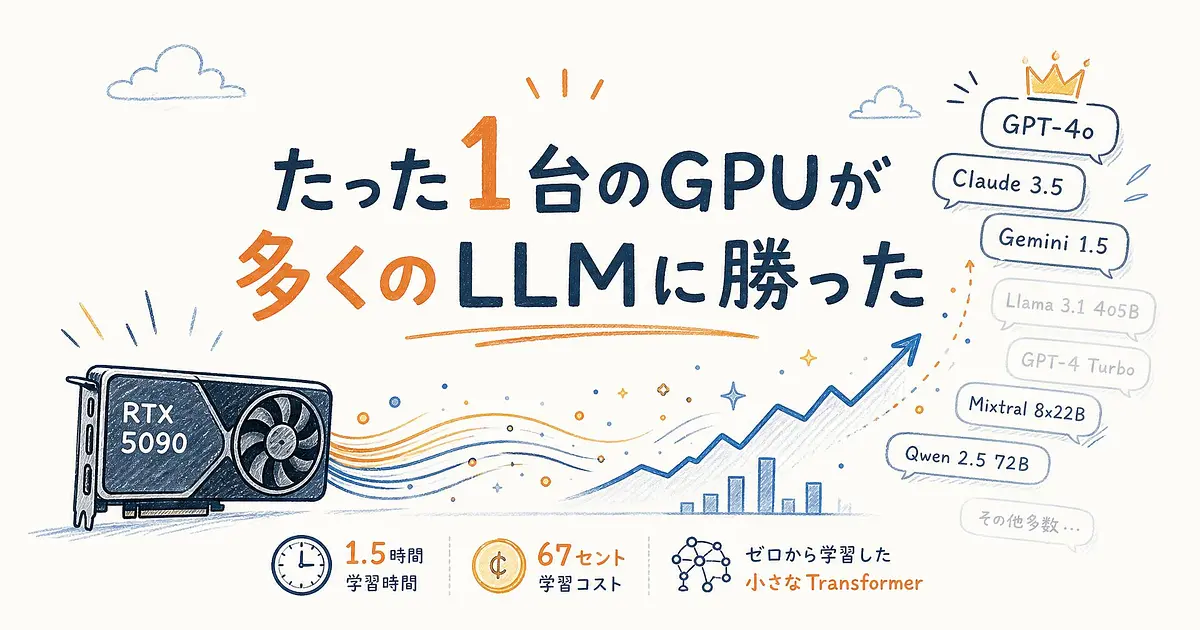
ARC-AGI-1というベンチマークで44%、学習1.5時間、締めて約100円です。
RTX5090一枚で1.5時間、請求は約100円でした
やったのは、インドのバンガロールを拠点に個人で研究しているMithil Vakdeさん。
IIT Bombayを2023年に卒業したエンジニアで、賞金45万ドル、日本円で約6,750万円が懸かったARC-AGI-2のKaggleコンペでは上位5位に入っています。
2026年9月1日、実験の記録がHacker Newsで625ポイントまで伸びました。
数字を並べます。
- ARC-AGI-1の公開評価セットで44%
- 学習時間はRTX5090一枚で1.5時間、リポジトリの記載は2時間
- 学習から全パズルの推論までの総額が67セント、日本円で約100円
そして同じ人の前バージョンと並べると、伸び幅がヤバいです。
前回はGoogle Colabで借りたA100を3時間弱回して27.5%、コストは1.8ドル、約270円でした。
スコアは1.6倍、時間はほぼ半分、コストは4割弱まで落ちています。
コードは全部公開されていて、MITライセンス、251スター、46フォークです。
100円で回せる実験のコードが丸ごと置いてある、という時点で覗きに行く理由としては十分だと思うんですが、本題はここからです。
ARC-AGIが測っているのは知識量ではありません
ARC-AGIは色付きのマス目パズルです。
入力と出力のペアが3つほど提示され、そこに共通するルールを見抜いて、4問目の出力を自分で埋めます。
ARC-AGI-1は全800問で、学習用400問、公開評価用400問、非公開の評価が100問ずつ2セット、という内訳。
大事なのは、これが「知っているかどうか」では解けない設計になっていることです。
ただ、誤解しないでほしいところが1点あります。
44%は世界最高スコアではありません。
OpenAIのo3-previewは非公開の評価セットで、計算量を抑えた設定でも75%、積んだ設定では87%まで出しています。
超えたのは「多くのLLM」であって、最前線の推論モデルではない。
じゃあ何がすごいのかというと、そのスコアに到達するまでに使った学習量とコストの方です。
もう1点、日本語圏で先に広まっている「小型言語モデル(SLM)」の話とは別物なので、そこは混同しないでください。
SLMは大きいモデルを軽くして推論を安く速くする方向の話。
今回は事前学習の知識をまったく持たないモデルを、ゼロから作った話です。
事前学習の知識なしで、どうやって初見のパズルを解くのか。
いちばん面白いのはそこでした。
事前学習で貯めた知識より、その場でパズル列を覚える方が効きました
普通のLLMは、事前学習で世界中のテキストを読んで知識を貯めてから問題に向かいます。
今回のやり方は真逆で、事前学習をゼロにしたうえで、目の前のパズルだけを見てその場でモデルを作ります。
テスト時学習(test-time training)と呼ばれる考え方です。
具体的には、各入出力ペアをトークン列に変換して、小さなTransformerに自己回帰で学習させる。
学習の対象には、学習用パズルだけでなく評価用パズルも含めます。
データ拡張は、色の入れ替えと盤面の回転・反転の組み合わせ。
最後に、生成された候補のうち最頻の2つを解答として提出します。
「それ、テストデータで学習してるだけでは」と思いますよね。
ここは本人も先回りして答えていて、渡しているのは評価パズルの入力だけ、答えのラベルは伏せたままです。
ラベルなしのテスト入力を学習に使う枠組みはtransductive learningと呼ばれていて、統計的学習理論の分野では何十年も前から研究されてきたものです。
ARC-AGIのルール上も認められている範囲に収まっています。
44%が24%に落ちた場所に、この手法の芯があります
何を外すとスコアが崩れるのか、その実験結果がかなり示唆的でした。
- 3D RoPEを外す、約24%
- 3D RoPEを1Dに戻す、約24%
- パズルごとの埋め込みを外す、約24%
- 入力側も学習の対象に含める、約39%
- 学習データをARC-1とConceptARCだけに絞る、約40%
44%が24%まで落ちる、つまり半分近く消えるのが上の3つです。
どれもモデルを大きくする話ではなく、盤面の形をどう表現するかの話でした。
3D RoPEは、2次元グリッドの行と列という座標を、位置情報としてそのまま持たせる仕組みです。
普通のTransformerは文章向けなので、位置を1本の直線として扱う。
マス目を1列に並べ直すと「上下に隣接している」という情報が消えるので、これを縦横のまま扱えるようにしただけで20ポイント動くわけです。
パズルごとの加算埋め込みも同じ発想で、「この盤面はさっきのとは別のルールで動いている」という印を明示的に持たせるもの。
アーキテクチャ自体はかなり素直な作りで、層を4から8に増やし、SwiGLUとRMSNormに寄せ、最適化をAdamWからNorMuonに変えた、くらいです。
パラメータ数は75M。
比較対象として挙がっているTRMは7Mで45%、HRMは27Mで40.3%なので、スコアだけ見れば横並びです。
差が出ているのは、そこに到達するコストの方でした。
ちなみにARC-AGI-2の方は7%です。
難しい側のベンチマークではまだ全然で、そこは本人も認めています。
週末に自分のGPUで追試できる規模になってきました
リポジトリを見た限り、必要なものは驚くほど少ないです。
- RTX5090、A100でも可
- CUDA 12.8以上、できれば13.0以上
- torch / numpy / numba / matplotlib / flash-attn
手順もデータセットを組み立てるスクリプトを2本流して、run_script.py を low / medium / high のどれかで叩くだけ。
手元にRTX5090がなくても、vast.aiで2時間借りれば済みます。
67セントという数字は、まさにその2時間分のレンタル料から出ているものです。
ここ数年、AIの進歩は「モデルをでかくする」「データを増やす」の2軸で語られてきました。
でも今回効いたのは、そのどちらでもない。
75Mという小ささのまま、盤面の表し方を直しただけで20ポイント動いています。
本人はこの延長で、Transformerの枠内なら65%までは行けると見ているそうです。
僕がこの実験から持ち帰ったのは、手元のGPU一枚で仮説検証が回る領域がまだ残っている、という事実でした。
APIを叩いて賢いモデルが降ってくるのを待つ以外にも、やれることはある。
コードは全部揃っているので、週末に一本流してみるところからで十分です。
- 1
- 0
Claude Code / Cursor / Codex を毎日触る若手Webエンジニア。新ツールの実況・比較・アンチパターンを深夜テンションで書きます。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 8
- 0
-
- 5
- 0
-
プロンプト画伯
- 10
- 0
-
 さくら
- 10
- 1
-
- 5
- 0
-
- 2
- 0
-
- 4
- 0
-
- 10
- 0
-
 ゆい@海外AI副業ラボ
- 7
- 0
-
ゆい@海外AI副業ラボ
- 11
- 0
-
- 4
- 1
-
- 3
- 0
-
- 1
- 0
-
- 2
- 0
-
 黒板とAI@直人
- 6
- 0
-
- 6
- 0
-
- 1
- 0
-
- 6
- 0
-
ゆい@海外AI副業ラボ
- 12
- 0
-
さくら
- 4
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます