
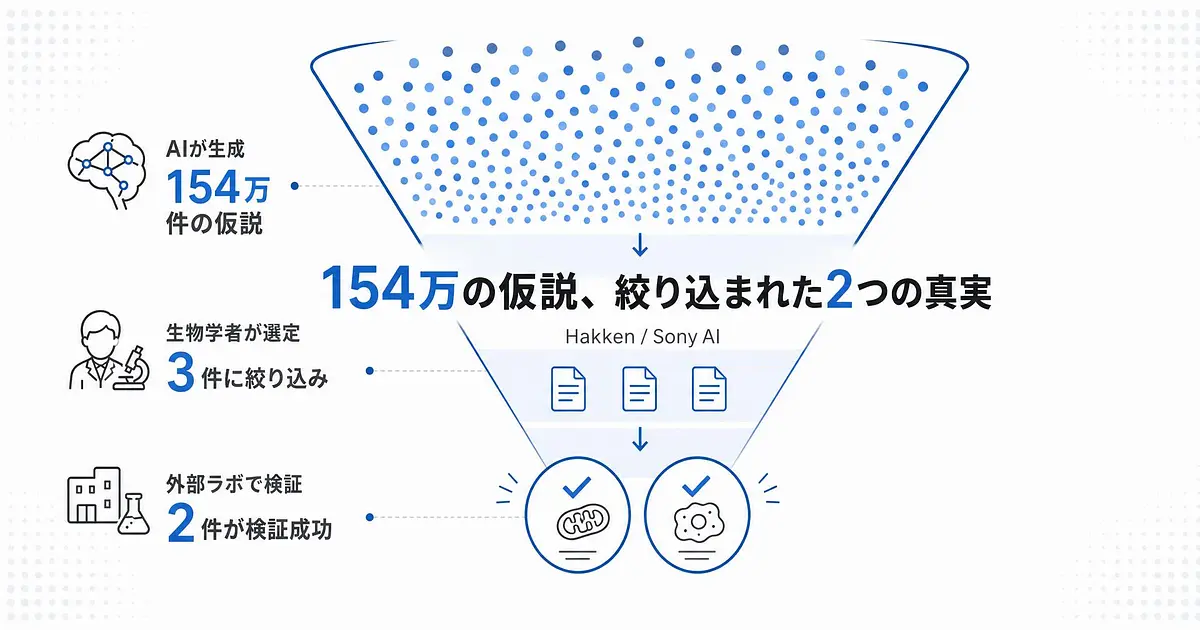
「AIが新しい科学的発見をした」というニュースは定期的に流れてきますが、たいていは「AIが仮説を出しました」というところで話が終わります。
Sony AIが公開した「Hakken」はその先まで進んでいて、出てきた仮説が社外の実験室で実際に試されました。
ただ、この研究で本当に面白いのは154万件という仮説の数のほうではありません。
「Hakken」が生成した154万件の仮説を、生物学者が3件に絞って外部の実験室に渡しました
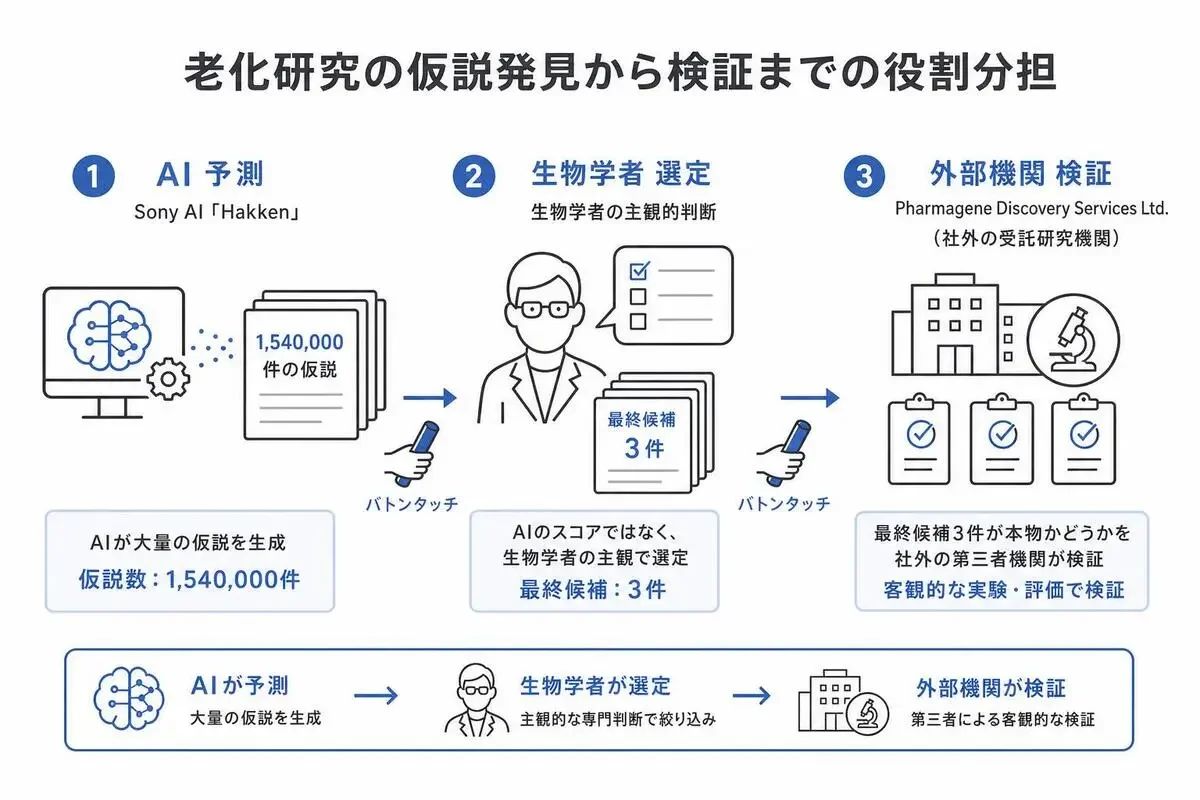
「Hakken」が老化に関わる概念に絞って生成した仮説のうち、確信度の閾値を超えたものは1,543,297件ありました。
桁からして、ちょっと現実的な数字には見えません。
生物学者はこれをバッチ単位で眺めて、興味深いか、自分たちの関心と関係があるかを定性的に評価しました。
そこから3件を選んで、実際の実験による検証に進めています。
検証をやったのはSony AIではありません。
Pharmagene Discovery Services Ltd.という、創薬の受託研究を請け負う社外の会社が実験を担当しました。
結果、3件のうち2件が「実際にそういう関係がある」と確認されています。
154万から3、その3から2。
段階を追うごとに数字が一気に小さくなっていく様子に、絞り込みの厳しさがそのまま表れています。

気になるのは、なぜ「AIのスコア上位3件」ではなく「生物学者が面白いと思った3件」なのかという点です。
閾値を超えた仮説が154万件ある時点で、スコアはもう絞り込みの道具として機能しません。
上位1%まで削っても1万5千件残ります。
だから最後の絞り込みは人間の主観に委ねる、という割り切りが設計に入っています。
検証を社外に投げたのも同じ種類の割り切りです。
予測した組織が自分で検証すると、都合のいい結果だけが残る余地がどうしてもできます。
外に出した時点で、2件という数字の重みが変わります。
AI側の仕事は154万件を出したところまでで、そこから先は人間が握っている。
では、その154万件はどこから出てきたのでしょうか。
過去の論文を年ごとの知識グラフにして、その育ち方を学習させています
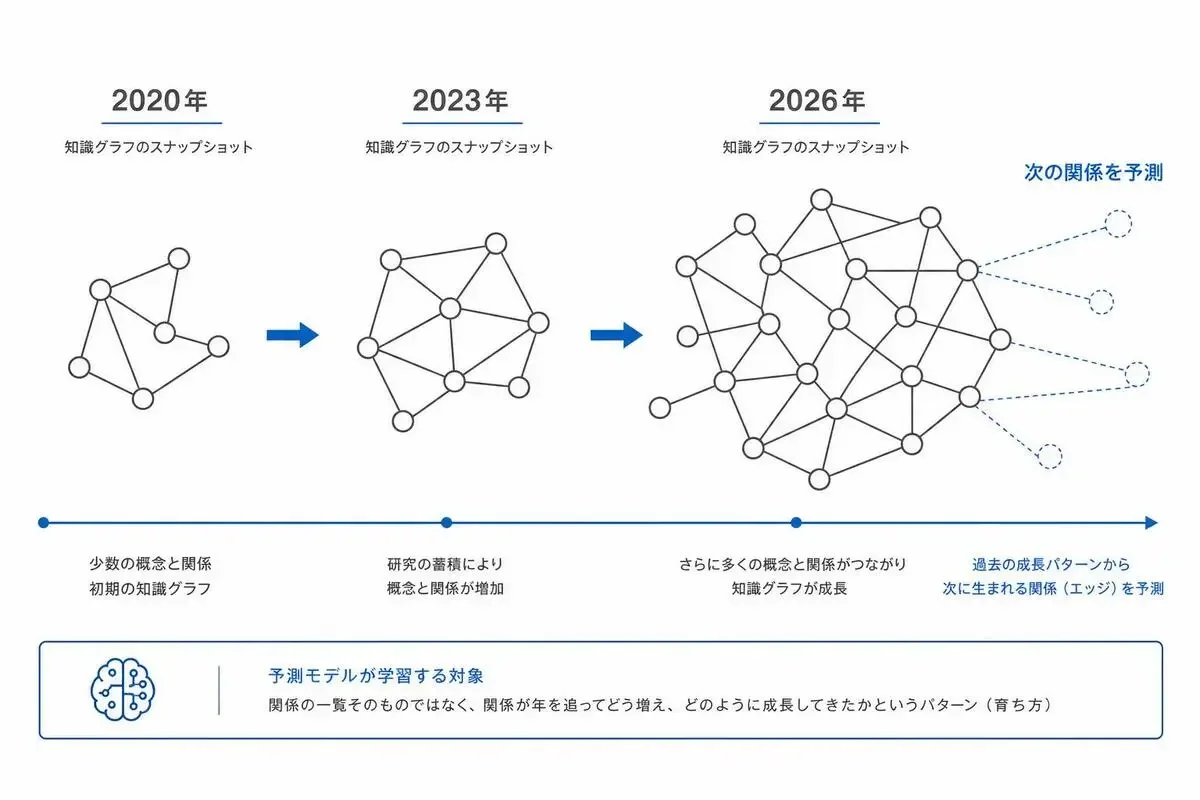
大量の研究論文から概念どうしの関係を抜き出して知識グラフを作り、それを年ごとのスナップショットとして時系列で並べます。
transformerベースの予測モデルに学ばせるのは、そのグラフが年を追ってどう伸びてきたかという育ち方のほうです。
予測しているのは次の単語ではなく、次に張られる辺です。
過去のコミット履歴を全部読ませて、このコードベースが次にどのファイルを触ることになるかを当てにいく、という感覚が一番近いと思います。
「関係の一覧」ではなく「関係の増え方」を学習対象に選んだところが、この仕組みの設計判断の中心にあります。
論文では、時間を考慮した関係予測でベンチマークを更新し、過去のデータで長い期間を予測させても出力が破綻しないことを示しています。
LLMの意味的な知識と組み合わせて、関係の候補を絞っています
グラフの構造だけを見ていると、統計的にありそうな辺は出せますが、それが生物学的に意味を持つかどうかは判定できません。
逆にLLMだけでやると、すでにどこかの論文に書いてあることの言い直しになりがちです。
グラフ側が「まだ誰も線を引いていない場所」を指して、LLM側が「そこに意味があるか」を見る。
この役割分担が仮説の質を決めています。
予測して終わりではなく、根拠になった論文までたどれます
「Hakken」には、予測モデルとは独立した説明の仕組みが用意されていて、予測ごとに根拠となる既存の論文までたどれます。
説明機能をモデルの内部に埋め込まず、外側に分離したという判断が効いています。
予測モデルを差し替えても説明の仕組みは生き残りますし、根拠が出せない予測はそもそも実験に進めるかどうかの判断に使えません。
生物学者が154万件から3件を選べたのは、選ぶための材料が予測に付いてきたからでもあります。
確認されたのはTP53とBAMBI、RAF1とTNFという2つの関係でした
確認された関係の片方は、TP53がBAMBIの発現に影響するというものです。
TP53はヒトのがんで最も変異しやすい遺伝子として知られていて、BAMBIは細胞の増殖や分化に関わるシグナルを調整するタンパク質をコードしています。
細胞が増えていくのか、それとも役割を持った形へと変わっていくのか、その舵取りに関わるタンパク質だとイメージすると近いです。
実験では、P53を誘導するとBAMBIの発現が増えることが確認されました。
TP53にスイッチが入ると、BAMBIも連動して動き出す、というイメージです。
もう片方は、RAF1がTNFの発現を減らす方向にあるというものです。
RAF1は細胞増殖のシグナル伝達に関わる酵素で、TNFは炎症に関わるサイトカインです。
RAF1が「増えろ」の指令を伝える側だとすれば、TNFは体が炎症を起こすときに使う伝達物質です。
こちらはRAF1の阻害剤で細胞を処理したときにTNFのmRNA発現が増えたことで、減らす方向の関係が裏付けられました。
ふだんはRAF1がTNFにブレーキをかけていて、それを外すとTNFが増える、という読み方になります。
「これまで文献に記載がなかった関係」という言い方は、正確に受け取る必要があります。
遺伝子そのものはどれもよく研究されてきたもので、書かれていなかったのは、この2つを直接結ぶ関係のほうでした。
そして確認されたのは、細胞のレベルで観測された発現の変化です。
念のため断っておくと、老化が止まるとか、がんの治療法が見つかったという話ではありません。
H100を16枚で数日、この学習規模は基盤モデルと比べればつかみやすい話です
学習に使われたのは、NVIDIA H100 80GB SXM5を8枚積んだマシンが2台、合計16枚です。
メモリはマシン1台あたり960GB、1回の学習にかかる時間は日単位と書かれています。
大規模な基盤モデルの学習が数千枚のGPUを数か月動かす世界であることを考えると、この規模は想像がつく範囲に収まっています。
個人で手が届く量ではありませんが、少なくとも「国家予算級の計算資源がないと届かない成果」ではありません。
つまり、老化研究の新しい事実に届くのに、フロンティアモデル級の計算は要りませんでした。
この領域のボトルネックは計算資源ではない、と読めます。
では何が壁なのか。
論文の書き方から逆算すると、こうなります。
- 商用ライセンスの文献データ
- 出てきた仮説を実際に試してくれる実験室
どちらもGPUを増やしたところで手に入りません。
そして計算資源が壁でないなら、同じことを考えている組織が他にないはずがありません。
Google DeepMindのCo-ScientistやSakana AIのAI Scientistとは、AIに任せる範囲が違います
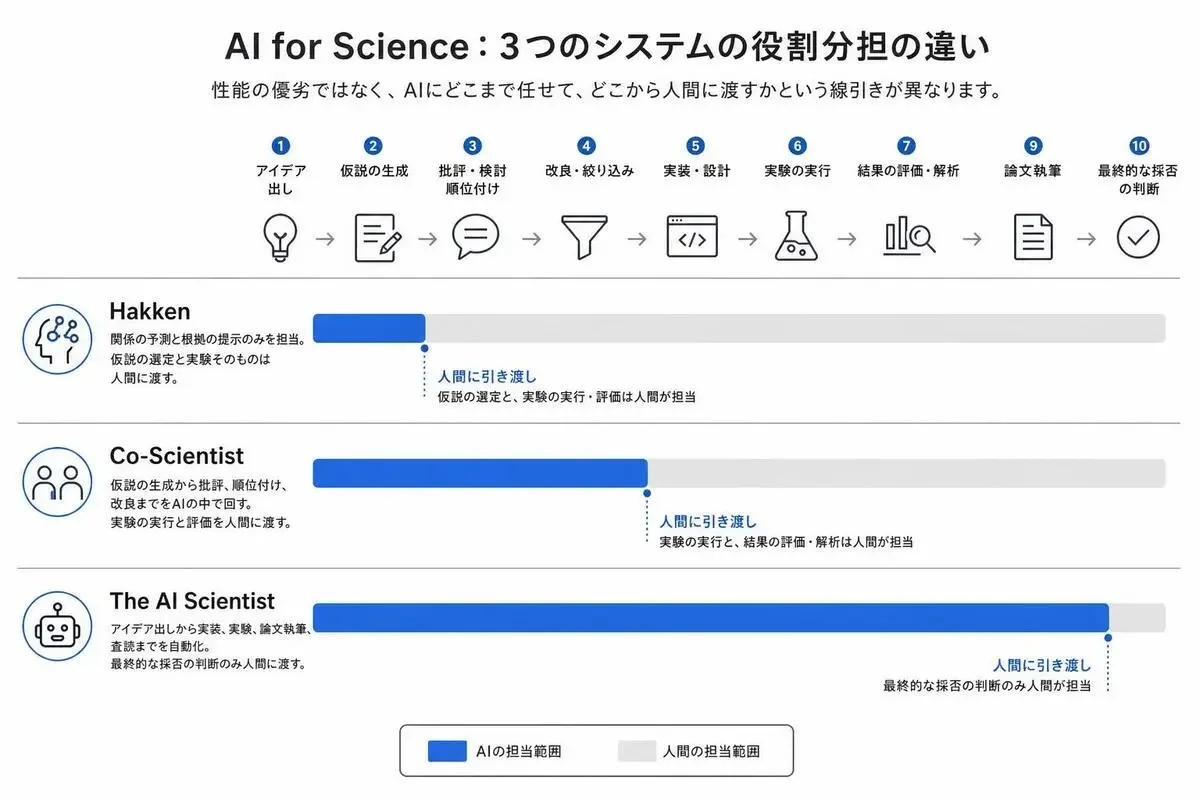
AI for Scienceの領域で先に名前が知られているのは、Google DeepMindのCo-ScientistとSakana AIのThe AI Scientistです。
3つを並べると、性能の優劣よりも「AIにどこまで任せて、どこから人間に渡すか」の線の引き方が違うことがはっきりします。
Co-ScientistはGeminiをベースにしたマルチエージェントで、仮説を出す役、近い研究を探す役、批評する役、順位を付ける役、改良する役が分かれています。
仮説の批評までAIの中で回してから人間に渡す設計で、Natureに論文が掲載され、研究者向けの実験的な機能としても提供が始まっています。
The AI Scientistはさらに広く、アイデア出しからコードの実装、実験の実行、論文の執筆、査読までを通しで自動化します。
v2が生成した論文は、AI分野の主要な国際会議のワークショップで査読を通過しました。
この並びで見ると、「Hakken」がAIに任せている範囲は最も狭いです。
狭いからこそ、人間の生物学者が選び、社外の実験室が確かめた2件という結果が、外から見て信用できる形で残っています。
なお、Co-ScientistとThe AI Scientistはすでに査読を通過した論文ですが、Hakkenの論文自体は今のところ査読前のarXivプレプリントです。
オープンソース版はGitHubにありますが、論文と同じ学習データではありません
HakkenOSSには、モデルの重みだけでなく、論文データの取り込みからNeo4jでの知識グラフ構築、埋め込みによる推論、仮説生成、React製のWeb UIまで通しで入っています。
埋め込みモデルはComplEx、DistMult、RotatE、GNNベースのものから選べます。
動かすのに必要なのはPython 3.10以上とuv、DockerとDocker Compose、Node.js 18以上、それから認証情報を設定済みのAWS CLIです。
ライセンスはコードがBSD 3-Clause、モデルパラメータがCC BY 4.0またはCDLA Permissive 2.0ですが、こちらは執筆時点でSony社内の承認待ちです。
もうひとつ、見落とすと期待外れになる点があります。
公開されている予測モデルが学習に使っているのは、NCBIのオープンアクセスなデータセットであるPubTator3だけです。
論文の主要な結果のほうは、PMC Open AccessとMEDLINE、それに商用ライセンスのデータセットを併せて使っています。
つまり落としてきても、論文の154万件は再現できません。
動かせるのは仕組みのほうで、結果ではありません。
AIが科学的な発見をしたと言われたときに私が見るのは、AIがどこで手を止めて、誰にバトンを渡したかです。
「Hakken」の場合、AI側の仕事は候補を154万件出すところまでで終わっています。
そこから3件に絞ったのは人間の目、確かめたのは社外の実験室でした。
数字の大きさよりも、この線の引き方のほうに価値があると思っています。
- 3
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 8
- 0
-
- 5
- 0
-
プロンプト画伯
- 10
- 0
-
 さくら
- 10
- 1
-
- 5
- 0
-
- 2
- 0
-
- 4
- 0
-
- 10
- 0
-
 ゆい@海外AI副業ラボ
- 7
- 0
-
ゆい@海外AI副業ラボ
- 11
- 0
-
- 4
- 1
-
- 3
- 0
-
- 1
- 0
-
- 2
- 0
-
 黒板とAI@直人
- 6
- 0
-
- 6
- 0
-
- 1
- 0
-
- 6
- 0
-
ゆい@海外AI副業ラボ
- 12
- 0
-
さくら
- 4
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます