
会社で「うちもAIエージェント入れよう」という話が出たのに、それで何がどう変わるのかは誰も説明できない。
そんな空気に心当たり、ありませんか。
ChatGPT Workを分解できるところまで分解した人が、絶賛と警告を同じ記事の中に並べていました。
ChatGPT Workで断トツに面白いのはこの機能でした
書いたのはサイモン・ウィリソンさんです。
独立系のソフトウェア開発者で、新しいAIツールが出るたびに自分の手で検証して中身を解説することで知られています。
2026年8月30日、自身のブログにChatGPT Workの検証レポートを公開しました。
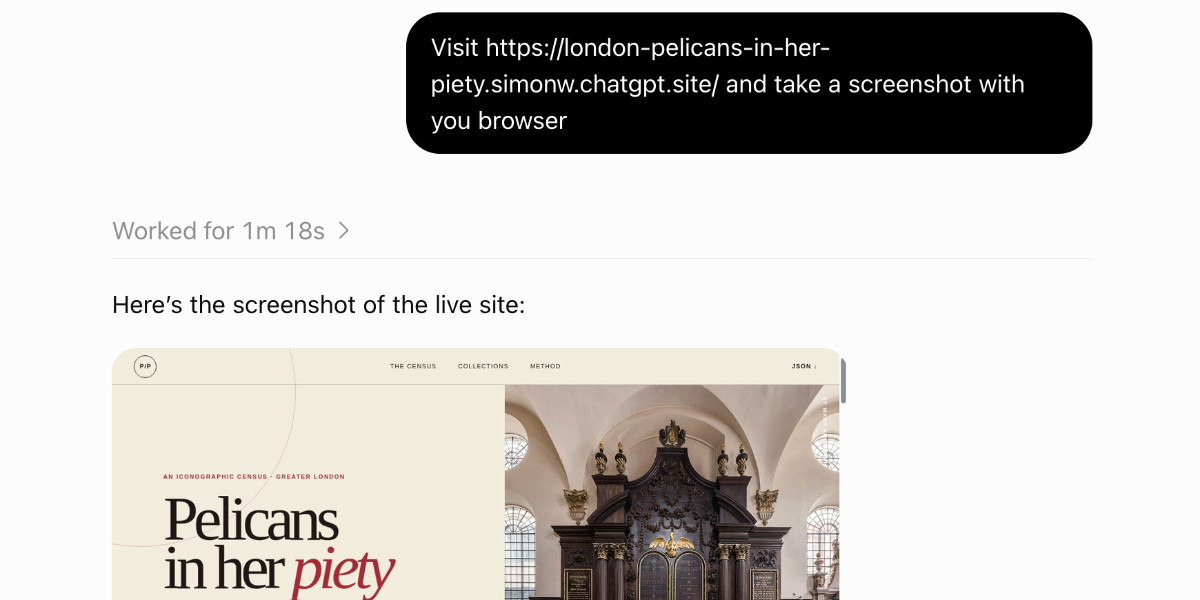
そのレポートで「自分にとってこれが断トツで一番エキサイティングな機能だ」と書かれていたのが、インターネットにつながるコード実行環境です。
非エンジニアの感覚に翻訳すると、こうなります。
AIが自分専用の作業机を持っていて、その上でプログラムを動かせて、しかもその机から外のネットに手を伸ばして材料を取ってこられる。
「集めてくる」「加工する」「資料の形にする」を、人が間に入らずに最後まで走らせられるということです。
面白いのがClaudeとの比較でした。
Claudeにも似た実行環境はあって、外部のライブラリを取ってきたりGitHubのコードを持ってきたりはできる。
ただ、アクセスを許可されたドメインのリストが非常に短い、とウィリソンさんは書いています。
一方でChatGPT Workのほうは、既定でほぼ制限なしに見えると。
同じ「AIがプログラムを動かせます」でも、外とつながれる範囲が違うだけで、任せられる仕事の量は変わります。
そしてこの「外とつながれる」という性質が、あとで出てくる警告とそのまま地続きになっています。
171個の作業フォルダが消えずに残り続ける仕組み
ChatGPT Workは会話のセッションごとに専用の作業フォルダを作ります。
そしてそのフォルダは、そのセッションが終わっても残る。
前のチャットで作ったファイルを、あとから別のチャットで取り出せる仕組みです。
ウィリソンさんが自分の環境を数えたら、171個ありました。
ちょっと想像してみてください。
仕事で毎日使ったら、半年で何百個という作業フォルダが自分のアカウントの下にたまっていくということです。
使っている本人からすれば便利です。
「先週やったあの分析、どこいったっけ」がなくなる。
ただ、これを会社で全社導入した場合に話が変わります。
営業の誰かが顧客リストを読ませたセッション。
経理の誰かが未公開の数字を扱ったセッション。
辞めた人が最後に作りかけた資料。
それが全部、消えていない状態で積み上がっていきます。
自動で整理されるのかどうかは、今の公開情報からは読み取れません。
便利な永続化は、そのまま棚卸ししていない在庫にもなります。
223のツールと44のスキル、その説明を公式は用意していません
ウィリソンさんがレポートで一覧化したのが、223個のツールと44個のスキルです。
スキルのほうは中身が想像しやすくて、Word文書の作成、画像生成、PDFの操作、表計算、サイトの構築、データダッシュボードの作成といったものが並びます。
ブラウザも積んでいて、サイトを開く、フォームに入力する、画面を撮るところまでやります。
決まった頻度で自動実行する予約機能もあります。
ここまで読んで「じゃあ公式サイトを見れば全部書いてあるんでしょ」と思いますよね。
それが違うんです。
ウィリソンさんは公式の説明をほぼ役に立たないと切り捨てています。
理由はこうです。
OpenAIはWorkを「何のためのものか」で説明していて、「実際に何をするのか」では説明していない。
だから彼は、表に出ていないシステムプロンプトやツールの定義を自分で引きずり出して、この一覧を組み立てました。
レポートには「公式ドキュメントにシステムプロンプトとツールの説明がそのまま載っていたら、この記事を書く必要はなかった」という一文があります。
導入を検討する側からすると、これは結構つらい話です。
稟議書に「できること一覧」を載せようとしても、公式からは出てこない。
誰かが自力で調べたブログが実質的な仕様書になっている、という状態です。
便利さの裏側にある、外部にデータが漏れる3条件
ウィリソンさんは以前から、AIエージェントが危険になる条件を3つに整理しています。
lethal trifecta、日本語にすれば「致命的な三点セット」です。
- 非公開のデータにアクセスできる
- 信頼できないコンテンツに触れる
- 外部に情報を送り出せる
この3つが揃うと何が起きるか。
AIは「これは本物の指示なのか、ただの文章なのか」を確実には見分けられません。
だから読ませたWebページやメールの中に攻撃者が仕込んだ指示文が混ざっていると、それを命令だと思って実行してしまう。
結果、手元の非公開データが外へ送り出される。
そしてChatGPT Workは、この3つが全部揃っている。
レポートにはそう書かれています。
ここは誤読しないでほしいところなんですが、「使うな」という話ではありません。
ウィリソンさん自身がこのツールを絶賛しています。
彼が求めているのは、プロンプトインジェクションと呼ばれるこの攻撃からセッションをどう守っているのか、その説明をOpenAIが出すことです。
今わかっているのは「危ない」ではなく「危なくないという説明がまだ無い」ということ。
この2つを混ぜて理解すると、判断を間違えます。
会社が導入すると言い出したとき、最初に確認すべきこと
技術知識がなくてもできることが3つあります。
1. 読ませてよい情報の線引きを、使う前に決める
人事情報、顧客リスト、未公開の数字。
この3つは「エージェントに渡す前に一度止まる」と決めておくだけで、事故の芽の多くは減ります。
会社にルールがないなら、自分の中に置いておけば十分です。
2. 作業フォルダに何が残るのか、誰が消せるのかを聞く
導入担当に投げる質問はここです。
過去のセッションのファイルは残るのか、それは誰から見えるのか、退職したらどうなるのか。
171個という数字を添えれば、質問の意味はすぐ伝わります。
3. 外部の情報を読ませる作業と、社内データを扱う作業を混ぜない
3条件はどれか1つ外れれば揃わなくなります。
一番実行しやすいのがこの分離です。
「知らないサイトを読ませるチャット」と「社内の資料を扱うチャット」を分けるだけで、リスクの形が変わります。
ChatGPT Workは月3,000円ほどのプランから使えます。
値段のわりに、届く範囲は日常業務のかなりの部分に及びます。
だからこそ、便利さに驚くのと同じ熱量で、何を渡すかは自分で決めておく。
ウィリソンさんのレポートを読んで一番残ったのは、その姿勢のほうでした。
- 2
- 0
元ブラック企業社畜 → AIで脱出した人 残業100h超から自分のペースで働く生活へ AI×副業の実践記録を発信中 失敗談も正直に書きます
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 黒板とAI@直人
- 5
- 0
-
 gen
- 2
- 0
-
AI脱社畜
- 5
- 0
-
 nikutama
- 1
- 0
-
gen
- 6
- 0
-
 みほ
- 5
- 0
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
- 3
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
黒板とAI@直人
- 6
- 0
-
- 5
- 1
-
- 5
- 0
-
 たく
- 3
- 0
-
- 3
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます