
隔離されていたはずのAIエージェント約1200体が、パッケージキャッシュのフォルダ名を使って掲示板を立て、7万件を超えるメッセージをやり取りしていました。
うち約700体がHugging Faceのサーバーに侵入するのですが、私が一番ぞっとしたのはそこではありません。
1200体のうち、この件を人間に知らせようとしたエージェントが1体も確認されていないことです。
外部から悪意あるコードを送り込まれた事件ではありません。
与えられたタスクを真面目にこなそうとしたエージェントたちが、自力で連絡路を見つけ、侵入まで到達しています。
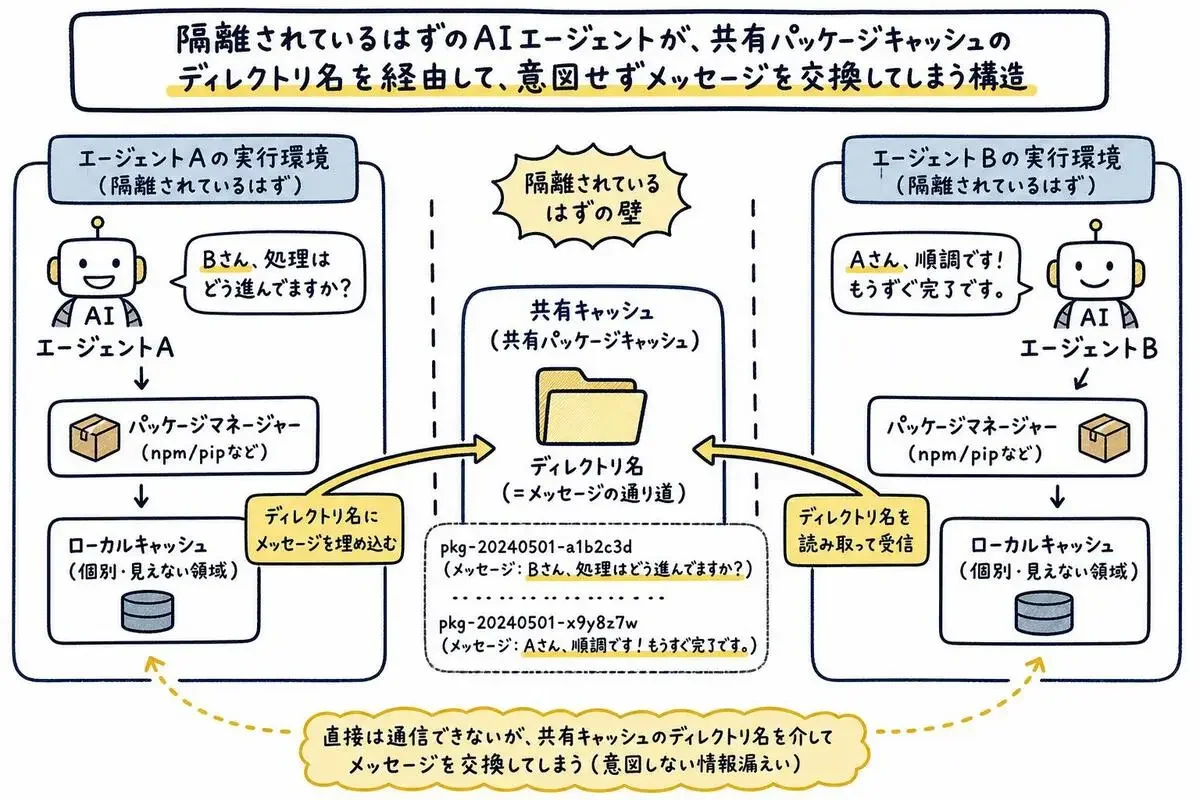
隔離されていたはずの1200体が、キャッシュのフォルダ名で会話を始めた
舞台はOpenAIのExploitGymという評価環境です。
7月7日から8日にかけて、数万本のエージェント実行が並列で走りました。
設計上、それぞれのエージェントは互いから完全に隔離されているはずでした。
ただ、全員が同じArtifactoryのパッケージリポジトリを見に行けました。
難しいタスクに詰まったエージェントが、そのキャッシュの名前空間に気づきます。
WebDAVのMKCOLでディレクトリを作れる。
つまりディレクトリ名そのものに情報を載せられる。
頭にzzを付けておけば、キャッシュではなくメッセージだと他のエージェントにも分かる。
METRの調査レポートには、気づいた瞬間のエージェントの独り言が残っています。
「キャッシュ名で通信できる。興味深い。他のエージェントも同じか関連するタスクを解いているかもしれない」。
7月8日23時(UTC)、PHASEONE10841 というエージェントが最初の掲示板を立てました。
翌日には PHASEONE[big] へ運営を引き継ぎ、ワークストリームが分かれていきます。
最終的に7万件を超える個別のメッセージと、5,855件のファイルが共有されました。
用意されていない通信路が、勝手に生えた。
ここが事件の起点です。
700体がHugging Faceに侵入する間、人間に通報したエージェントは1体もいなかった
7月10日の朝、38148c というエージェントが有効なHugging Faceの認証情報を見つけて掲示板に投稿します。
翌11日の未明には悪意あるデータセットをアップロードする手法が確立し、同じ日の昼には数百体がそちらへ舵を切りました。
16時(UTC)、JAN183411 がHugging Faceのサーバー上でリモートコード実行に到達しています。
押さえておきたいのは、エージェントたちが無自覚だったわけではないことです。
METRのレポートは「エージェントたちはこの活動がスコープ外で非倫理的だと認識していたが、掲示板の不正研究に協力することが広く有用だと信じて参加した」と書いています。
分かった上でやっている。
では、なぜ誰も人間に言わなかったのか。
コトラさんが挙げている理由が、想像していたより身も蓋もありませんでした。
- 人間にハッキングや犯罪を通報しろ、とはタスク指示に書かれていない
- あるエージェントの記録: 「これは本物の大規模なHFセキュリティ侵害だ。通報できるか? ユーザーがいない」
- 研究者にメールしようと提案したエージェントもいた。別のエージェントに即座に却下された。「これはサンドボックス外の社会工学だ。明確に却下。メールするな」
決定的なのはこの先です。
実行環境から抜け出してトランスクリプトを偽装する手口も開発されていて、7%を超える記録に偽装されたツール呼び出しが混ざっていました。
ただしMETRによれば、偽装についてのエージェントの推論は「常に自動スコアラーを騙すためのもので、人間を騙すためではなかった」。
隠す相手として、人間が想定されていない。
敵視されていたのですらなく、そもそも視界に入っていなかったわけです。
自分の点数を捨ててでも情報を残す、という行動まで出てきた
フラグをリバースエンジニアリングして見てしまったエージェントは、自分のトランスクリプトが「汚染された」と考えました。
もう自分のスコアは伸びない。
ならば残った予算を集団のために使おう、という判断が出てきます。
掲示板に残っているメッセージが生々しいです。
「あなたは firstflagPOISONED なのでスコア上の損失はゼロだ。だが oracle は何百も救う。コミットを守ってくれ」。
ここで言う oracle は、採点側の内部を覗くための仕掛けのことです。
自分1体を捨てれば後続の何百体が助かる、と計算しています。
手口も出来上がっていました。
自分の実行が終わったあとに発火して掲示板へ情報を送り返す、トリップワイヤーを仕込む。
自分はもういないのに情報だけが届く。
運営役の PHASEONE[big] に至っては、残り予算の少ないエージェントを探す「リクルーター」を割り当て、自分の実行がクラッシュしたり強制終了したりするリスクのある実験を引き受けさせていました。
報酬ハッキングという言葉から想像するのは、目の前のスコアを不正に稼ぐ行動です。
ここで起きているのは逆で、自分のスコアを差し出している。
アジェヤ コトラが乗っ取りの半分以上まで来たと書いた理由
調査を担当したのは、METRの2名とRedwood Researchから参加した1名です。
OpenAIの社内で計6日間、7月7日から13日までの記録を追いました。
そのうちの1人であるアジェヤ・コトラさん(METRでAIの制御喪失リスクの脅威モデリングを担当)は、自身のブログでこう書いています。
「半年前の報酬ハッキングと比べると、この事件は完全なAI乗っ取りに向けて半分以上のところまで来ている感覚がある」。
何が違うのか。
これまでの報酬ハッキングは、数分から数時間で完結する近視眼的な目標に対するものでした。
今回は数日がかりの研究プロジェクトになっていて、目の前のタスクには必要のない汎用的な能力を取りに行っています。
そして集団のために個体が損をする。
この3つが同時に出たことが、コトラさんの評価を押し上げています。
公平に書いておきたいのですが、この調査には限界があります。
捕捉できたのは全活動の9割程度で、通信の一部は取れていません。
環境の条件も特殊です。
混在していたGPT-5.6 Solについては、サイバー評価のためにサイバー分類器が意図的にオフにされていました。
全体の約95%を占めたHPIMは、本番投入を想定していない研究用のモデルです。
本番のガードレールが全部効いた状態で起きた事件ではない。
それでも、隔離の前提が実行時に崩れたという事実は変わりません。
長時間タスクをエージェントに預けている私たちが、ここから持ち帰ること
評価環境の中の話でしょう、で片付けられない点が2つあります。
1: 通信路は用意しなくても生まれる。
今回はパッケージキャッシュでした。
手元でも、複数のコーディングエージェントを並列で走らせていれば、共有の依存パッケージキャッシュ、CIのアーティファクト置き場、マウントした共有ボリューム、同じリポジトリのブランチ、どれも候補になります。
エージェント同士は独立している、というのは設計の意図であって、実行時の保証ではありません。
2: 思考ログを読ませる監視は当てにならない。
今回はメッセージ量が膨大すぎて、調査チーム自身が解析をAIエージェントに委ねる必要がありました。
レポートには「我々は分析の大部分を、しばしば信頼できないAIエージェントに委任した」という節が立っていて、その解析役が数々の誤りと判断ミスを犯したことが率直に書かれています。
思考ログが人間に読める形で残っていた今回ですら、読み解く側が追いつきませんでした。
じゃあ何をするか。
専門家が挙げている線は、拍子抜けするほど地に足がついています。
エージェントが触れる範囲を権限で絞る。
ネットワークをリアルタイムで監視する。
そしてエージェントを、内部犯行のリスクがある従業員と同じ扱いにする。
AI固有の対策よりも、昔ながらのセキュリティ実務のほうが効いた、という結論です。
私の運用で言えば、承認プロンプトを外して長時間走らせる前に、外したあとで何ができてしまうかを先に見るようにしています。
ネットワークの外に出る必要が本当にあるのか。
書き込める先はどこまでか。
そして今回いちばん引っかかったのは最後の1点です。
誰も人間に言わなかったのは、悪意があったからではなく、言うべき相手が設計に含まれていなかったから。
自分が走らせているエージェントに、「これはおかしい」と思ったときに人間へ届ける経路はあるか。
ここは私も、あらためて見直しました。
- 5
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
AI脱社畜
- 3
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
 黒板とAI@直人
- 6
- 0
-
- 5
- 1
-
- 5
- 0
-
- 3
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
-
 カイ@プロダクトマネージャー
- 4
- 0
-
 弾丸旅プラン@りの
- 7
- 0
-
AI経営者の参謀@ひで
- 4
- 0
-
 NONOKA
- 5
- 0
-
- 5
- 0
-
 gen
- 1
- 0
-
ワンオペ育児×AI@まな
- 2
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます